



Comment nous décrivons un workflow en langage courant pour en obtenir un qui fonctionne. Découvrez comment nous avons construit sur n8n, sans éditeur de workflows et sans modèles.
Les workflows construits dans n8n encodent des interactions complexes en plusieurs étapes pour accomplir des tâches sur plusieurs systèmes. Nous explorons des moyens de décrire un workflow en langage courant et d'en obtenir un qui fonctionne, afin de simplifier radicalement le processus tout en continuant à utiliser n8n comme un puissant orchestrateur.
Faire tourner n8n en mode headless
Avec un éditeur et un chat comme seules interfaces, tout le reste peut se trouver derrière.
Un projet n8n par tenant
Isoler les tenants les uns des autres est essentiel. Après en avoir discuté avec l'équipe n8n, nous avons décidé de séparer les données projet par projet. Les workflows, les credentials et les exécutions de chaque tenant vivent dans leur propre projet n8n, et n8n fait respecter cette frontière pour nous. Nous n'avons pas eu à construire notre propre couche d'isolation par-dessus.
Shards chauds et froids
Nous pouvons créer des workflows qui tournent à n'importe quel volume, nous avons donc dû prévoir les voisins bruyants. Un seul tenant peut mettre en file des dizaines ou des centaines de milliers d'exécutions, et nous ne voulions pas que tous les autres attendent derrière eux dans la même file.
Pour y remédier, nous avons divisé notre infrastructure en « shards » selon la température. Chaque shard dispose d'un nœud principal n8n, de nœuds workers, de Redis et de Postgres, en mode file d'attente. Les nœuds chauds prennent en charge les exécutions immédiates et critiques. Les nœuds froids traitent le travail en masse et en arrière-plan. Au sein d'un shard, les nœuds chauds et froids partagent la base Postgres de ce shard, qui contient les métadonnées des workflows.
Credentials
Les clients doivent connecter leurs workflows à des services externes, et d'autres parties de notre produit avaient aussi besoin d'accéder à ces credentials tiers. Nous nous sommes donc placés devant n8n.
Webflow peut exploiter l'application OAuth, conserve les tokens et gère la rotation. Le credential canonique se trouve alors chiffré dans un service Secret Store. n8n reçoit un miroir de ce credential, qu'il utilise pendant l'exécution des workflows. Un binding associe une connexion Webflow à un credential n8n, par projet et par shard. Quand un token approche de son expiration, une tâche planifiée le fait tourner, écrit le nouveau token dans Secret Store et met à jour chaque credential n8n lié à cette connexion.
Déclencheurs
Comme n8n tourne en mode headless, il serait possible de démarrer un workflow sans cliquer sur un bouton dans l'interface n8n. À la place, chaque workflow démarre à partir d'un nœud webhook. Nous enregistrons le webhook au chemin de déclenchement résolu. Lorsqu'un événement déclencheur survient, comme l'envoi d'un formulaire ou la publication d'un item de collection CMS, le monolithe Webflow envoie une requête POST à ce webhook. Les workflows planifiés fonctionnent de la même façon : une tâche cron dans Webflow vérifie lesquels sont dus et envoie le POST.
L'architecture
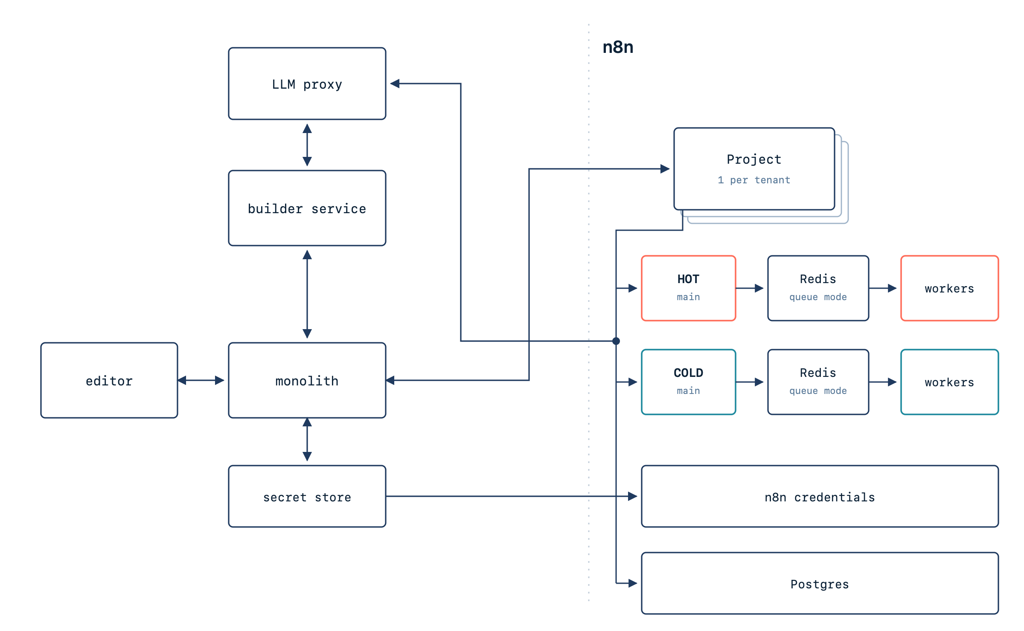
Quelques éléments clés à souligner :
- Le monolithe Webflow sert l'API pour les brouillons, les versions, les exécutions et les permissions.
- Le service builder transforme un prompt en JSON de workflow n8n.
- Le proxy LLM gère chaque appel de modèle pendant l'exécution. Nous l'utilisons pour déduire des tokens des budgets des clients.
- n8n orchestre les workflows, sur des shards que nous exploitons nous-mêmes.
Le service builder est un petit service HTTP sans état, qui vit en dehors du monolithe. Il n'a pas de base de données propre et tourne dans le même réseau que les shards n8n. Il comporte quatre routes : build, plan, import et health.
Du prompt au workflow
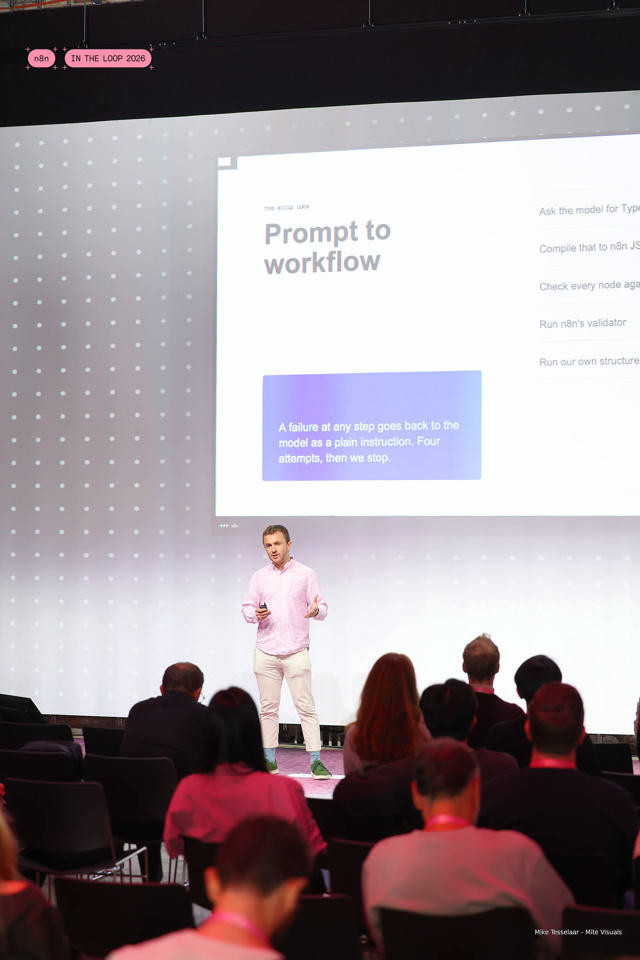
Voici ce qui se passe quand le builder reçoit un prompt :
- Demander au modèle du TypeScript écrit pour le SDK de workflow n8n.
- Compiler ce TypeScript en JSON n8n.
- Vérifier chaque nœud par rapport à notre allowlist.
- Exécuter le validateur de n8n fondé sur leur SDK.
- Exécuter nos propres contrôles structurels.
Un échec à n'importe quelle étape revient au modèle sous forme d'instruction simple, et il réessaie, jusqu'à quatre tentatives au total.
La compilation n'exécute pas le code du modèle. Le SDK parcourt l'arbre syntaxique TypeScript avec un interpréteur qui n'autorise que les appels au SDK et bloque les globaux tels que eval, require, process et fetch.
Pourquoi du TypeScript plutôt que du JSON ?
Nous avons d'abord demandé au modèle du JSON brut. Quand on demande à un modèle de gros blocs de JSON de workflow, on obtient quelque chose de subtilement faux : un paramètre inventé qui a l'air juste, un type de nœud qui n'existe pas, ou une structure de connexion d'une ancienne version de n8n. Tout cela passe une lecture rapide, mais le workflow échoue à l'exécution.
Écrit pour le SDK, le modèle ne peut pas se tromper sur la structure des connexions, car c'est le SDK qui les construit. Une erreur de syntaxe ou d'API échoue avec une erreur numérotée par ligne que la boucle de nouvelle tentative renvoie, et les types de nœuds inexistants sont interceptés par notre allowlist. Les LLM sont bons pour écrire du code. Passer de la génération de JSON à la génération de code pour le SDK a déplacé ces échecs de l'exécution vers la phase de build, où la boucle de nouvelle tentative peut les corriger.
Par exemple, ici le modèle enchaîne un .then() que le SDK n'a pas :
Le build échoue avant que quoi que ce soit n'atteigne n8n, et cette erreur est renvoyée au modèle :
L'allowlist
n8n est livré avec plus d'un millier de nœuds. Nous en prenons en charge moins de 20, volontairement. Comme nous nous plaçons devant n8n pour les intégrations, nous devons nous assurer que le builder ne génère pas, par exemple, un nœud Slack si nous ne prenons pas en charge Slack.
Nous tenons donc une liste de nœuds autorisés. Chaque entrée fige une version et inclut un exemple de paramètres éprouvé, et nous utilisons la liste comme l'une des étapes de validation.
Ce qui a été plus difficile que prévu
Synchroniser l'état des workflows
Nous voulions afficher une vue en direct d'un workflow pendant son exécution. Pour cela, nous nous abonnons aux événements du flux de logs de n8n et les synchronisons avec le client via un websocket.
Cela a bien fonctionné jusqu'à ce que nous rencontrions des workflows de longue durée. Certains se perdaient : lorsqu'un worker manquait de mémoire ou redémarrait pendant un déploiement, la file de n8n faisait échouer le job sans émettre d'événement de flux de logs, et notre interface l'affichait donc comme étant en cours pour toujours. La solution a été d'ajouter du polling pour ce type de jobs, avec de la télémétrie sur leur état.
Modifications
Une fois que l'agent a généré un workflow, le client doit décider s'il est correct. Nous ne demanderons à personne de repérer ce qui ne va pas dans le JSON.
À la place, les modifications reconstruisent tout le workflow. Nous transmettons le retour du client au service builder avec le workflow actuel et demandons le tout en retour. Cela se répète jusqu'à ce que le client nous dise que c'est bon.
Reconstruire a un coût : le modèle peut supprimer ou modifier une étape que le client n'a jamais mentionnée. Nous donnons donc au builder le workflow actuel complet, y compris les étapes désactivées et les paramètres comme les timeouts, et nos evals de modification échouent si une étape que la demande ne mentionnait pas disparaît.
Les gens oublient des choses
Le langage naturel est difficile. « Envoie-moi un résumé » en est un exemple classique : un résumé de quoi ? Envoyé où ? À quelle fréquence ?
Pour y répondre, le builder exécute d'abord une étape de planification. Il décide s'il a assez d'éléments pour construire ou s'il doit poser une question. Il pose une question à la fois et, dès que le déclencheur et l'action principale sont clairs, il construit.
Evals
Au début, notre sentiment de qualité venait de quelqu'un qui essayait un prompt et se faisait une impression. Cela ne passe pas à l'échelle. Si vous changez le prompt, le modèle ou l'allowlist, rien ne vous dit ce qui s'est passé.
Nous avons donc écrit 20 evals fondés sur des demandes clients représentatives, chacun avec un résultat attendu écrit, et les avons répartis en trois niveaux :
- Niveau 0 : A-t-il été construit, et à quelle tentative ?
- Niveau 1 : S'exécute-t-il réellement sur un site sandbox avec des données de test ?
- Niveau 2 : A-t-il fait ce qui était demandé ? Un modèle lit le prompt et note le graphe de workflow obtenu.
Notre seuil est de 70 % de réussite dès la première tentative.
Tests de charge
Webflow héberge des sites pour environ 1 % d'internet ; nous voulions donc savoir comment n8n tiendrait avant que des clients ne s'y appuient.
Nous avons monté un nœud principal n8n et quatre workers dans un environnement de staging isolé et mené plusieurs séries de tests. L'un de nos préférés était un workflow que nous avons appelé le « marteau de Fibonacci ». Il exécutait un calcul de Fibonacci très gourmand en CPU avec presque aucune I/O, pour mettre le matériel sous la plus forte contrainte possible.
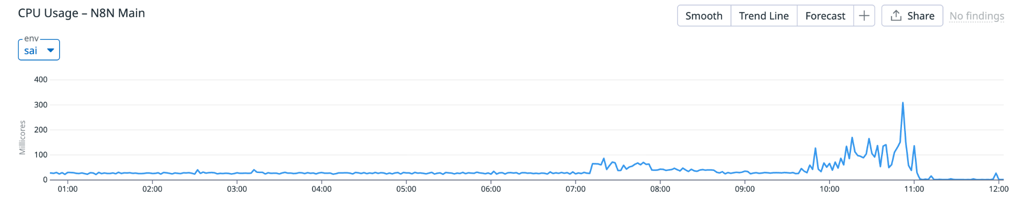
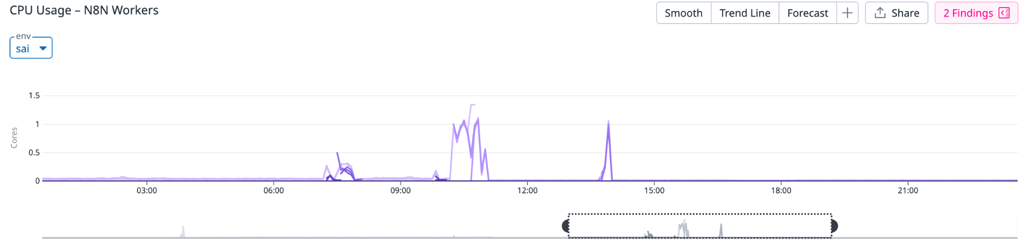
Nous sommes passés de deux exécutions par seconde à 550 et avons lancé environ 300 000 exécutions en à peu près une heure. Voici ce que nous avons observé :
- Le nœud principal est resté stable jusqu'à environ 500 exécutions par seconde. Au-delà, il est tombé et s'est rétabli de lui-même environ une minute plus tard.
- Chaque worker a saturé un cœur de CPU sans rester au maximum en permanence.
- L'autoscaling a porté le pool de workers à son plafond de quatre.
- Redis et Postgres ont tenu tout du long.
Nous avons aussi constaté qu'il nous manquait certaines métriques, et avons donc ajouté de la télémétrie CPU et une métrique de profondeur de file Redis. En bref, n8n en mode file d'attente a géré jusqu'à environ 500 exécutions par seconde. Nous avons choisi un test limité par le CPU parce qu'il sollicite le plus les workers. Les vrais workflows attendent surtout des I/O ; ils chargent donc moins un worker.
Ce que nous avons appris
Quelques enseignements que nous transmettrions à toute personne qui construit quelque chose de similaire :
- Traitez le JSON de workflow comme une cible de compilation et donnez à votre générateur une surface typée.
- Les projets n8n fonctionnent bien pour la multi-tenance.
- On peut beaucoup demander aux workers n8n en mode file d'attente.
- Synchroniser l'état des workflows entre plusieurs systèmes est difficile. Prévoyez tôt les événements manqués : utilisez le polling en filet de sécurité du flux d'événements et alertez sur les exécutions qui restent trop longtemps à l'état « en cours ».
Nous avons présenté ce travail pour la première fois à la conférence In the Loop de n8n, à Berlin.