



Cómo usamos un lenguaje sencillo para describir un flujo de trabajo y obtener uno funcional a cambio. Descubre cómo lo construimos sobre n8n, sin editor de flujos ni plantillas.
Los flujos de trabajo en n8n integran interacciones complejas de varios pasos para conectar diferentes sistemas. Estamos explorando formas de usar lenguaje sencillo para describir un flujo y obtener uno funcional a cambio, simplificando drásticamente el proceso sin dejar de aprovechar la potencia de n8n como orquestador.
Ejecución de n8n sin interfaz (headless)
Con un editor y un chat como única interfaz, todo lo demás puede quedar en un segundo plano.
Un proyecto de n8n por cliente
Aislar a los inquilinos entre sí es fundamental. Tras hablar con el equipo de n8n, decidimos separar los datos por proyecto. Los flujos de trabajo, las credenciales y las ejecuciones de cada inquilino viven dentro de su propio proyecto de n8n, y n8n se encarga de reforzar ese límite por nosotros. Así nos ahorramos tener que construir nuestra propia capa de aislamiento desde cero.
Fragmentos (shards) activos y pasivos
Podemos crear flujos de trabajo que funcionan a cualquier volumen, así que tuvimos que prepararnos para los vecinos ruidosos. Un solo cliente puede poner en cola decenas o cientos de miles de ejecuciones, y no queríamos que los demás tuvieran que esperar detrás de ellos en la misma fila.
Para gestionar esto, dividimos nuestra infraestructura en "fragmentos" basados en la temperatura. Cada fragmento tiene un nodo principal de n8n, nodos de trabajo, Redis y Postgres, ejecutándose en modo cola. Los nodos activos (hot) se encargan de las ejecuciones críticas e inmediatas. Los nodos pasivos (cold) se encargan del trabajo masivo y en segundo plano. Dentro de un fragmento, los nodos activos y pasivos comparten la base de datos Postgres de ese fragmento, que contiene los metadatos del flujo de trabajo.
Credenciales
Existe la necesidad de conectar sus flujos de trabajo con servicios externos, y otras partes de nuestro producto también requerían acceso a esas credenciales de terceros. Así que nos pusimos delante de n8n.
Webflow puede ejecutar la aplicación OAuth, almacena los tokens y se encarga de su rotación. La credencial canónica se guarda cifrada en un servicio de almacenamiento de secretos. n8n obtiene un duplicado de esa credencial, que utiliza durante la ejecución de los flujos de trabajo. Un enlace conecta una integración de Webflow con una credencial de n8n, por proyecto y fragmento. Cuando un token está a punto de caducar, una tarea programada lo renueva, escribe el nuevo token en el almacén de secretos y actualiza todas las credenciales de n8n vinculadas a esa conexión.
Desencadenadores
Como n8n funciona sin interfaz gráfica, es posible iniciar un flujo de trabajo sin tener que hacer clic en ningún botón de la interfaz de usuario de n8n. En su lugar, cada flujo de trabajo comienza desde un nodo de webhook. Registramos el webhook en la ruta de activación resuelta. Cuando se dispara un evento, como el envío de un formulario o la publicación de un elemento de una colección del CMS, el monolito de Webflow envía una solicitud POST a ese webhook. Los flujos de trabajo programados funcionan igual: un trabajo cron en Webflow comprueba cuáles deben ejecutarse y envía el POST.
La arquitectura
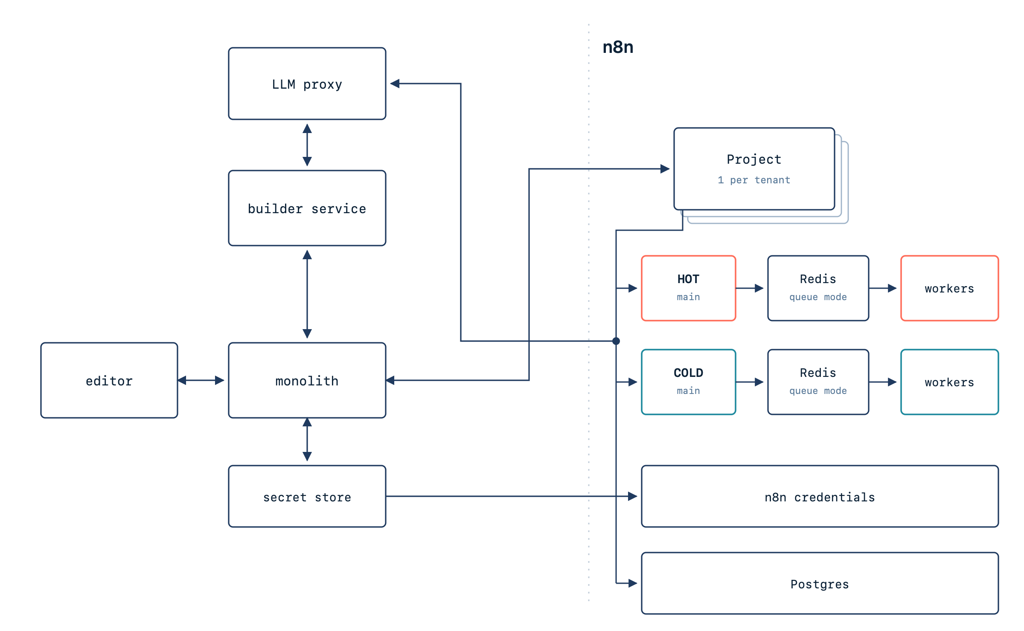
Algunas piezas clave a destacar:
- El monolito de Webflow gestiona la API para borradores, versiones, ejecuciones y permisos.
- El servicio del constructor convierte un prompt en el JSON de un flujo de trabajo de n8n.
- El proxy de LLM se encarga de cada llamada a los modelos durante la ejecución. Lo usamos para descontar tokens del presupuesto de los clientes.
- n8n orquesta los flujos de trabajo en fragmentos que operamos nosotros mismos.
El servicio de construcción es un servicio HTTP pequeño y sin estado que opera fuera del monolito. No tiene base de datos propia y se ejecuta en la misma red que los fragmentos de n8n. Cuenta con cuatro rutas: build, plan, import y health.
De la instrucción al flujo de trabajo
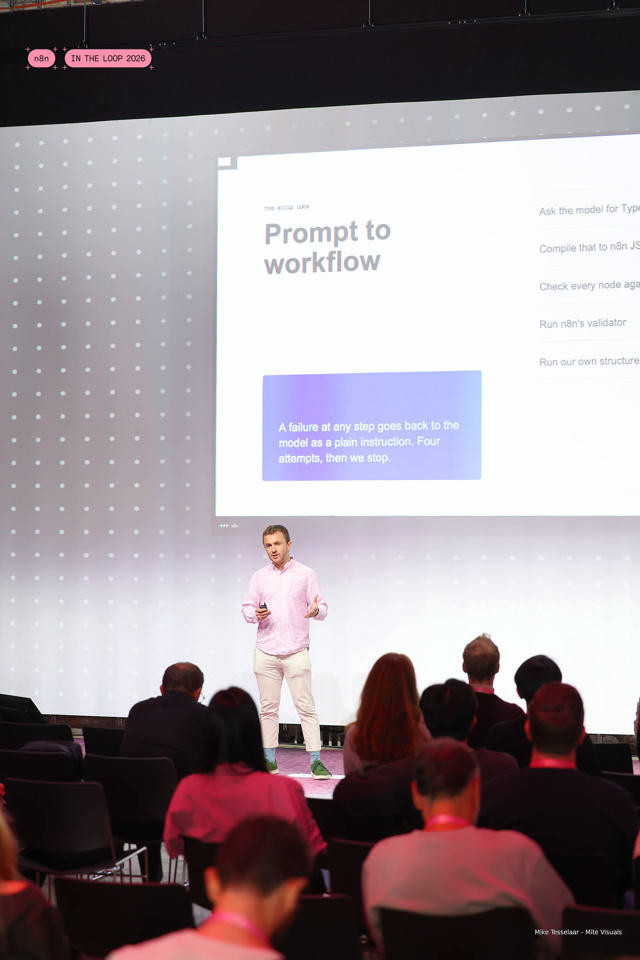
Esto es lo que sucede cuando el constructor recibe una instrucción:
- Solicitar al modelo código TypeScript escrito para el SDK de flujos de trabajo de n8n.
- Compilar ese TypeScript a JSON de n8n.
- Verificar cada nodo contra nuestra lista de permitidos.
- Ejecutar el validador de n8n basado en su SDK.
- Ejecutar nuestras propias comprobaciones estructurales.
Si algún paso falla, se devuelve la información al modelo como una instrucción sencilla y este vuelve a intentarlo, hasta un máximo de cuatro veces.
La compilación no ejecuta el código del modelo. El SDK recorre el árbol de sintaxis de TypeScript con un intérprete que solo permite llamadas al SDK y bloquea funciones globales como eval, require, process y fetch.
¿Por qué TypeScript en lugar de JSON?
Empezamos pidiendo al modelo JSON sin procesar. Cuando le pides a un modelo grandes bloques de JSON para flujos de trabajo, obtienes resultados con errores sutiles: un parámetro inventado que parece correcto, un tipo de nodo que no existe o una estructura de conexión de una versión antigua de n8n. Todo esto parece estar bien a simple vista, pero el flujo de trabajo falla al intentar ejecutarlo.
Al escribir código para el SDK, el modelo no puede equivocarse con la estructura de la conexión, porque es el SDK quien construye las conexiones. Un error de sintaxis o de API genera un error con número de línea que el bucle de reintento devuelve, y los tipos de nodo inexistentes son detectados por nuestra lista de permitidos. Los LLM son buenos escribiendo código. Cambiar de generar JSON a generar código para el SDK trasladó esos fallos del tiempo de ejecución al tiempo de construcción, donde el bucle de reintento puede corregirlos.
Por ejemplo, aquí el modelo encadena un .then() que el SDK no tiene:
const form = trigger({ type: 'n8n-nodes-base.webhook', version: 2, config: { name: 'Form submitted' } });
const crm = node({ type: 'n8n-nodes-base.httpRequest', version: 4.2, config: { name: 'POST to CRM' } });
export default workflow('form-to-crm', 'Form to CRM').add(form).then(crm);
La construcción falla antes de que nada llegue a n8n, y este error se devuelve al modelo:
Failed to parse workflow code: Method 'then' is not an allowed SDK method. Allowed methods: add, to, input, output, onError, onTrue, onFalse, onCase, onEachBatch, onDone, connect.

  1 | const form = trigger({ type: 'n8n-nodes-base.webhook', version: 2, config: { name: 'Form submitted' } });
  2 | const crm = node({ type: 'n8n-nodes-base.httpRequest', version: 4.2, config: { name: 'POST to CRM' } });
> 3 | export default workflow('form-to-crm', 'Form to CRM').add(form).then(crm);
    |                                                                 ^
La lista de permitidos
n8n incluye más de mil nodos. Nosotros admitimos menos de 20, a propósito. Como nos situamos delante de n8n para las integraciones, debemos asegurarnos de que el constructor no genere, por ejemplo, un nodo de Slack si no admitimos Slack.
Así que mantenemos una lista de nodos permitidos. Cada entrada fija una versión e incluye un ejemplo de parámetros que sabemos que funciona, y usamos esta lista como uno de los pasos de validación.
Cosas que fueron más difíciles de lo esperado
Sincronización del estado del flujo de trabajo
Queríamos mostrar una vista en tiempo real de un flujo de trabajo mientras se ejecuta. Para lograrlo, nos suscribimos a los eventos del flujo de registros de n8n y los sincronizamos con el cliente a través de un websocket.
Esto funcionó bien hasta que nos topamos con flujos de trabajo de larga duración. Algunos se perdían: cuando un trabajador se quedaba sin memoria o se reiniciaba durante un despliegue, la cola de n8n fallaba en la tarea sin emitir un evento de registro, por lo que nuestra interfaz la mostraba como si estuviera ejecutándose para siempre. La solución fue añadir un sondeo para este tipo de tareas, junto con telemetría sobre su estado.
Ediciones
Una vez que el agente genera un flujo de trabajo, el cliente debe decidir si es correcto. No vamos a pedirle a nadie que señale qué está mal en el JSON.
En su lugar, las ediciones reconstruyen todo el flujo de trabajo. Enviamos los comentarios del cliente al servicio de construcción junto con el flujo de trabajo actual y pedimos que nos devuelva el resultado completo. Esto se repite hasta que el cliente nos dice que está bien.
La reconstrucción tiene un coste: el modelo puede eliminar o cambiar un paso que el cliente nunca mencionó. Por eso le damos al constructor el flujo de trabajo completo, incluyendo los pasos desactivados y ajustes como los tiempos de espera, y nuestras evaluaciones de edición fallan si desaparece un paso que no se mencionó en la solicitud.
La gente se deja cosas en el tintero
El lenguaje natural es complicado. "Envíame un resumen" es un ejemplo clásico: ¿un resumen de qué? ¿Enviado a dónde? ¿Con qué frecuencia?
Para manejar esto, el constructor ejecuta primero un paso de planificación. Decide si tiene suficiente información para construir o si necesita hacer una pregunta. Hace una pregunta a la vez y, una vez que el disparador y la acción principal están claros, construye.
Evaluaciones
Al principio, nuestra percepción de la calidad venía de alguien que probaba un prompt y se formaba una impresión. Eso no es escalable. Si cambias el prompt, el modelo o la lista de permitidos, nada te dice qué ha pasado.
Así que escribimos 20 evaluaciones basadas en solicitudes representativas de clientes, cada una con un resultado esperado por escrito, y las dividimos en tres niveles:
- Nivel 0: ¿Se construyó y en qué intento?
- Nivel 1: ¿Se ejecuta realmente en un sitio de pruebas con datos de muestra?
- Nivel 2: ¿Hizo lo que se le pidió? Un modelo lee el prompt y califica el gráfico del flujo de trabajo resultante.
Nuestro objetivo es un 70% de aciertos en el primer intento.
Pruebas de carga
Webflow aloja sitios para cerca del 1% de internet, así que queríamos saber cómo aguantaría n8n antes de que los clientes empezaran a depender de él.
Configuramos un nodo principal de n8n y cuatro trabajadores en un entorno de pruebas aislado y ejecutamos varias rondas de pruebas. Una de nuestras favoritas fue un flujo de trabajo al que llamamos el "martillo de Fibonacci". Ejecutaba un cálculo de Fibonacci intensivo para la CPU con casi nada de E/S, para poner el hardware bajo la mayor presión posible.
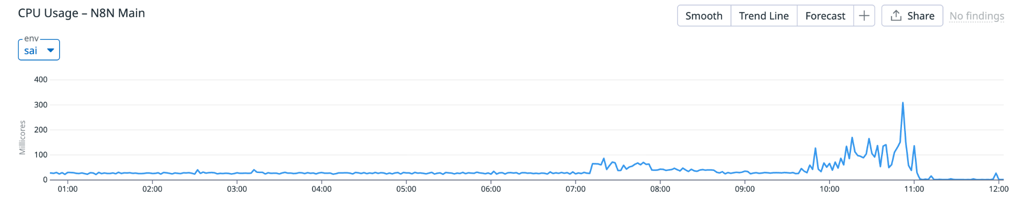
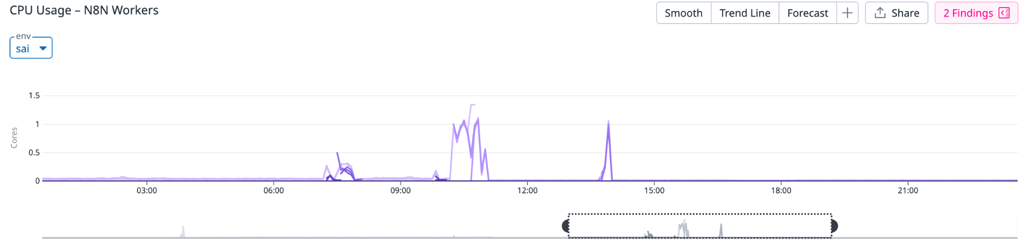
Pasamos de dos ejecuciones por segundo a 550 y completamos unas 300.000 ejecuciones en aproximadamente una hora. Esto es lo que observamos:
- El nodo principal se mantuvo estable hasta las 500 ejecuciones por segundo. A partir de ahí, se cayó y se recuperó por sí solo un minuto después.
- Cada trabajador saturó un núcleo de CPU sin llegar al límite máximo.
- El escalado automático llevó al grupo de trabajadores a su tope de cuatro.
- Redis y Postgres aguantaron todo el proceso.
También descubrimos que nos faltaban algunas métricas, así que añadimos telemetría de CPU y una métrica de profundidad de cola de Redis. En resumen, n8n en modo cola gestionó hasta unas 500 ejecuciones por segundo. Elegimos una prueba de carga de CPU porque es lo que más exige a los trabajadores. Los flujos de trabajo reales suelen esperar a operaciones de E/S, por lo que cargan menos al trabajador.
Lo que aprendimos
Algunas conclusiones que compartiríamos con cualquiera que esté construyendo algo similar:
- Trata el JSON del flujo de trabajo como un objetivo de compilación y dale a tu generador una interfaz tipada.
- Los proyectos de n8n funcionan bien para la multiinquilino.
- Puedes exigirle mucho a los trabajadores de n8n en modo cola.
- Sincronizar el estado de los flujos de trabajo entre varios sistemas es complicado. Planifica los eventos perdidos desde el principio: usa el sondeo como respaldo al flujo de eventos y configura alertas para las ejecuciones que se queden bloqueadas en estado de ejecución demasiado tiempo.
Presentamos este trabajo por primera vez en la conferencia In the Loop de n8n en Berlín.