



Encapsuler les API existantes en outils MCP semblait être le bon point de départ. Ça ne l'était pas. Les agents ne lisent pas la documentation, ne gèrent pas d'état, et ne composent pas des points de terminaison granulaires comme le font les développeurs. Se tromper sur ce point nous a appris la majeure partie de ce que nous savons aujourd'hui sur la conception pour les agents.
Début 2025, Webflow a commencé à construire pour MCP avant qu'il n'existe de playbook clair pour des API prêtes pour les agents. Nous avons annoncé publiquement notre serveur MCP en avril 2025, puis avons rejoint le Demo Day de Cloudflare en mai 2025, aux côtés de la première vague de serveurs MCP distants.
Notre première approche était simple : encapsuler les API existantes en outils MCP. Mais nous avons vite appris que les API conçues pour les développeurs ne fonctionnent pas bien pour les agents. Les API destinées aux développeurs supposent que des humains peuvent lire la documentation, faire des recherches ou obtenir des réponses depuis diverses sources externes, composer des points de terminaison granulaires, gérer un état, et traiter les échecs manuellement. Les agents opèrent avec beaucoup moins de contexte implicite et s'appuient fortement sur la surface de l'API elle-même pour guider la planification et l'exécution, et décider s'il faut réessayer, revoir ou arrêter. Exposer directement des API destinées aux développeurs à des agents a donc rendu nos premiers outils MCP trop bas niveau et trop verbeux, nécessitant souvent de nombreux appels d'outils pour des tâches simples, tout en peinant sur des workflows plus complexes. Le résultat : des échecs subtils, des temps d'exécution inefficaces, et une réalisation des tâches peu fiable.
Au cours de l'année suivante, nous avons beaucoup itéré : redessiner les outils autour d'intentions plutôt que de points de terminaison, simplifier les schémas, améliorer l'efficacité des appels d'outils, et rendre les réponses plus faciles à raisonner pour les agents. Nous continuons aussi d'investir en profondeur dans les fondations sous-jacentes, de la couche de code aux abstractions de système de fichiers, pour soutenir des workflows d'agents plus fiables et plus capables.
Beaucoup de ces décisions ressemblent désormais à des schémas émergents dans le secteur : des outils orientés tâche, des schémas lisibles par les agents, des indications d'erreur exploitables, et des API conçues autour de l'intention plutôt que des détails d'implémentation. Cet article partage les leçons qui ont façonné le serveur MCP de Webflow, et explique pourquoi concevoir pour les agents est finalement devenu bien plus vaste qu'exposer des API via MCP. Cela a exigé de repenser la façon dont les systèmes autonomes découvrent des capacités, coordonnent l'exécution, naviguent dans les surfaces produit, et fonctionnent de manière fiable à l'exécution.
Pourquoi les API destinées aux développeurs ne fonctionnent pas bien pour les agents
Un utilisateur pourrait demander à un agent de mettre à jour le hero de la page d'accueil. Dans une API traditionnelle, cela peut se transformer en une chaîne d'opérations bas niveau :
Les premières implémentations MCP exposaient souvent directement les API existantes destinées aux développeurs comme des outils MCP :
MCP en lui-même n'était pas le problème. Le protocole fonctionnait comme prévu. Un LLM ne voit que les descriptions d'outils, les schémas, les réponses précédentes et la fenêtre de contexte actuelle. Il doit inférer dynamiquement une stratégie d'exécution tout en préservant un état intermédiaire à travers plusieurs appels d'outils. C'est là que les modes de défaillance commencent à apparaître. Chaque appel d'outil supplémentaire augmente la latence, la consommation de tokens, la pression sur le contexte, et la probabilité d'un échec d'exécution. L'agent doit désormais :
- préserver correctement les identifiants intermédiaires
- sélectionner la bonne ressource parmi des résultats ambigus
- interpréter des réponses bruitées ou trop génériques
- coordonner des opérations dépendantes dans le bon ordre
- décider si les échecs sont réessayables ou définitifs
Même quand l'API prend techniquement en charge le workflow, une trop grande partie du budget d'exécution du modèle est consacrée à naviguer dans l'API plutôt qu'à accomplir la tâche de l'utilisateur.
Ce dont une API pour agents a besoin
La leçon pour nous a été qu'exposer des API via MCP n'était que le point de départ. La fiabilité de l'exécution des agents dépendait bien davantage de la forme et de la sémantique des outils eux-mêmes. Les API destinées aux développeurs optimisent généralement la flexibilité et la composabilité. Les API pour agents doivent optimiser la fiabilité d'exécution : moins de choix ambigus, moins d'appels dépendants, moins d'état à préserver, et des indications plus claires quand quelque chose va mal.
Pour la mise à jour du hero de la page d'accueil, la meilleure interface est un outil au niveau de la tâche qui correspond directement à l'intention de l'utilisateur :
Les API déclaratives transforment des workflows complexes et multi-étapes en un seul appel piloté par l'intention. Plutôt que d'exiger que l'agent découvre les structures internes, préserve un état intermédiaire, coordonne des opérations dépendantes, ou se rétablisse après des échecs partiels, la plateforme gère l'orchestration en interne. Cela réduit les modes de défaillance et permet à l'agent de se concentrer sur l'objectif de l'utilisateur plutôt que sur les détails d'exécution.
Passer d'API bas niveau à des outils au niveau de la tâche était une bonne direction, mais cela a introduit un nouveau problème à l'échelle de Webflow : l'explosion des outils. Webflow prend en charge trop de workflows valides pour modéliser chacun comme son propre outil MCP. Une conception purement orientée tâche crée rapidement une surface d'outils vaste et qui se chevauche, devenant difficile à naviguer efficacement pour les agents. Pour résoudre ce problème, il existe essentiellement 2 approches, et nous discuterons des deux schémas plus en détail dans les sections suivantes :
- Une architecture d'outils en couches : Plutôt que d'exposer des centaines d'outils autonomes, nous avons regroupé les capacités liées en outils de domaine plus larges, avec des actions typées et composables à l'intérieur. Cela a donné aux agents une carte plus structurée et navigable de la surface produit, tout en gardant l'espace d'outils de premier niveau maîtrisable.
- L'introduction d'abstractions de système de fichiers avec des représentations en code des projets Webflow : les agents pouvaient opérer sur une représentation structurée du projet en utilisant des workflows familiers de programmation et de type shell. Cela a déplacé une partie du modèle d'interaction de l'orchestration d'API vers des environnements d'exécution et une manipulation pilotée par le code.
Lancer et faire évoluer notre serveur MCP
L'une des leçons que nous avons apprises est que concevoir des API pour les agents va au-delà de la surface de l'API elle-même. Une fois que les agents sont devenus des participants actifs dans des workflows de longue durée, de nombreuses décisions systémiques environnantes ont commencé à affecter directement la qualité d'exécution : architecture des sessions, organisation des outils, coordination à l'exécution, observabilité, et même distribution.
En pratique, construire des systèmes d'agents fiables est devenu un problème de conception full-stack. Cela a façonné la façon dont nous avons abordé le serveur MCP de Webflow selon quatre axes :
- infrastructure pour l'exécution avec état et la coordination à l'exécution
- conception de la surface d'outils pour la clarté et une découverte efficace des capacités
- systèmes d'observabilité pour comprendre le comportement réel des agents
- schémas de distribution qui ont réduit la friction de mise en place et fait évoluer l'adoption
1. Infrastructure
Les besoins en infrastructure pour un serveur MCP se sont révélés très différents de ceux d'un service d'API traditionnel. Si MCP lui-même n'exige pas d'état côté serveur, les workflows d'agents réels sont fortement porteurs d'état. Un agent peut s'authentifier une fois, inspecter le contexte du site, appeler plusieurs outils à travers différentes surfaces produit, et continuer à raisonner tout au long d'un workflow de longue durée. Traiter chaque interaction comme entièrement sans état forcerait le modèle à reconstruire à répétition le contexte et l'état d'exécution, augmentant à la fois la latence et la probabilité d'échec.
Nous avons construit le serveur MCP de Webflow sur Cloudflare en utilisant les Durable Objects, car ils offrent un modèle d'exécution naturellement orienté session. Chaque session MCP possède sa propre instance serveur, gérant le contexte utilisateur, les outils disponibles et la coordination à l'exécution, sans nécessiter d'infrastructure de session séparée.
Nous avons également dû prendre en charge deux environnements d'exécution différents. Certaines opérations s'exécutent en mode headless via les API Webflow, tandis que les actions du Designer, comme l'insertion d'éléments ou la mise à jour des styles, dépendent du canvas du navigateur en direct. Pour ces workflows, le serveur MCP maintient un pont WebSocket vers une extension Designer s'exécutant dans la session Webflow active de l'utilisateur.
Cette architecture offre aux agents une surface MCP unifiée tout en permettant au système d'acheminer les opérations vers le bon environnement d'exécution en arrière-plan. Dans le même temps, nous déplaçons progressivement davantage de capacités du Designer vers des API headless. Réduire la dépendance à l'exécution dans un navigateur en direct simplifie l'architecture d'exécution, réduit la complexité de coordination, et améliore la stabilité et la fiabilité globales pour les workflows d'agents.
2. Concevoir la surface d'outils
Comme mentionné précédemment, nous avons trouvé deux approches différentes qui aident à réduire la surcharge d'orchestration et de découverte pour les agents : l'organisation en couches des outils et les abstractions de système de fichiers avec représentations en code des projets Webflow. Avec le temps, nous avons commencé à les considérer comme des solutions à court terme et à long terme au même problème sous-jacent.
À court terme, l'architecture en couches aide à mesure que la surface MCP s'étend, puisque nous donnons aux agents une meilleure carte plutôt que d'exposer tous les outils en même temps. Au lieu d'exposer chaque tâche comme un outil MCP autonome, nous avons regroupé les capacités liées en outils de niveau domaine avec des actions typées et composables à l'intérieur. Par exemple, les opérations CMS sont regroupées sous une surface d'outils partagée pour les collections, les champs, les éléments, la publication et les mises à jour, tandis que les capacités du Designer sont organisées autour des éléments, des styles, des variables, des assets et des composants.
Plus précisément, la surface d'outils a évolué en plusieurs couches :
- Les outils de domaine organisent de larges zones du produit
- Les actions fournissent des primitives typées et composables au sein de chaque domaine
- Les outils de workflow encapsulent les tâches à forte orchestration
- Les outils guide fournissent des instructions opérationnelles et le contexte produit pour une exécution plus sûre
Bien que cette approche ait certainement aidé à atténuer les problèmes de surface d'outils et d'orchestration, elle n'élimine pas fondamentalement le problème. À mesure que les capacités produit se développent, le nombre de workflows et d'actions valides peut continuer à croître rapidement, même au sein d'une architecture en couches. À un certain point, le défi passe de la simple organisation des outils à la réduction globale de la dépendance du système à la découverte explicite d'outils. Même des hiérarchies d'outils bien structurées exigent encore que le modèle recherche, sélectionne des capacités, interprète des schémas, et coordonne l'exécution à travers les API.
C'est là que les abstractions de type système de fichiers et les environnements orientés code deviennent de plus en plus importants. Plutôt que de forcer chaque interaction à passer par une invocation explicite d'outil MCP, les agents peuvent opérer sur une représentation structurée du projet, davantage semblable à un espace de travail programmable. Anthropic et Cloudflare ont tous deux évoqué des directions similaires dans leurs travaux récents sur l'infrastructure des agents. Voir l'exemple suivant pour la tâche de mise à jour de la page d'accueil en mode code :
Cela s'accorde beaucoup plus naturellement avec les forces actuelles des LLM. Les modèles sont déjà très efficaces pour raisonner sur du texte structuré, générer du code, modifier des fichiers, et opérer au sein d'environnements d'exécution. En déplaçant le modèle d'interaction de l'orchestration d'API vers la manipulation d'état structuré, le système réduit la surcharge de découverte, la consommation de contexte, et le fardeau de la coordination multi-étapes.
La leçon plus profonde est que faire évoluer les systèmes d'agents ne consiste pas seulement à ajouter plus d'outils. Il s'agit de donner aux modèles un environnement d'exploitation plus navigable et plus efficace.
3. Observabilité
L'observabilité est devenue beaucoup plus importante à partir du moment où les agents ont commencé à opérer de façon autonome sur des workflows de longue durée.
Les logs et traces traditionnels étaient utiles pour le débogage de l'infrastructure : ils pouvaient nous dire quelles requêtes avaient échoué, les schémas de latence, ou les exceptions côté serveur. Mais ils étaient mal adaptés pour comprendre le comportement des agents. Ils ne nous disaient pas ce que l'agent essayait réellement d'accomplir, quelles capacités il s'attendait à trouver, où les workflows devenaient confus, ni pourquoi des sessions apparemment « réussies » produisaient malgré tout de mauvais résultats.
Pour combler cet écart, nous avons intégré MCPCat comme couche d'observabilité autour du serveur MCP lui-même. En encapsulant le serveur à l'initialisation, il capture les appels d'outils, les lectures de ressources, les tentatives d'outils manquants, les métadonnées de session, et les schémas de réponse sur l'ensemble du flux d'exécution. Le signal le plus précieux s'est révélé être l'intention.

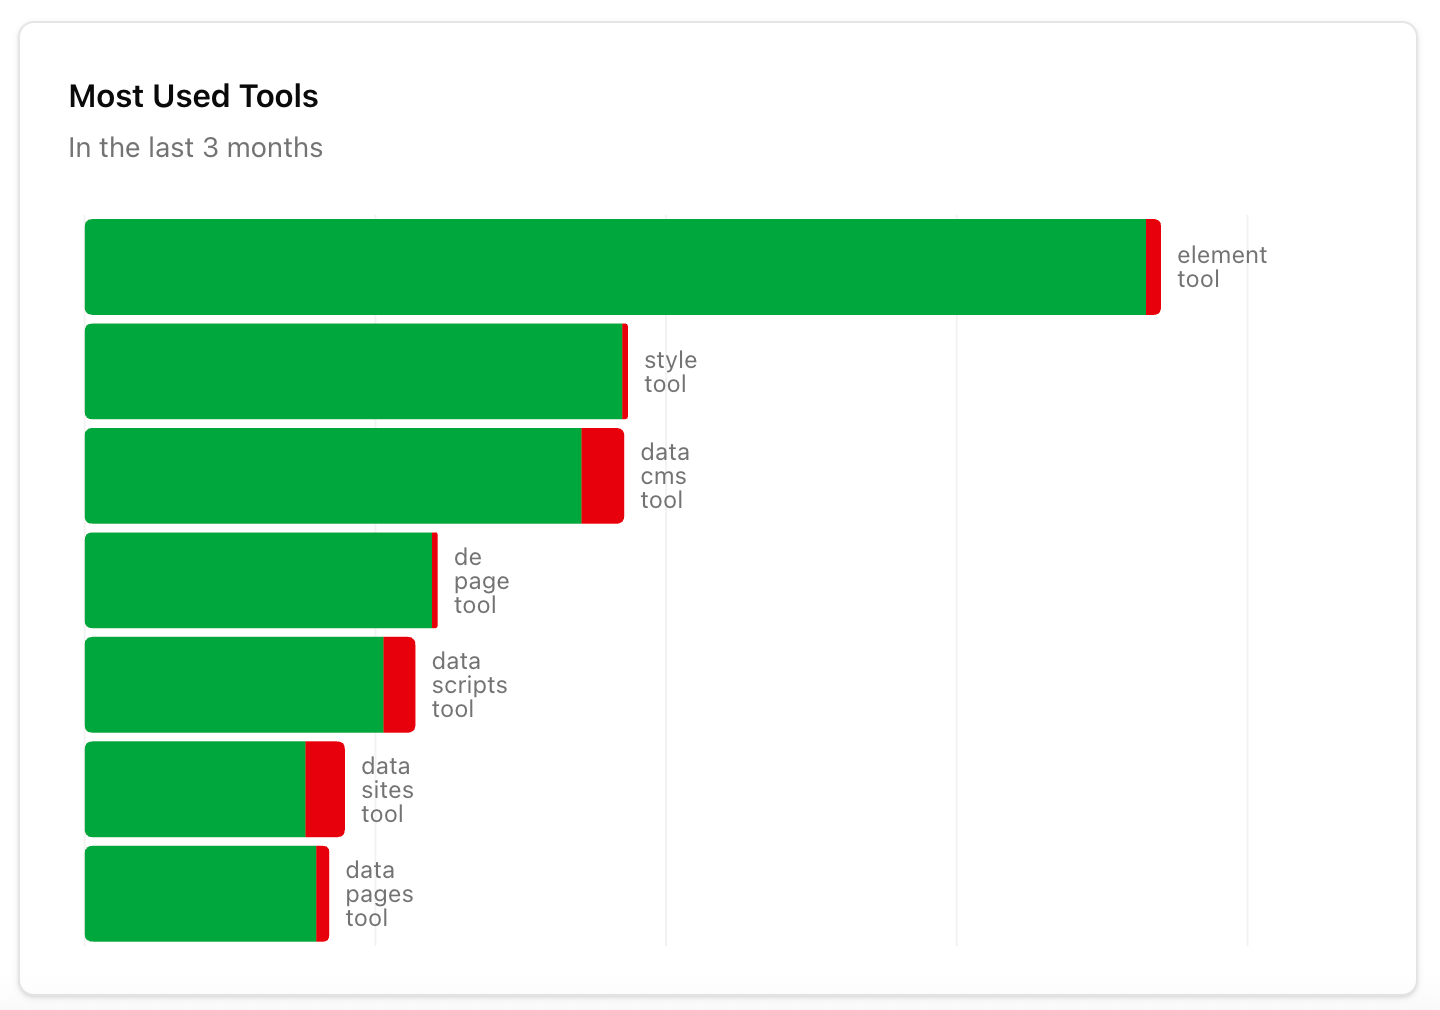
Les tentatives d'outils manquants ont révélé des capacités ou des schémas de nommage que les agents attendaient mais ne trouvaient pas. La relecture des sessions a mis en lumière des workflows dégradés où le modèle explorait, réessayait ou changeait de direction de façon répétée sans jamais produire d'erreur franche. Dans de nombreux cas, le système paraissait sain du point de vue de l'infrastructure alors que l'expérience de l'agent échouait silencieusement.
Nous nous attendions initialement à ce que la migration CMS et la gestion de contenu dominent l'usage. Au lieu de cela, Agent Goals a montré que concevoir directement dans le canvas Webflow via des agents tiers représentait 27,7 % des sessions. Nous avons également découvert une erreur silencieuse affectant plus de 10 % des sessions, et constaté que 58,7 % des sessions se regroupaient autour de trois workflows principaux.
Avec le temps, nous avons réalisé que l'observabilité pour les systèmes d'agents est fondamentalement différente de l'observabilité pour les API. L'objectif n'est pas seulement de comprendre si les requêtes ont réussi, mais de comprendre comment les modèles raisonnent, explorent les capacités, se rétablissent face à l'ambiguïté, et échouent pendant l'exécution.
4. Faire évoluer la distribution
Faire évoluer la distribution d'un serveur MCP ne consistait pas seulement à gérer plus de trafic. Il s'agissait de réduire la friction d'adoption, d'élargir les endroits où les agents pouvaient utiliser Webflow, et d'améliorer la qualité des workflows que ces agents pouvaient exécuter.
L'adoption s'est accélérée après le lancement d'un connecteur MCP hébergé début 2026, en commençant par Claude, ce qui a considérablement réduit la friction de configuration pour les utilisateurs. Plutôt que de configurer manuellement les connexions MCP et les flux d'authentification, les utilisateurs pouvaient se connecter à Webflow via une intégration hébergée et gérée, avec beaucoup moins de charge opérationnelle. Nous avons observé une croissance des sessions multipliée par 6,7 au cours des 3 derniers mois.
Faire évoluer l'adoption a aussi rendu une chose évidente : les agents ont besoin de plus que des outils. Les outils exposent ce qu'un agent peut faire ; les skills encodent comment bien le faire. Pour Webflow, de nombreux résultats réussis exigent un jugement produit, des workflows réutilisables et des conventions de domaine, pas seulement un accès API. Apporter davantage de skills utiles à l'expérience MCP de Webflow, comme des schémas de mise en page, des playbooks de migration CMS, des workflows SEO, des vérifications d'accessibilité et des conseils de système de marque, devient critique à mesure que les agents passent de simples appels d'outils à un travail de bout en bout sur le site.
À mesure que l'adoption augmentait, les défis se sont déplacés de la mécanique du protocole vers l'expérience produit pour les systèmes autonomes : fournir un contexte de site plus riche, étendre la couche de skills, et comprendre si les actions des agents aidaient réellement les utilisateurs à accomplir des résultats significatifs.
Résumé
Les agents ne sont pas simplement un autre client d'API. Ce sont un type différent de participant à l'exécution : un participant qui raisonne à travers le contexte, explore les capacités dynamiquement, apprend de la structure de l'interface, et dépend du système pour rendre la prochaine action correcte à la fois découvrable et fiable.
Concevoir pour ce type d'utilisateur change bien plus que des API. Cela affecte la façon dont nous structurons les outils, gérons l'orchestration, exposons le contexte, construisons des environnements d'exécution, observons les workflows, et même comment les surfaces produit elles-mêmes sont modélisées. Avec le temps, nous nous sommes retrouvés à concevoir non seulement des interfaces MCP, mais des environnements d'exploitation complets pour des systèmes autonomes.
Cela nous a poussés vers des architectures d'outils en couches, des abstractions de workflow, des représentations de projet de type système de fichiers, une observabilité plus riche, et des couches de skills. L'objectif n'a jamais été simplement d'exposer plus de capacités aux agents. Il s'agissait d'aider les modèles à prendre des décisions correctes avec moins d'exploration, moins de charge d'orchestration, et une plus grande fiabilité d'exécution.
Le travail à venir ne consiste pas seulement à rendre Webflow programmable pour les agents. Il s'agit de rendre Webflow lisible, navigable et opérationnellement fiable pour des systèmes autonomes, sans perdre la flexibilité qui rend la plateforme puissante pour les humains. C'est à la fois un défi produit profond et un défi systémique, exactement le genre de problème que nous sommes impatients de résoudre chez Webflow.