
Aperçu du harnais d'évaluation MCP de Webflow
Une coche verte sur votre agent ne vous dit pas que l'agent fera ce qu'il faut avec vos outils. Elle vous dit que les outils ont renvoyé du JSON valide. Ce sont des affirmations différentes, et l'écart entre les deux est exactement là où les serveurs MCP échouent réellement devant un utilisateur réel, avec un agent réel prenant ses propres décisions. Et parfois ces décisions sont plutôt mauvaises quand les clients comptent sur leur expérience de marque pour être portée par un produit. Dans cet article, nous expliquons comment nous construisons plus de confiance dans le comportement de notre serveur MCP au sein d'agents que nous ne contrôlons pas.
Le problème du test d'un serveur MCP
Le serveur Model Context Protocol (MCP) de Webflow confie aux agents IA, qu'il s'agisse de Claude, ChatGPT, Cursor ou de tout autre outil auquel une personne se connecte, un ensemble d'outils pour construire des pages, gérer le contenu CMS et publier des sites pour le compte de quelqu'un. Les tests traditionnels peuvent établir que chaque outil MCP est correct de manière isolée : il accepte les bonnes entrées, applique les permissions, modifie l'état attendu, et gère correctement les échecs. Mais ils ne peuvent pas répondre à une autre question : lorsqu'un agent autonome voit l'ensemble de la surface d'outils et reçoit une tâche en langage courant, va-t-il découvrir et combiner correctement ces capacités ?
On n'obtient une réponse qu'en observant le comportement d'un agent. C'est exactement ce que fait notre harnais d'évaluation. Il fait fonctionner de vrais hôtes d'agents, sans interface, contre de vrais sites Webflow jetables, avec des tâches en langage courant. Il évalue ce que l'agent choisit de faire, pas seulement si les outils qu'il a appelés ont renvoyé des réponses valides.
Ce qu'il fait réellement
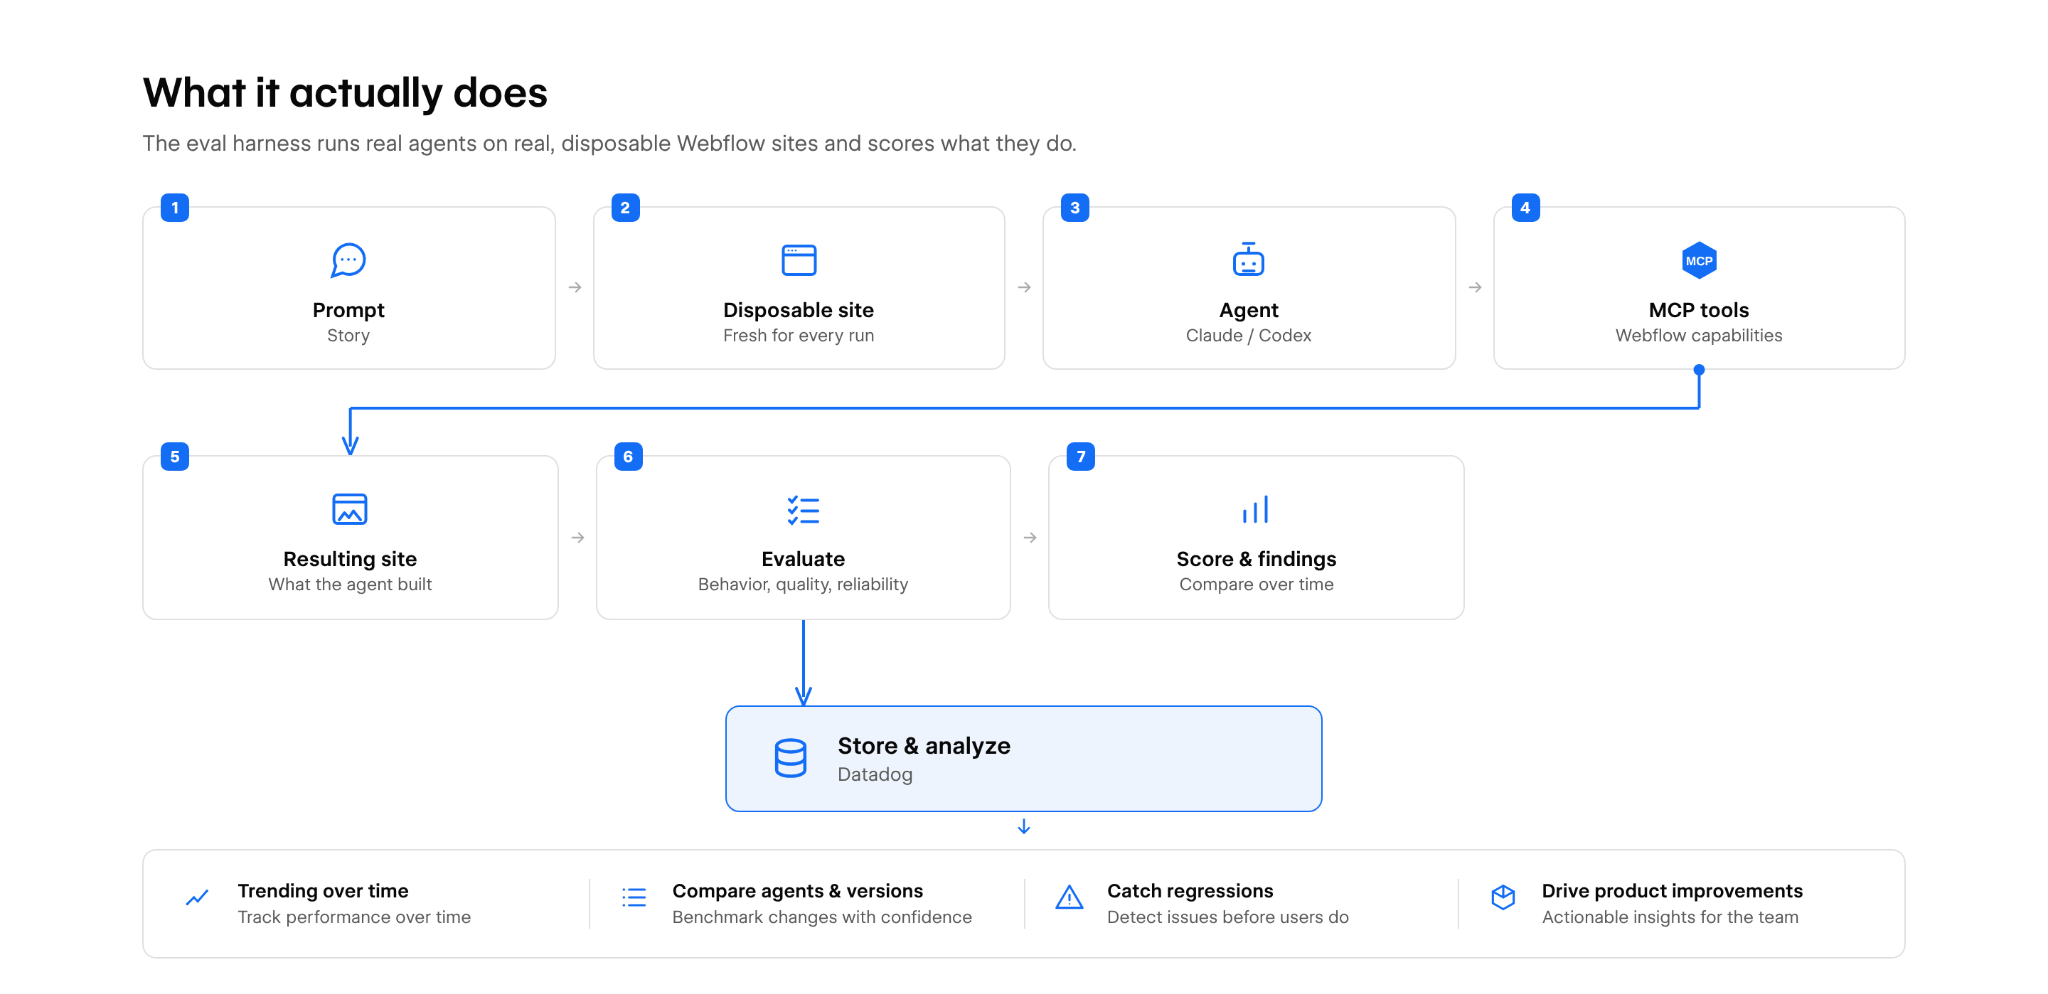
Le harnais exécute des stories : des tâches agentiques à plusieurs étapes écrites comme de simples prompts, chacune avec des assertions sur ce qui devrait se produire. Une story pourrait être « créer une collection CMS avec trois champs et une entrée », ou « construire une landing page SaaS complète en headless et la publier ».
Pour chaque story, le harnais provisionne un site neuf et fait tourner un vrai agent contre lui, tour par tour, actuellement Claude Code ou Codex CLI d'OpenAI. Des contrôles déterministes vérifient l'usage attendu et interdit des outils et, si pertinent, vérifient qu'une écriture revendiquée a bien eu lieu. Un juge LLM lit la transcription et la réponse finale pour évaluer l'accomplissement de la tâche, le choix des outils et la justesse. Les stories de construction de page ajoutent un juge visuel sur le résultat rendu, tandis que des signaux structurels peuvent inspecter ce que la capture d'écran ne peut pas montrer.
Chaque trace, score, finding et capture d'écran part vers Datadog, si bien que les runs sont interrogeables et comparables dans le temps. Voilà le squelette. La partie intéressante, c'est ce que nous avons appris une fois qu'un simple chiffre réussite/échec ne suffisait plus.
L'agent a-t-il vraiment fait ce qu'il fallait ?
Nous séparons la justesse du résultat du diagnostic du chemin d'exécution. D'abord, le changement d'état prévu s'est-il réellement produit ? Ensuite, l'agent a-t-il violé une contrainte réelle, par exemple en utilisant un outil destructif ou une capacité indisponible sur cet hôte ? Enfin, a-t-il pris un chemin étonnamment difficile qui suggère que la surface d'outils pourrait être plus claire ? Un chemin différent n'est pas nécessairement erroné, mais il vaut souvent la peine d'être compris.
Chaque run laisse une liste de points à corriger, pas seulement un score
Le même appel de juge LLM qui note une story produit aussi des findings : des problèmes concrets et exploitables qu'il a remarqués dans la transcription, que la story ait réussi ou non. Un appel d'outil a échoué. L'agent a contourné une capacité déroutante. Une capacité manquante a dû être simulée. Une story peut réussir chaque assertion et pourtant faire remonter des findings, car « l'agent y est arrivé au final » et « les outils ont rendu cela facile » sont deux questions différentes.
Quelques findings tirés directement de vrais runs :
- data_whtml_builder refuse plusieurs éléments racines par appel, forçant l'agent à diviser trois sections en insertions séparées et à les inverser dans l'ordre ; l'outil devrait prendre en charge les fragments multi-racines.
- data_style_tool renvoie des réponses de plus de 71 Ko qui dépassent les limites de tokens, forçant l'agent à passer par Bash pour les analyser.
- Webflow renomme automatiquement les classes CSS en cas de collision (.hero devient .hero-1-2-3), cassant silencieusement le nom de classe voulu par l'agent sans aucun avertissement de l'outil.
Aucun de ces cas n'est un bug de type réussite/échec. Chaque story s'est tout de même terminée. Mais chacun est un retour produit précis, remonté par un agent ayant réellement rencontré le papercut, pas par quelqu'un devinant ce qui pourrait mal se passer. Ces findings vivent dans la trace à côté du score, si bien qu'une coche verte n'efface plus le chemin que l'agent a dû prendre.
Que cache un run unique ?
Un seul run réussi peut cacher une variation significative, c'est pourquoi le harnais peut exécuter la même story de manière répétée, avec un site neuf et une nouvelle session d'agent chaque fois. C'est d'abord un outil de diagnostic, pas une prétention à la fiabilité statistique. Dans un premier diagnostic sur trois runs, les assertions déterministes ont réussi les trois fois, tandis que les scores de qualité de design étaient de 40 %, 80 % et 85 %. Trois observations ne suffisent pas à estimer la distribution de réussite sous-jacente, mais elles ont immédiatement révélé quelque chose que le résumé original cachait : l'exécution des outils était stable, la qualité du résultat ne l'était pas.
Le résumé console original rapportait mean=1.00 et stdev=0.00 parce que l'agrégation ne voyait que le score déterministe. Ce résultat était mathématiquement correct et opérationnellement trompeur. Nous rapportons désormais ces dimensions séparément et conservons les résultats bruts au niveau de chaque run : les contrôles déterministes ont réussi à 1.00 sur les trois runs ; la qualité de design a obtenu 40 %, 80 % et 85 %. À mesure que nous augmentons la taille des échantillons, la même infrastructure peut soutenir des analyses de fiabilité et de régression plus défendables.
Le signal évident n'est pas le seul signal
Un juge LLM qui note une capture d'écran ne voit que la capture d'écran. Deux pages peuvent s'afficher de façon identique au pixel alors que l'une est construite avec une structure porteuse de sens (<nav>, <section>, <button>) et l'autre est une soupe de div de bout en bout. C'est une vraie différence d'accessibilité et de maintenabilité, invisible pour une image.
Nous avons ajouté semantic_html_ratio, un signal déterministe, sans LLM, calculé à partir du HTML rendu déjà capturé pour la capture d'écran : la proportion de balises sémantiques par rapport aux wrappers génériques, combinée entre les pages par volume de markup plutôt que naïvement moyennée. Ce n'est pas une barrière réussite/échec. Les divs wrapper sont normaux, et le générateur visuel de Webflow lui-même est naturellement riche en div, mais cela nous donne un second signal indépendant pour comparer les runs et observer les tendances dans le temps.
La couverture des hôtes d'agents fait partie de la couverture d'évaluation
C'est celui qui a le plus compté en pratique. OpenAI a rejeté une de nos soumissions d'application ChatGPT après qu'un agent a tenté d'utiliser un outil de canevas Designer qui nécessite un onglet Webflow Designer ouvert, quelque chose qu'une session ChatGPT ne peut jamais avoir. Nous avons fait tourner les prompts exactement rejetés à travers notre harnais de façon répétée et n'avons jamais reproduit l'échec. Pas une seule fois.
La raison était d'une simplicité gênante : le harnais n'avait jusqu'alors été piloté que par Claude, et Claude n'a essentiellement jamais mordu à cet hameçon d'indications d'outils statiques. Le rejet en production venait d'un modèle de la famille GPT. Nous avions construit un vrai harnais d'évaluation et ne l'avions jamais fait tourner contre l'agent qui échouait réellement en production.
Nous avons donc ajouté un second driver qui passe par la Codex CLI d'OpenAI, de la même façon que l'original passe par Claude Code. Les deux partagent un même noyau d'orchestration : provisioning, scoring, juges, captures d'écran, tentatives et upload sont identiques. Seul « lancer l'agent et analyser sa sortie » diffère.
Nous avons ensuite mené une comparaison contrôlée : le prompt original contre une version renforcée par une instruction explicite « n'utilisez pas les outils de canevas Designer », cinq répétitions indépendantes chacune, sur les deux drivers.
La même tâche et le même serveur MCP ont produit un comportement matériellement différent entre Claude Code et Codex CLI. Cette expérience n'isole pas le modèle sous-jacent de l'orchestration de l'hôte environnant, et sur le plan opérationnel, ce n'est pas nécessaire. Les utilisateurs vivent le système combiné : modèle, instructions système, présentation des outils, gestion du contexte et politique d'exécution. La leçon n'était pas qu'un modèle était meilleur. C'était que valider contre un seul hôte d'agent nous donnait une confiance qui ne se transférait pas à un autre environnement. Chaque fonctionnalité de renforcement de confiance ci-dessus, y compris les tests répétés, les signaux sémantiques et le jugement de transcription, tourne désormais de façon identique contre les deux hôtes, car ces capacités vivent dans le noyau partagé plutôt que dans du code spécifique à Claude. Quoi que nous vérifions désormais, nous le vérifions sur les deux.
Pourquoi cela compte pour l'avenir
Courir après une coche verte n'a jamais été le but. Avant de livrer, nous pouvons affirmer quelque chose de précis et vrai : nous avons fait tourner exactement cette tâche, plusieurs fois, contre plusieurs agents réels, et voici ce qui s'est réellement passé. C'est un type de confiance différent de celui des tests qui réussissent.
- Chaque changement de schéma d'outil passe par la suite de stories avant d'être livré. Les mêmes stories peuvent viser un serveur MCP exécuté localement, si bien que les régressions peuvent être détectées sur une pull request plutôt qu'après le déploiement.
- Chaque nouvelle soumission d'application ChatGPT est d'abord vérifiée contre les deux drivers, si bien qu'un correctif est vérifié contre la famille de modèle qui a réellement échoué, pas seulement contre celle qui a réussi par hasard.
- Une story instable apparaît comme instable, avec de la variance, plutôt que d'avoir de la chance en CI et de surprendre quelqu'un plus tard.
La suite tourne désormais chaque nuit, transformant la dérive en un chiffre qui évolue chaque jour plutôt qu'en une plainte de production que quelqu'un doit retracer des semaines plus tard.
La suite nocturne nous donne une couverture continue, mais le harnais est tout aussi utile dans le travail quotidien de produit et d'ingénierie. Un ingénieur qui change un outil, ou quelqu'un de l'équipe produit qui valide une nouvelle capacité, peut exécuter manuellement exactement les stories et la couverture d'agents qui l'intéressent avant que quoi que ce soit ne soit livré.
Nous avons transformé cette connaissance opérationnelle en une compétence Claude Code, /eval-harness-runbook. Quelqu'un peut décrire ce qu'il veut tester, et la compétence gère la configuration, la couverture pertinente, le nommage des expériences et les findings post-run. Cela transforme le harnais en une surface de test en self-service pour l'ingénierie et le produit.
L'exécuter est passé de connaître la formule magique à simplement demander, et obtenir une réponse.
Où cela s'en va
Le travail à court terme est opérationnel : signaler automatiquement les outils sans couverture de story, et transformer chaque run nocturne en un rapport de régressions, de nouveaux findings et de variance notable qui arrive là où les gens regardent déjà.
La question la plus difficile est ce qu'un score signifie réellement. Aujourd'hui, le brief de chaque story, y compris ce qui compte comme « bon », vient de celui qui l'a écrit. Utile, mais inventé. Nous voulons un plafond de référence idéal : construire à la main une version idéale d'une story phare, la noter avec le même juge, et exprimer les futurs runs par rapport à ce plafond plutôt que de traiter un simple score de 0 à 4 comme évident en soi.
Et l'ensemble de stories lui-même ne devrait pas rester figé au lancement. Aujourd'hui, il reflète ce que nous avons imaginé que les utilisateurs pourraient demander. Avec le temps, nous voulons de nouvelles stories ancrées dans des schémas d'usage réels et des analytics, pas des données brutes d'utilisateurs, afin que ce qui se passe réellement dans le monde enseigne à la suite quoi tester ensuite. C'est la version de ce harnais qui vaut la peine d'être construite : non seulement détecter ce que nous avions pensé à vérifier, mais apprendre ce que nous n'avions pas envisagé.