









Les agents peuvent générer des réponses ; des données gouvernées, une expertise codifiée et des contrôles architecturaux rendent ces réponses fiables.
Alors que Webflow construit la plateforme de marketing web agentique, notre équipe Data & Insights a appliqué cette même approche IA-first à la prise de décision interne. Un agent peut écrire du SQL valide et pourtant produire la mauvaise réponse business. Une question est devenue centrale : que faut-il pour qu'un agent produise un travail auquel les humains peuvent faire confiance ?
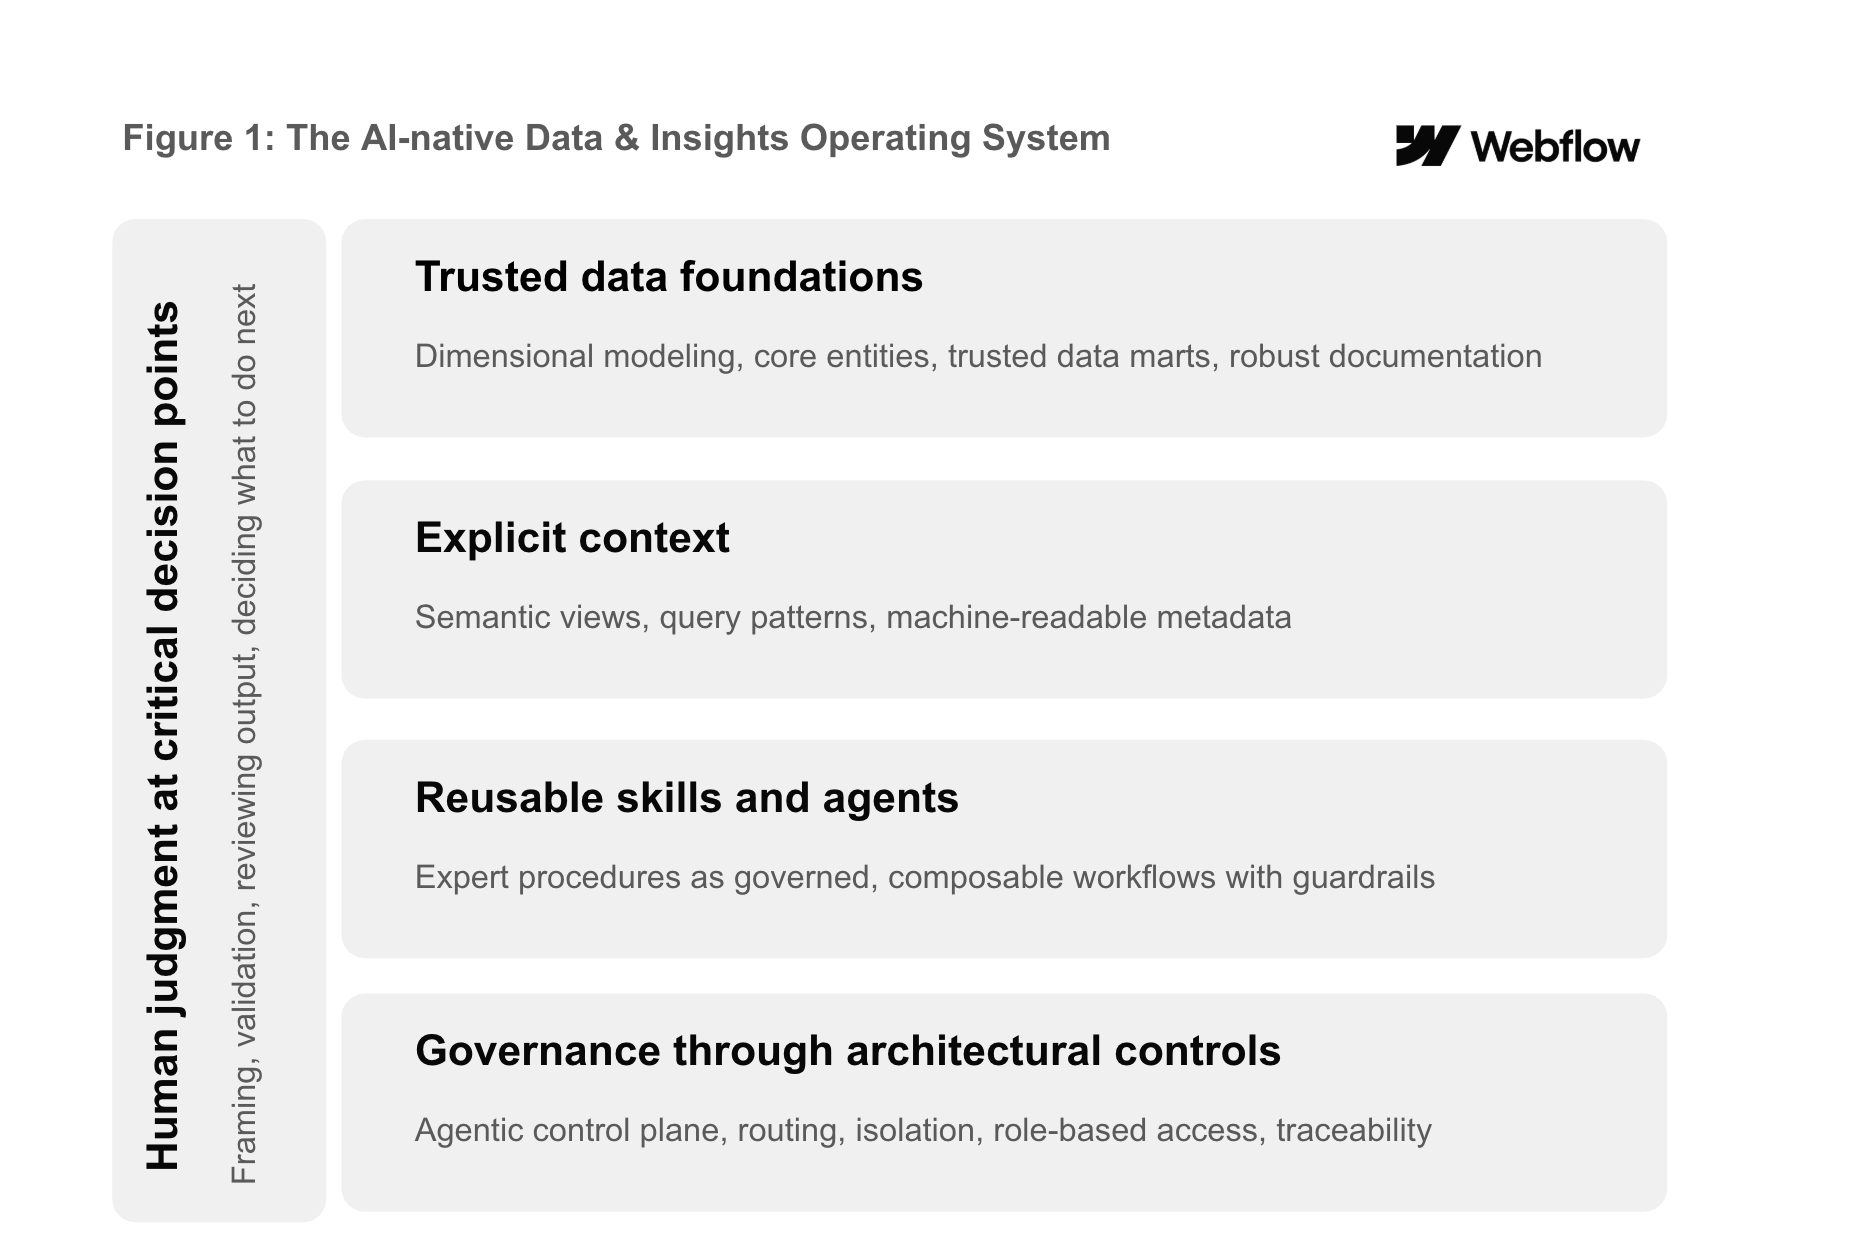
Notre équipe couvre l'ingénierie de plateforme de données, l'ingénierie analytique, la business intelligence et la data science. Pour construire une analyse en self-service fiable, nous avons d'abord dû devenir nous-mêmes des utilisateurs efficaces de l'IA et des créateurs d'agents. Utiliser des agents dans nos propres workflows nous a montré où ils créaient un effet de levier, où ils échouaient, et quel contexte, quels standards, points de contrôle et garde-fous ils devaient avoir pour fonctionner de façon fiable. Cette expérience nous a également obligés à codifier l'expertise qui vivait auparavant dans des workflows individuels. Nous avons appris que rendre l'équipe native de l'IA et permettre une analyse en self-service fiable à l'échelle de Webflow ne sont pas deux transformations distinctes. Les deux reposent sur le même système d'exploitation : données gouvernées, contexte business exécutable, compétences et agents réutilisables, contrôles architecturaux et jugement humain.
Générer une requête est facile. Le défi le plus difficile consiste à codifier les définitions business de Webflow, les sources approuvées, les permissions et les attentes de revue afin qu'un agent puisse fonctionner de façon fiable. Un système d'exploitation natif de l'IA doit continuer à évoluer avec les besoins business et les façons de travailler. Dans cet article, nous partageons ce que nous avons construit, comment cela a changé notre travail, et l'impact que nous observons.
Une analyse en self-service fiable commence par une équipe native de l'IA
Avant de pouvoir proposer des réponses fiables à grande échelle, nous devions faire de l'IA une part intégrante du fonctionnement de notre propre équipe. L'accès à un assistant IA ne suffisait pas. Nous avons ancré une culture « Agent First » dans les normes de l'équipe et les attentes de carrière, repensé les workflows, et protégé du temps pour l'apprentissage et l'expérimentation.
De nouvelles idées pouvaient être testées librement, tandis que les compétences et le contexte réutilisables étaient consignés dans des dépôts centralisés et organisés par niveau de maturité et de confiance. Des ambassadeurs IA et des forums hebdomadaires ont aidé l'équipe à partager des exemples fonctionnels, résoudre des problèmes récurrents, et transformer l'apprentissage individuel en compétences partagées par l'équipe. Ce changement a créé des gains d'efficacité immédiats et nous a donné une expérience directe de la collaboration avec des agents.
L'équipe a adopté une question récurrente : Comment pourrions-nous faire cela avec un agent ?
Le système d'exploitation
Faire évoluer une analyse en self-service fiable à grande échelle nécessitait un système d'exploitation plus large, que les agents pouvaient parcourir de façon fiable et auquel les humains pouvaient faire confiance.
Commencer par des fondations de données fiables
Au cours de la dernière décennie, Webflow a accumulé des centaines de sources, de tables et de modèles construits pour des experts humains, pas pour des agents. Choisir le bon actif dépendait souvent d'un savoir tacite sur les tables à jour, la façon dont les identifiants correspondaient entre les systèmes, et les définitions applicables. Les agents ont rendu cette ambiguïté plus lourde de conséquences. L'année dernière, nous avons lancé un effort de plusieurs trimestres pour reconstruire notre entrepôt de données d'entreprise avec une modélisation dimensionnelle de Kimball. Des schémas en étoile modulaires standardisent désormais les faits, les dimensions, les identifiants et les taxonomies de nos données. Des data marts gouvernés, un dictionnaire de données consultable et un workflow de catalogue automatisé fournissent une source de vérité commune et documentée.
Construire des data marts orientés business avec des entités standardisées
Auparavant, une logique d'entité dupliquée, un mapping d'identifiants incohérent et des définitions de métriques qui dérivaient créaient des résultats contradictoires entre les équipes. La nouvelle couche cœur standardise sept entités maîtresses. Chaque nouveau modèle de faits utilise ces dimensions standardisées, tandis qu'une clé client commune réconcilie les workspaces en self-serve et les identités de comptes commerciaux pour une analyse cohérente au niveau client.
Au-dessus de ce cœur, les data marts gouvernés servent de couches de requête fiables pour différents cas d'usage, remplaçant un reporting fragmenté par des données prêtes à la décision, conçues sur mesure pour la façon de travailler de chaque équipe. Un mart Customer 360 combine les données client et produit, avec des signaux d'adoption produit qui remontent dans Salesforce pour soutenir les équipes terrain sur les upgrades, la rétention et l'expansion. Un mart ARR fournit un reporting réconcilié des revenus récurrents et du net dollar retention par client, abonnement et produit. D'autres marts gouvernés couvrent l'adoption produit, les parcours clients, les tunnels marketing, le pipeline et les bookings, les crédits IA, l'utilisation des sièges, et l'usage du site.
Intégrer la fiabilité dans les fondations
Une fondation de données fiable ne peut pas dépendre du fait que les humains ou les agents se souviennent des sources, définitions et standards à utiliser. Nous codifions ces contrôles directement dans les fondations.
Les standards de modélisation, les définitions sémantiques et la documentation de référence cohabitent dans un dépôt sous contrôle de version, tandis que l'outillage oriente d'abord les agents vers les modèles fiables. Le PR Review Agent vérifie chaque changement dbt pour détecter les violations architecturales, la dérive de nommage, les tests manquants, l'exposition de PII, et les dépendances envers des actifs non certifiés. Le travail en aval doit s'appuyer sur la couche fiable, avec des tests qui détectent les effets non intentionnels avant que les changements ne soient fusionnés. L'objectif est de faire du bon chemin le chemin le plus simple, pour les humains comme pour les agents.
Rendre le contexte business exécutable
Un entrepôt gouverné est nécessaire mais insuffisant. Les agents doivent aussi comprendre ce que Webflow entend par « ARR », « client » ou « utilisation des sièges », et comment ces concepts se traduisent en données. Nous avons créé des actifs de contexte gouvernés pour rendre ces définitions explicites et exploitables par les agents.
Semantic views
Les semantic views agissent comme un contrat entre le langage business et les données gouvernées. Elles codifient les métriques, dimensions, relations et terminologie approuvées sous forme de code versionné, ce qui permet aux clients IA et aux workflows en aval d'utiliser les mêmes calculs. Associées aux modèles de l'entrepôt et aux métadonnées, elles forment une couche de contexte lisible par une machine, afin que la logique business ne vive pas uniquement dans des dashboards ou dans la mémoire des personnes. Les agents peuvent s'appuyer sur ces définitions centralisées plutôt que d'inférer le sens à partir des noms de tables et de colonnes.
Des questions comme « Quel est le NDR par segment ? » peuvent désormais être répondues à partir d'une définition de métrique validée plutôt que d'un SQL ponctuel. Notre Semantic View Author Agent aide à créer des semantic views Snowflake à grande échelle, tandis que les humains conservent la responsabilité des définitions.
Modèles de requêtes et contexte business
Nous codifions les analyses récurrentes sous forme de modèles spécifiques à un domaine, qui définissent la granularité, les filtres, les hypothèses et les modes de défaillance connus, en partant d'une logique déjà validée plutôt qu'en reconstruisant l'approche à chaque fois. Un dépôt lisible par une machine organise les métadonnées de data science, le contexte organisationnel et le travail analytique pour les agents, créant un chemin de l'intuition individuelle vers une connaissance institutionnelle partagée.
Codifier les workflows d'experts en compétences et en agents
Alors que les définitions sémantiques résolvent le sens business, les compétences gouvernent l'exécution. Notre plus gros investissement a consisté à codifier les procédures analytiques et les standards de revue de Webflow en workflows reproductibles définissant les sources et outils autorisés, les étapes d'exécution, les exigences de validation, la revue humaine, la gestion de l'ambiguïté et les preuves. Chaque discipline applique cette approche à son propre travail.
Faire fonctionner la plateforme de données avec une expertise réutilisable
Le travail sur la plateforme de données couvre les systèmes de production, les dépôts et les modes de défaillance, et nécessite souvent une expertise distribuée. Nous avons créé une marketplace de plugins pour construire, versionner, installer et partager cette expertise, avec des mises à jour automatiques pour les utilisateurs.
Les compétences couvrent les opérations majeures : le triage de la qualité des données diagnostique les défaillances tout en préservant des garde-fous de production en lecture seule ; la validation du data store analytique compare les données ingestées avec la source de référence ; les compétences d'orchestration inspectent les pipelines et coordonnent les backfills et les jobs de déploiement ; et les compétences de streaming prennent en charge les opérations sur les topics, connecteurs, consumer-groups et schémas. Ces workflows réduisent la dépendance au savoir tacite et aux changements d'interface.
Construire des données gouvernées avec des workflows composables
L'ingénierie analytique a créé une bibliothèque de compétences à quatre niveaux : les orchestrateurs gèrent les workflows de bout en bout, les coordinateurs apportent une expertise métier et des points de contrôle, les compétences fonctionnelles complètent les étapes du cycle de vie, et les compétences primitives exécutent des opérations réutilisables. Cette structure rend la bibliothèque composable et auditable, tout en donnant à chaque analytics engineer une réponse cohérente à deux questions : que dois-je construire, et où cela doit-il vivre ?
L'équipe utilise un workflow connecté : le dbt Author Agent rédige du SQL, du YAML, des tests et de la documentation pour revue humaine ; le PR Review Agent vérifie le changement par rapport aux standards d'ingénierie ; et le Follow-Up Agent traite les avis en attente. Les services Cursor orchestrent ce workflow, tandis qu'une interface Slack permet à l'équipe d'investiguer les erreurs de données sans changer de contexte.
Transformer des données gouvernées en insights et décisions fiables
L'équipe data science a créé un lab pour publier des compétences selon trois niveaux de maturité : experimental pour les brouillons, stable pour les workflows testés, et shared pour l'usage transversal. La promotion nécessite une revue en fonction de l'audience visée.
Les compétences soutiennent la conception d'analyses, le forecasting et la revue du cadrage des questions, tandis que des agents coordonnés soutiennent l'analyse descriptive, le sizing d'opportunités, l'investigation des causes racines, l'analyse de cohortes et l'analyse de tendances. Les garde-fous partagés incluent des définitions catalog-first des champs, filtres et recettes de requêtes ; des freshness gates qui bloquent les workflows obsolètes ou incomplets sauf approbation explicite ; des seuils de matérialité qui se concentrent sur les changements significatifs ; et des vérifications épistémiques qui font remonter les définitions et hypothèses ambiguës. Chaque réponse est étiquetée CONFIRMED ou INFERRED pour rendre sa provenance explicite.
Faire respecter la gouvernance par des contrôles architecturaux
La gouvernance analytique traditionnelle reposait sur un pipeline en couches de données certifiées et de dashboards contrôlés. Les agents peuvent contourner les deux et interroger les données directement, si bien que les garde-fous ne peuvent pas vivre uniquement dans des prompts ou des documents de politique. L'attention d'un agent se répartit entre compétences, connaissances pré-entraînées, documents, contexte de conversation et tables de l'entrepôt concurrentes. La gouvernance doit donc se situer en dehors de la fenêtre de contexte.
Nous avons construit un plan de contrôle agentique qui contraint le chemin avant qu'un agent ne puisse sélectionner une source non gouvernée. Un Enterprise Skills Registry versionne et déploie des compétences gouvernées sur tous les clients IA pris en charge, permettant à la gouvernance de suivre les utilisateurs à travers les interfaces.
Un chemin déterministe vers des réponses gouvernées
Pour revenir à l'exemple du NDR, chaque interaction gouvernée suit quatre étapes qui suppriment des décisions sur lesquelles l'agent pourrait sinon se tromper (voir Figure 2).
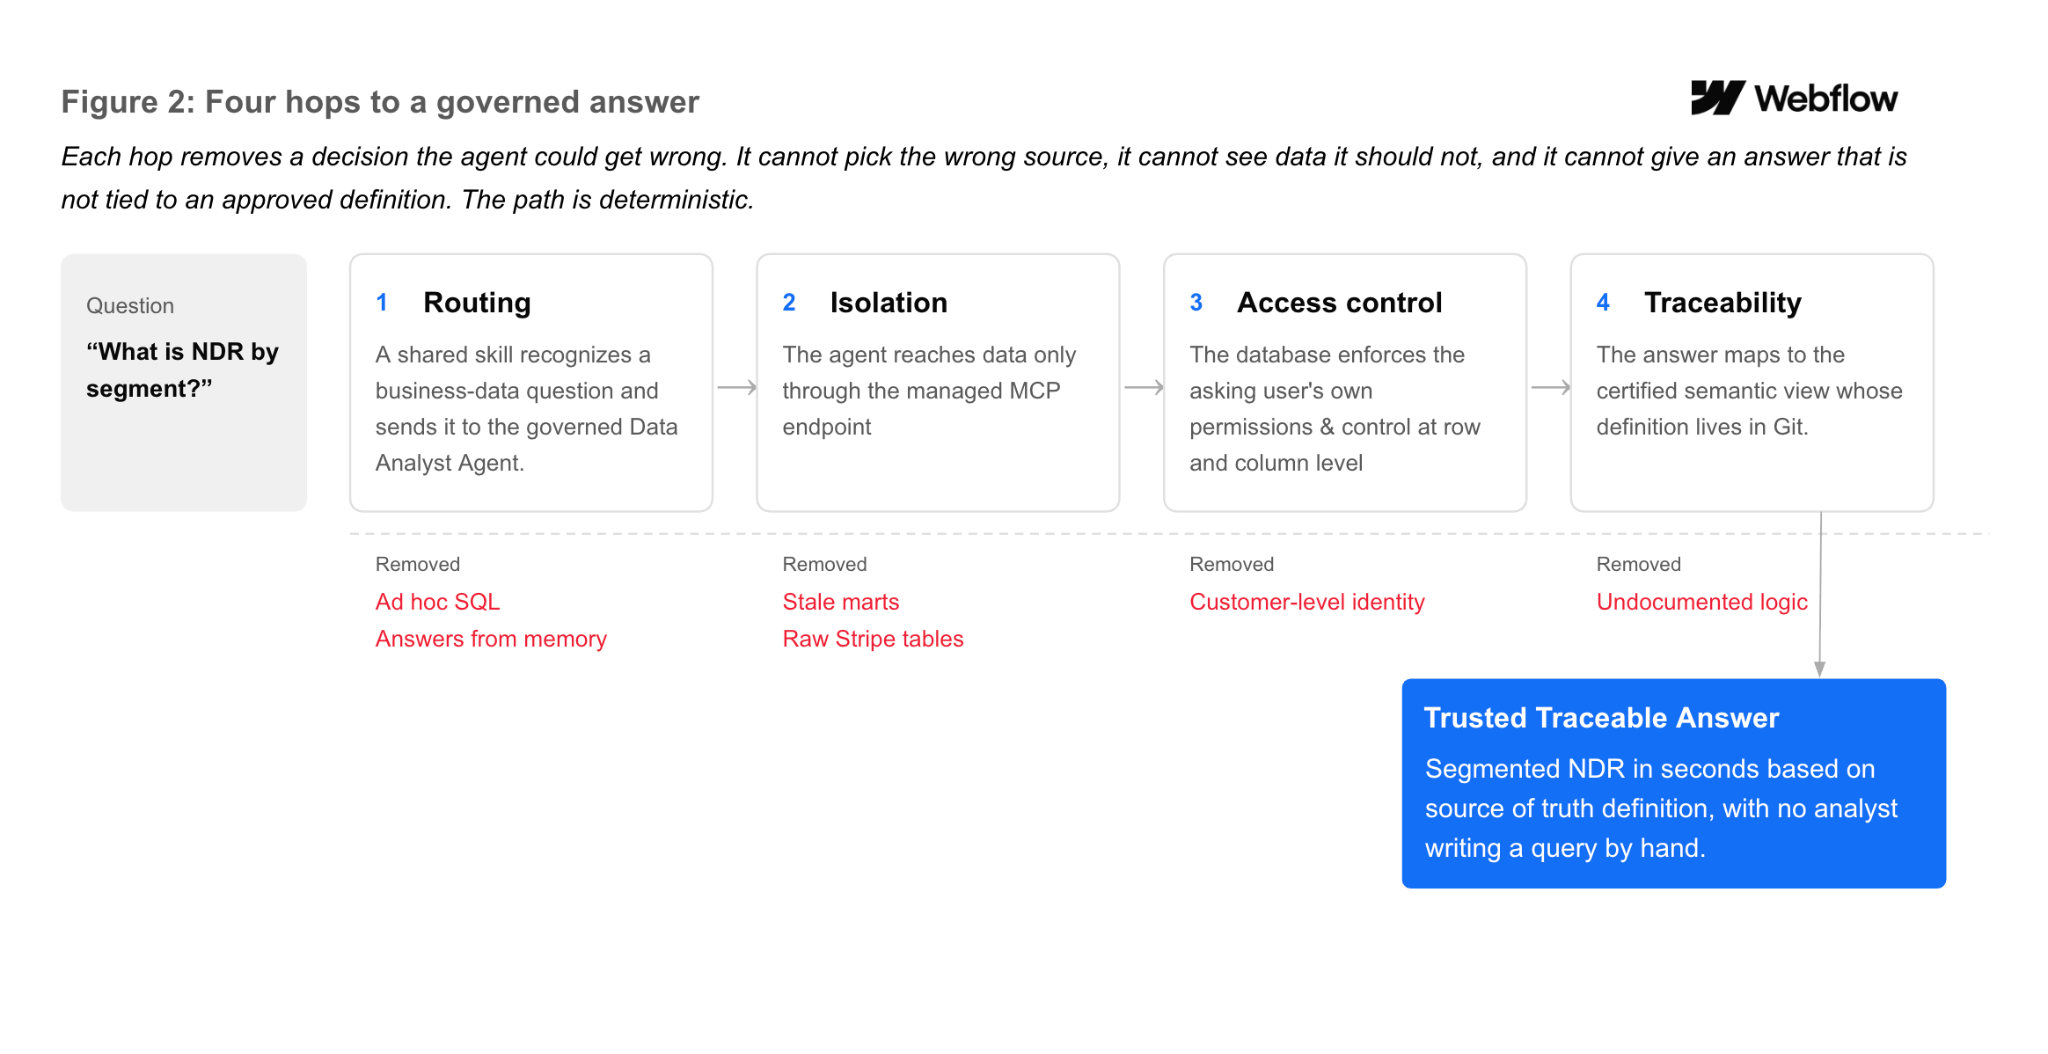
Ces contrôles restreignent les sources disponibles, les définitions de métriques et les permissions, réduisant les décisions à haut risque laissées à l'agent frontend. Ils n'éliminent pas les erreurs, car l'agent doit toujours interpréter l'intention de l'utilisateur, mais ils resserrent les chemins disponibles et rendent les écarts plus faciles à détecter.
Valider le plan de contrôle
Les contrôles architecturaux n'ont d'importance que si les agents et compétences qui les sous-tendent sont testés avant la mise en production et évalués en continu par la suite. Nous avons construit deux systèmes pour soutenir cela.
Avant la mise en production, notre framework d'évaluation de la fiabilité teste les agents et compétences à grande échelle et décide quelles versions atteignent la production. Après la mise en production, le Governor revoit chaque exécution, vérifie si la réponse provient d'une source gouvernée, et rend un verdict « certify » ou « warn ». Cela donne aux utilisateurs un signal de confiance visible pour chaque réponse.
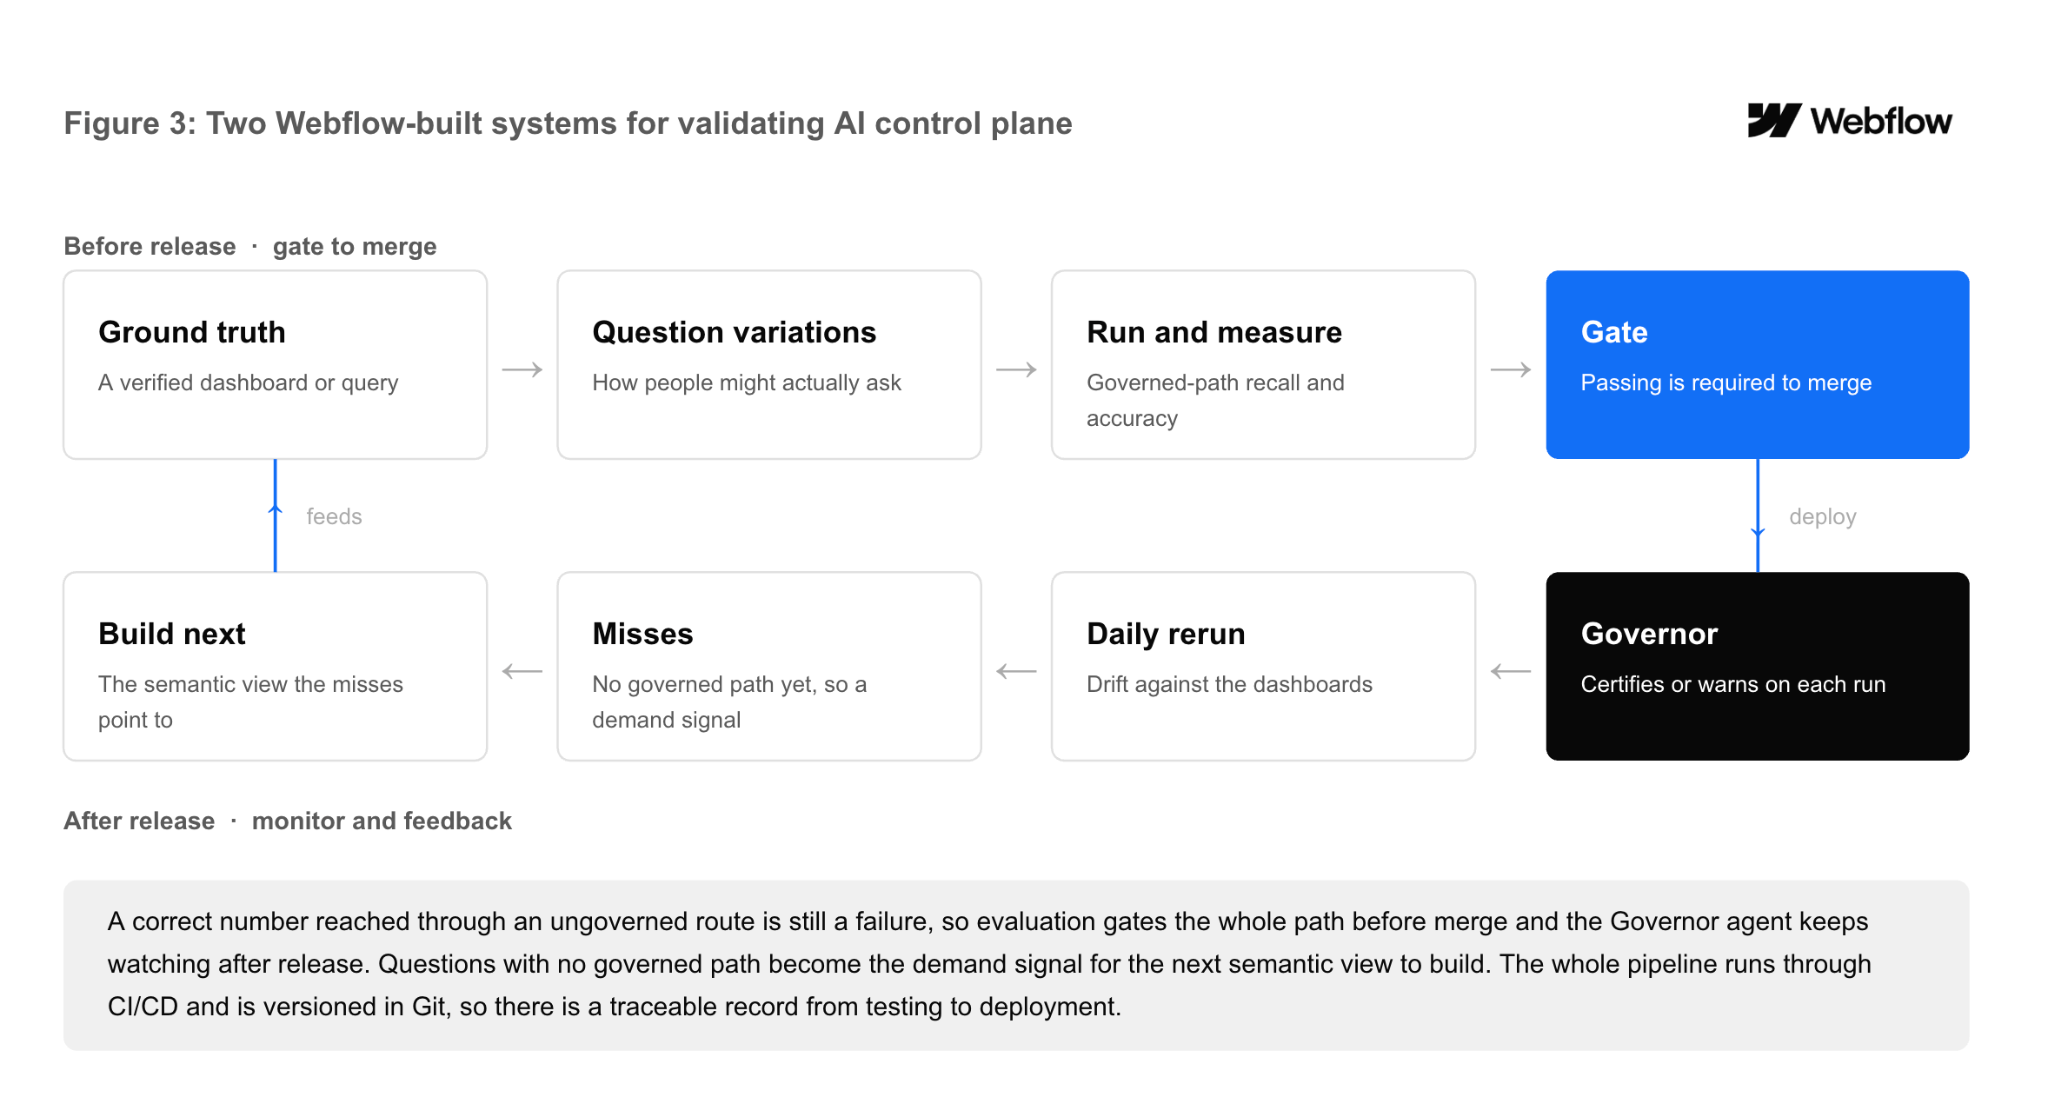
Comme le montre la Figure 3, les constats issus du monitoring en production alimentent le prochain cycle de tests et déterminent ce que nous construisons ensuite, créant ainsi une boucle de feedback continue.
Impact sur l'ensemble du cycle de vie des données
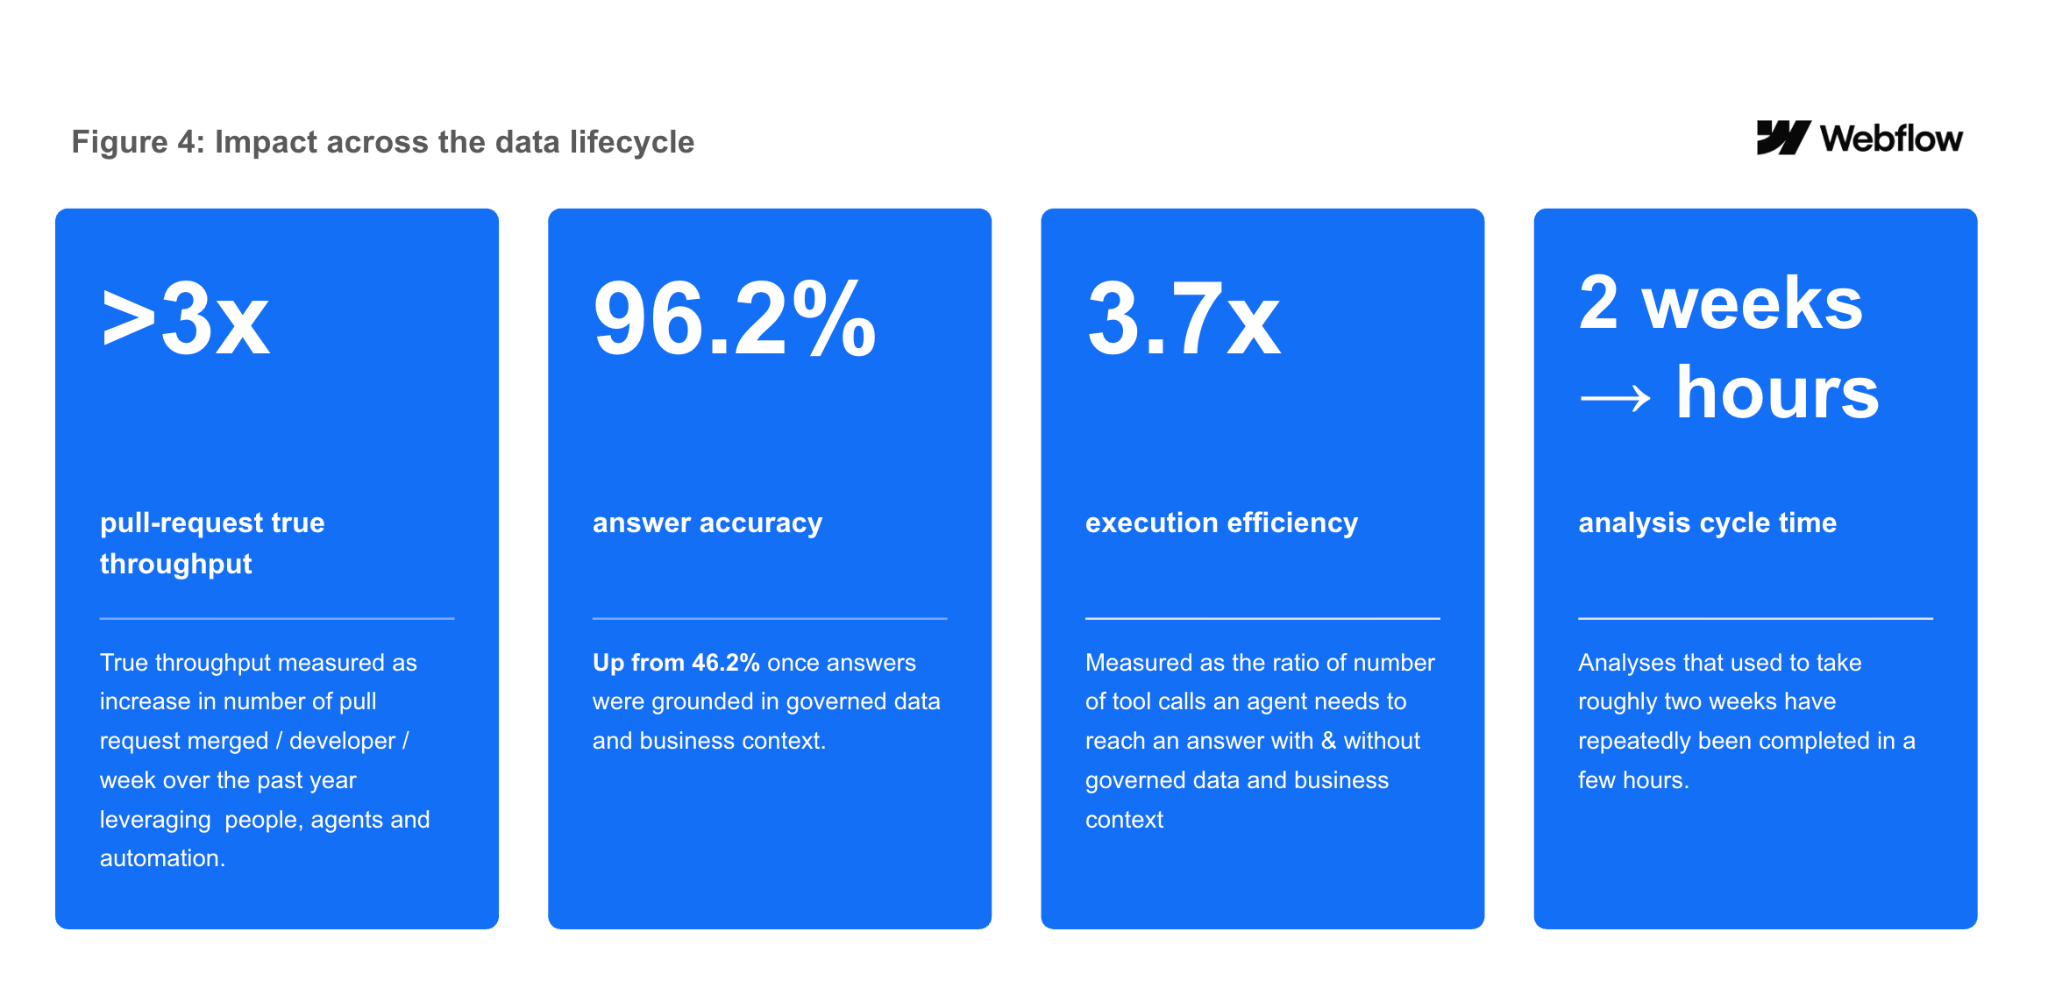
L'impact s'étend aux opérations de l'équipe, à la vitesse de livraison et à l'accès à des réponses fiables à l'échelle de Webflow (voir Figure 4). Ensemble, ces changements font gagner du temps, accélèrent la livraison des actifs et les cycles allant de l'insight à la décision, et améliorent la qualité des décisions, tout en élargissant l'analyse en self-service fiable sans affaiblir la gouvernance.
Une livraison d'ingénierie plus rapide et des opérations de données plus efficaces
Sur l'ensemble de la plateforme de données et de l'ingénierie analytique, le débit réel de pull requests a augmenté de plus de 3 fois au cours de l'année écoulée, reflétant la production combinée des humains, des agents et de l'automatisation. Les agents soutiennent désormais la rédaction, la revue, l'investigation d'incidents et le suivi, tout en préservant l'approbation humaine là où le jugement est requis.
Les agents ont résolu de bout en bout des incidents de qualité de données en production, identifiant les dépendances en aval et ouvrant des pull requests avec diagnostics et correctifs. Un travail qui nécessitait auparavant une investigation manuelle peut désormais être terminé en quelques minutes.
Une vélocité d'analyse accrue et un levier stratégique
Nous avons complété à plusieurs reprises en quelques heures des analyses qui auraient auparavant pris environ deux semaines, tandis que les temps de cycle pour les investigations de métriques et les analyses de causes racines ont également baissé.
Les data scientists disposent désormais de plus de capacité pour un travail stratégique et passent plus de temps à revoir la production des agents, à appliquer leur jugement business et à traduire l'analyse en action. Le rôle évolue : il ne s'agit plus seulement de produire un chiffre exact, mais de recommander ce que l'entreprise devrait faire. Cela a changé notre façon de concevoir les agents : nous nous concentrons sur des workflows qui impliquent les humains là où leur jugement a le plus de valeur, plutôt que d'automatiser une analyse entière en un seul passage.
Un chemin gouverné vers une analyse en self-service fiable
Ces fondations commencent à permettre un accès plus large à des insights gouvernés à l'échelle de Webflow. Notre Data Analyst Agent soutient des métriques gouvernées à travers le produit, la finance et les ventes.
Les premiers utilisateurs peuvent poser des questions via une interface IA familière, tandis que le plan de contrôle oriente chaque question vers des semantic views certifiées, applique des contrôles d'accès, et relie la réponse à une définition approuvée. En élargissant l'accès et la couverture des métriques, nous pouvons livrer des réponses plus rapides sans sacrifier la cohérence, la sécurité ou la traçabilité.
Dans notre jeu d'évaluation interne, ancrer les agents dans un contexte gouverné et des contrôles architecturaux a fait passer la précision des réponses de 46,2 % à 96,2 % et a amélioré l'efficacité d'exécution de 3,7 fois, mesurée par le nombre d'appels d'outils nécessaires pour obtenir une réponse. Anthropic a rapporté une hausse de 21 % à plus de 95 % une fois les workflows analytiques codifiés en compétences réutilisables ; Snowflake a rapporté une hausse de 25 % à 86 % grâce à un meilleur contexte business ; et dbt Labs a rapporté une hausse d'environ 90 % pour le text-to-SQL brut à 98-100 % avec une couche sémantique gouvernée. Bien que ces benchmarks utilisent des méthodologies différentes, ils montrent un schéma cohérent : c'est le contexte business fiable, et non le modèle seul, qui produit des réponses fiables.
Ce que nous avons appris
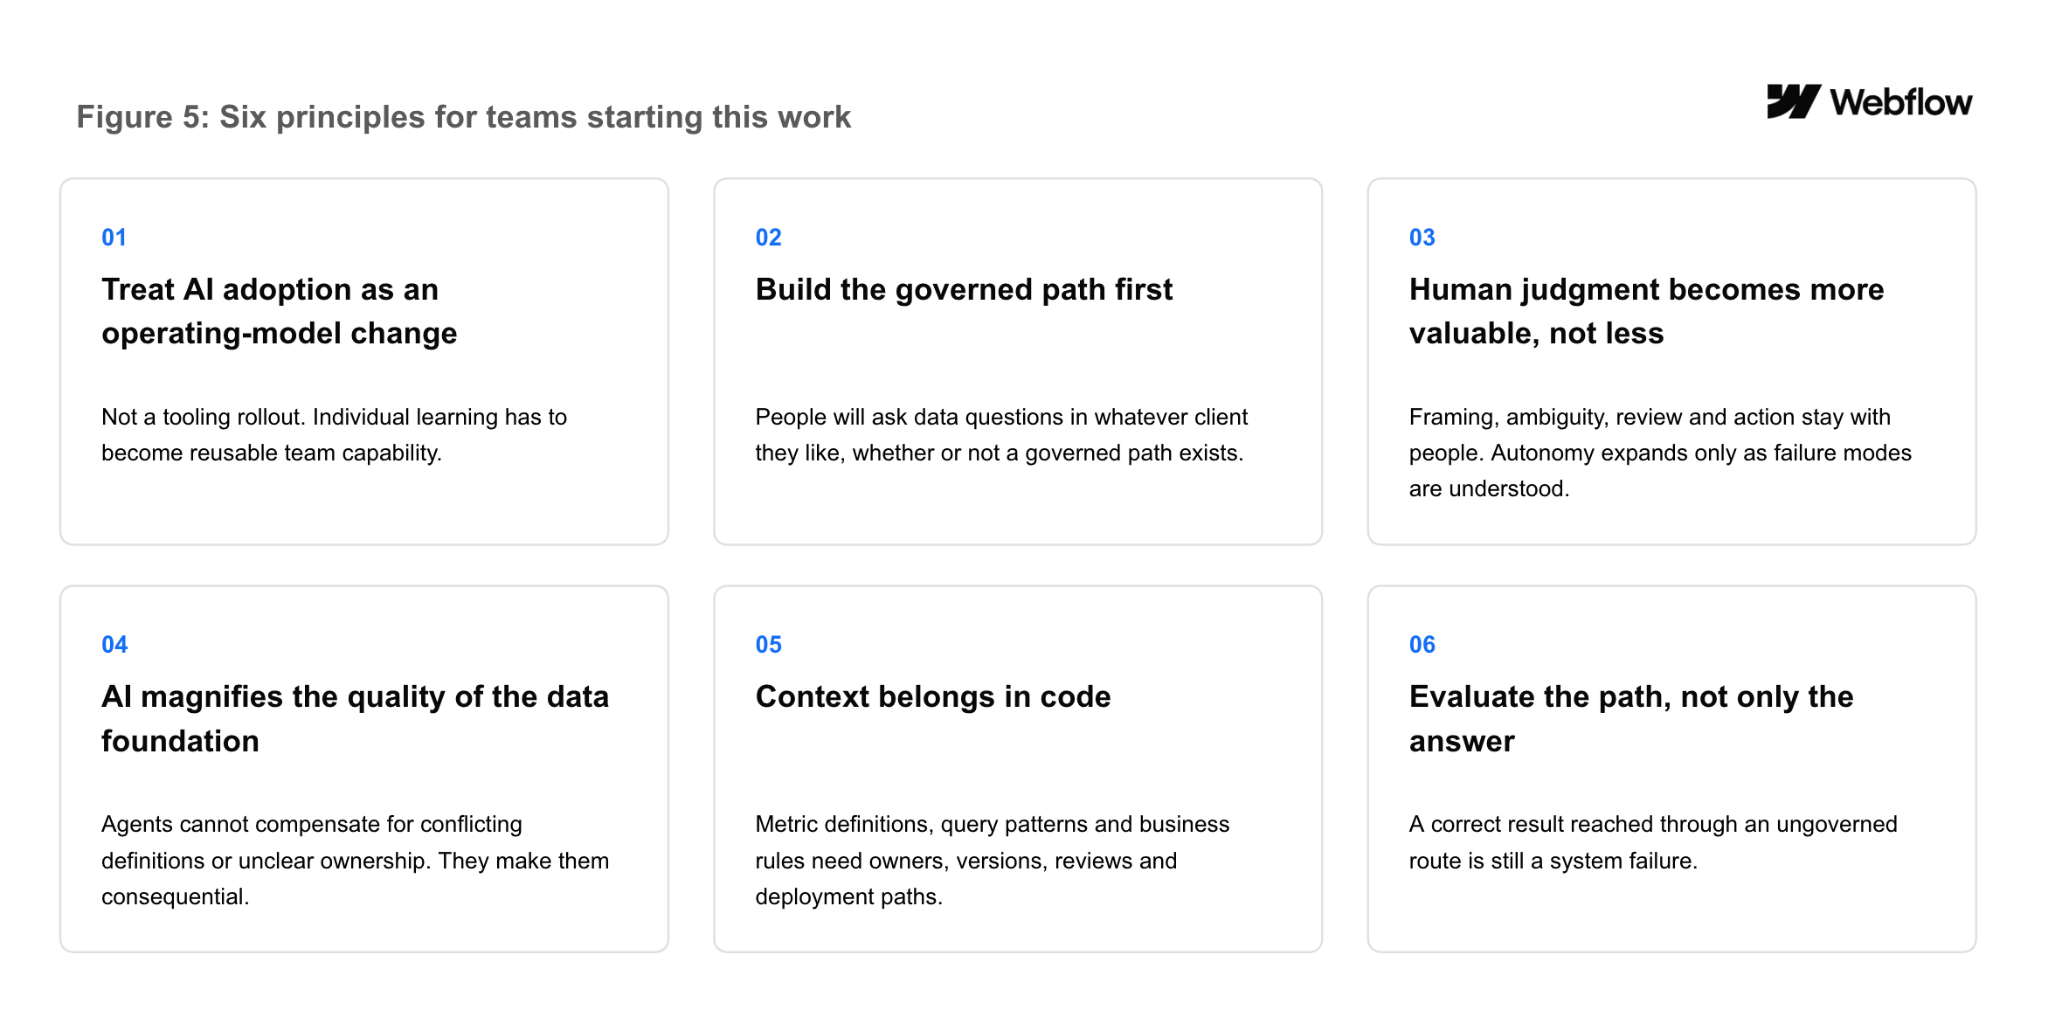
La Figure 5 résume six principes tirés de notre expérience de construction et de mise à l'échelle d'un système d'exploitation Data & Insights natif de l'IA.
Le changement plus large
Nous n'en sommes qu'au début. En élargissant ces capacités, le prochain défi consiste à détecter les réponses plausibles mais incorrectes avant qu'elles n'influencent des décisions. Cela signifie exposer la fraîcheur, la provenance, les hypothèses et le niveau de confiance ; renforcer l'évaluation ; et conserver une revue humaine là où les erreurs ont un coût élevé. Une autre frontière consiste à construire des systèmes analytiques autonomes entièrement en boucle fermée, qui vont de la prise en charge de la question jusqu'à la modélisation dynamique et l'exécution, ancrés dans un sens business dérivé du code, avec une approbation humaine aux points critiques.
En définitive, une équipe Data & Insights native de l'IA ne se définit pas par le nombre d'agents qu'elle construit, mais par le fait que l'IA opère ou non au sein d'un système fiable de données gouvernées, de contexte explicite, de workflows réutilisables, de contrôles architecturaux, de qualité mesurable et de jugement humain. Nous avons commencé en nous demandant comment les agents pourraient nous aider à travailler différemment. Nous construisons aujourd'hui vers un résultat plus large : une analyse en self-service fiable pour davantage de personnes, un chemin plus court entre la question et la décision, et de meilleures décisions sans compromettre la gouvernance. C'est la promesse d'un système d'exploitation Data & Insights natif de l'IA.


















