









Agenten können Antworten generieren; kontrollierte Daten, kodifiziertes Fachwissen und architektonische Kontrollen machen diese Antworten vertrauenswürdig.
Während Webflow die agentenbasierte Web-Marketing-Plattform aufbaut, hat unser Data & Insights-Team denselben KI-first-Ansatz auf interne Entscheidungsprozesse angewendet. Ein Agent kann gültiges SQL schreiben und trotzdem die falsche geschäftliche Antwort liefern. Eine Frage rückte ins Zentrum: Was muss gegeben sein, damit ein Agent Arbeit liefert, der Menschen vertrauen können?
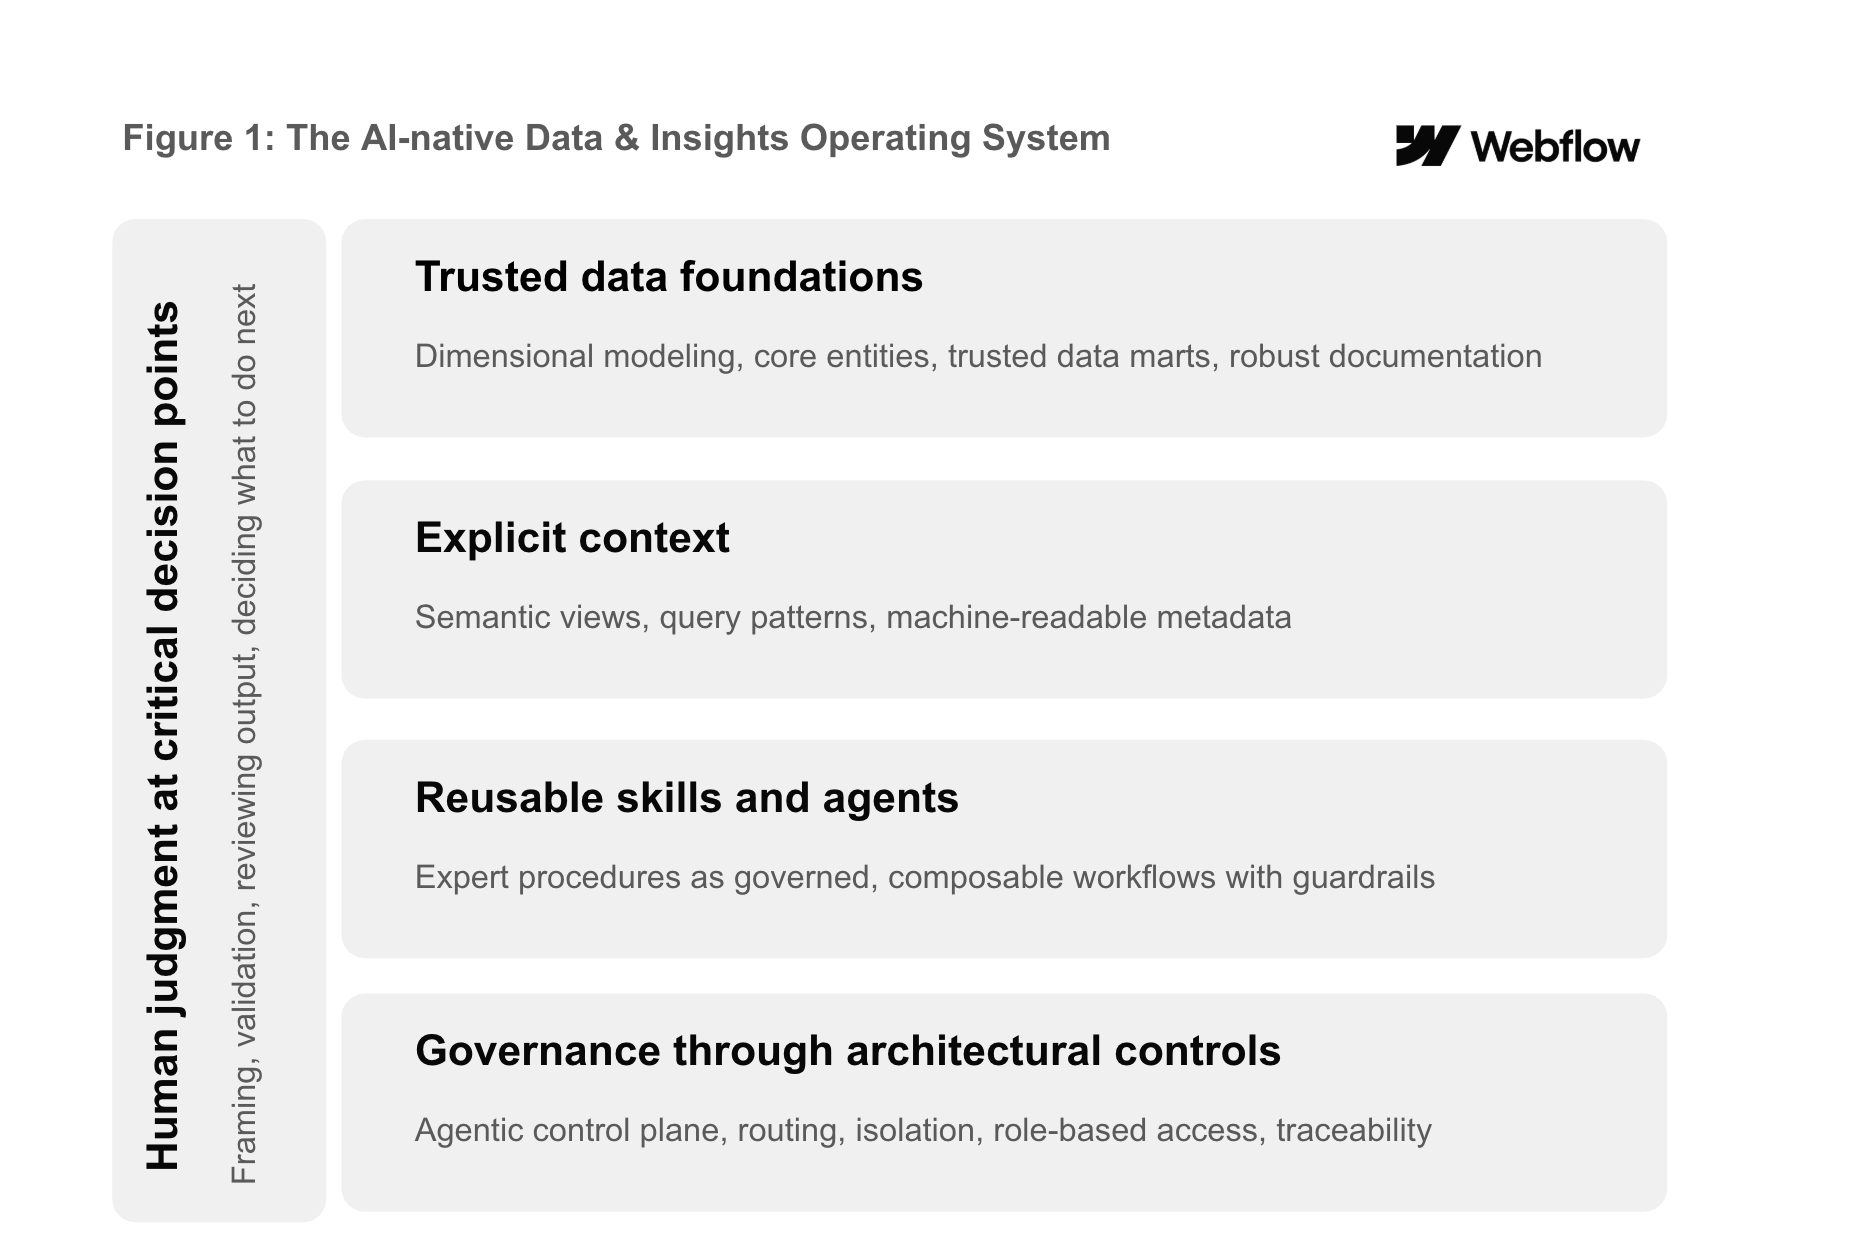
Unser Team umfasst Data Platform Engineering, Analytics Engineering, Business Intelligence und Data Science. Um vertrauenswürdige Self-Service-Analysen aufzubauen, mussten wir zunächst selbst zu wirksamen Nutzern von KI und Erbauern von Agenten werden. Der Einsatz von Agenten in unseren eigenen Workflows zeigte uns, wo sie einen Hebel schufen, wo sie versagten und welchen Kontext, welche Standards, Prüfpunkte und Kontrollen sie brauchten, um verlässlich zu funktionieren. Diese Erfahrung zwang uns außerdem dazu, Fachwissen zu kodifizieren, das zuvor nur in einzelnen Workflows existierte. Wir haben gelernt, dass die KI-Nativität unseres Teams und vertrauenswürdige Self-Service-Analysen für ganz Webflow keine getrennten Transformationen sind. Beide beruhen auf demselben Betriebssystem: kontrollierte Daten, ausführbarer Geschäftskontext, wiederverwendbare Skills und Agenten, architektonische Kontrollen und menschliches Urteilsvermögen.
Eine Abfrage zu generieren ist einfach. Die größere Herausforderung besteht darin, Webflows Geschäftsdefinitionen, freigegebene Quellen, Berechtigungen und Prüferwartungen so zu kodifizieren, dass ein Agent verlässlich arbeiten kann. Ein KI-natives Betriebssystem muss sich mit den geschäftlichen Anforderungen und Arbeitsweisen weiterentwickeln. In diesem Artikel teilen wir, was wir aufgebaut haben, wie es unsere Arbeit verändert hat und welche Wirkung wir beobachten.
Vertrauenswürdige Self-Service-Analysen beginnen mit einem KI-nativen Team
Bevor wir vertrauenswürdige Antworten in großem Maßstab ermöglichen konnten, mussten wir KI zu einem festen Bestandteil der Arbeitsweise unseres eigenen Teams machen. Der Zugang zu einem KI-Assistenten reichte nicht aus. Wir haben eine „Agent First“-Denkweise in den Teamnormen und Karriereerwartungen verankert, Workflows neu gestaltet und Zeit für Lernen und Experimentieren geschützt.
Neue Ideen konnten frei getestet werden, während wiederverwendbare Skills und Kontext in zentralen Repositories abgelegt und nach Reifegrad und Vertrauensstufe organisiert wurden. KI-Champions und wöchentliche Foren halfen dem Team, funktionierende Beispiele zu teilen, wiederkehrende Probleme zu lösen und individuelles Lernen in gemeinsame Teamfähigkeiten zu verwandeln. Dieser Wandel schuf sofortige Effizienzgewinne und gab uns aus erster Hand Erfahrung in der Zusammenarbeit mit Agenten.
Das Team übernahm eine wiederkehrende Frage: Wie könnten wir das mit einem Agenten umsetzen?
Das Betriebssystem
Um vertrauenswürdige Self-Service-Analysen zu skalieren, war ein umfassenderes Betriebssystem erforderlich, das Agenten verlässlich navigieren und Menschen vertrauen konnten.
Beginnen Sie mit vertrauenswürdigen Datengrundlagen
Im letzten Jahrzehnt hat Webflow Hunderte von Quellen, Tabellen und Modellen angesammelt, die für menschliche Expertinnen und Experten gebaut wurden, nicht für Agenten. Die Wahl des richtigen Assets hing oft von implizitem Erfahrungswissen darüber ab, welche Tabellen aktuell waren, wie Kennungen systemübergreifend zugeordnet wurden und welche Definitionen galten. Agenten machten diese Unklarheit folgenreicher. Im vergangenen Jahr haben wir ein mehrere Quartale umfassendes Projekt gestartet, um unser Enterprise Data Warehouse mit Kimball-Dimensionsmodellierung neu aufzubauen. Modulare Star-Schemas standardisieren jetzt Fakten, Dimensionen, Kennungen und Taxonomien in unseren Daten. Kontrollierte Data Marts, ein durchsuchbares Datenwörterbuch und ein automatisierter Katalog-Workflow liefern eine dokumentierte, gemeinsame Quelle der Wahrheit.
Geschäftsorientierte Data Marts mit standardisierten Entitäten aufbauen
Zuvor führten doppelte Entitätslogik, inkonsistentes Mapping von Kennungen und driftende Kennzahlendefinitionen zu widersprüchlichen Ergebnissen zwischen den Teams. Die neue Kernschicht standardisiert sieben Master-Entitäten. Jedes neue Faktenmodell nutzt diese standardisierten Dimensionen, während ein gemeinsamer Kundenschlüssel Self-Serve-Workspaces und Sales-Account-Identitäten für eine konsistente Analyse auf Kundenebene abgleicht.
Auf dieser Kernschicht dienen kontrollierte Data Marts als vertrauenswürdige Abfrageebenen für verschiedene Anwendungsfälle und ersetzen fragmentiertes Reporting durch entscheidungsreife Daten, die genau auf die Arbeitsweise jedes Teams zugeschnitten sind. Ein Customer-360-Mart kombiniert Kunden- und Produktdaten, wobei Signale zur Produktakzeptanz in Salesforce einfließen, um Field-Teams bei Upgrades, Retention und Expansion zu unterstützen. Ein ARR-Mart liefert abgestimmtes Reporting zu wiederkehrenden Umsätzen und Net Dollar Retention nach Kunde, Abonnement und Produkt. Weitere kontrollierte Marts decken Produktakzeptanz, Customer Journeys, Marketing-Funnels, Pipeline und Bookings, KI-Credits, Seat-Auslastung und Site-Nutzung ab.
Verlässlichkeit in die Grundlage einbauen
Eine vertrauenswürdige Datengrundlage kann sich nicht darauf verlassen, dass Menschen oder Agenten sich merken, welche Quellen, Definitionen und Standards zu verwenden sind. Wir kodifizieren diese Kontrollen direkt in der Grundlage.
Modellierungsstandards, semantische Definitionen und Referenzdokumentation liegen gemeinsam in einem versionskontrollierten Repository, während Tooling Agenten zunächst zu vertrauenswürdigen Modellen leitet. Der PR Review Agent prüft jede dbt-Änderung auf architektonische Verstöße, Namensdrift, fehlende Tests, PII-Exposition und Abhängigkeiten von nicht zertifizierten Assets. Nachgelagerte Arbeit muss auf der vertrauenswürdigen Schicht aufbauen, wobei Tests unbeabsichtigte Auswirkungen erkennen, bevor Änderungen gemergt werden. Das Ziel ist, den richtigen Weg für Menschen und Agenten gleichermaßen zum einfachsten Weg zu machen.
Geschäftskontext ausführbar machen
Ein kontrolliertes Warehouse ist notwendig, aber nicht ausreichend. Agenten müssen auch verstehen, was Webflow unter „ARR“, „Kunde“ oder „Seat-Auslastung“ versteht und wie diese Konzepte auf Daten abgebildet werden. Wir haben kontrollierte Kontext-Assets geschaffen, um diese Definitionen explizit und für Agenten nutzbar zu machen.
Semantic Views
Semantic Views fungieren als Vertrag zwischen Geschäftssprache und kontrollierten Daten. Sie kodifizieren freigegebene Kennzahlen, Dimensionen, Beziehungen und Terminologie als versionskontrollierten Code und ermöglichen es KI-Clients und nachgelagerten Workflows, dieselben Berechnungen zu verwenden. Zusammen mit Warehouse-Modellen und Metadaten bilden sie eine maschinenlesbare Kontextschicht, sodass Geschäftslogik nicht nur in Dashboards oder im Gedächtnis von Menschen existiert. Agenten können sich auf diese zentral gepflegten Definitionen verlassen, statt Bedeutung aus Tabellen- und Spaltennamen abzuleiten.
Fragen wie „Wie hoch ist die NDR nach Segment?“ lassen sich nun aus einer validierten Kennzahlendefinition beantworten statt aus einmaligem SQL. Unser Semantic View Author Agent unterstützt dabei, Snowflake-Semantic-Views in großem Maßstab zu erstellen, während Menschen die Verantwortung für die Definitionen behalten.
Abfragemuster und Geschäftskontext
Wir kodifizieren wiederkehrende Analysen als domänenspezifische Muster, die Granularität, Filter, Annahmen und bekannte Fehlermodi definieren, ausgehend von geprüfter Logik, statt den Ansatz jedes Mal neu zu konstruieren. Ein maschinenlesbares Repository organisiert Data-Science-Metadaten, organisatorischen Kontext und analytische Arbeit für Agenten und schafft so einen Weg von individueller Erkenntnis zu geteiltem institutionellem Wissen.
Expertenworkflows als Skills und Agenten kodifizieren
Während semantische Definitionen die geschäftliche Bedeutung klären, steuern Skills die Ausführung. Unsere größte Investition bestand darin, Webflows analytische Verfahren und Prüfstandards in wiederholbare Workflows zu kodifizieren, die zulässige Quellen und Tools, Ausführungsschritte, Validierungsanforderungen, menschliche Prüfung, den Umgang mit Ambiguität und Nachweise definieren. Jede Disziplin wendet diesen Ansatz auf ihre eigene Arbeit an.
Die Datenplattform mit wiederverwendbarem Fachwissen betreiben
Die Arbeit an der Datenplattform umfasst Produktionssysteme, Repositories und Fehlermodi und erfordert oft verteiltes Fachwissen. Wir haben einen Plugin-Marktplatz geschaffen, um dieses Fachwissen zu erstellen, zu versionieren, zu installieren und zu teilen, mit automatischen Updates für die Nutzenden.
Skills decken zentrale Operationen ab: Data-Quality-Triage diagnostiziert Fehler unter Beibehaltung schreibgeschützter Produktions-Schutzmaßnahmen; Analytics-Store-Validierung vergleicht eingelesene Daten mit dem Source of Record; Orchestrierungs-Skills prüfen Pipelines und koordinieren Backfills und Deployment-Jobs; und Streaming-Skills unterstützen Operationen an Topics, Connectors, Consumer-Groups und Schemas. Diese Workflows verringern die Abhängigkeit von implizitem Erfahrungswissen und häufigem Wechseln zwischen Oberflächen.
Kontrollierte Daten mit komponierbaren Workflows aufbauen
Analytics Engineering hat eine vierstufige Skills-Bibliothek geschaffen: Orchestratoren steuern End-to-End-Workflows, Koordinatoren liefern Fachwissen und Kontrollpunkte, funktionale Skills erledigen Lifecycle-Schritte, und primitive Skills führen wiederverwendbare Operationen aus. Diese Struktur macht die Bibliothek komponierbar und auditierbar und gibt jedem Analytics Engineer konsistente Antworten auf zwei Fragen: Was sollte ich bauen, und wo sollte es liegen?
Das Team nutzt einen verbundenen Workflow: Der dbt Author Agent erstellt Entwürfe für SQL, YAML, Tests und Dokumentation zur menschlichen Prüfung; der PR Review Agent prüft die Änderung gegen Engineering-Standards; und der Follow-Up Agent kümmert sich um aufgeschobene Hinweise. Cursor-Services orchestrieren diesen Workflow, während eine Slack-Oberfläche dem Team erlaubt, Datenfehler zu untersuchen, ohne den Kontext zu wechseln.
Kontrollierte Daten in vertrauenswürdige Insights und Entscheidungen verwandeln
Das Data-Science-Team hat ein Lab für die Veröffentlichung von Skills auf drei Reifegraden geschaffen: experimental für Entwürfe, stable für getestete Workflows und shared für die funktionsübergreifende Nutzung. Die Höherstufung erfordert eine Prüfung, die sich an der vorgesehenen Zielgruppe orientiert.
Skills unterstützen Analysedesign, Forecasting und die Prüfung von Fragestellungen, während koordinierte Agenten deskriptive Analyse, Opportunity Sizing, Root-Cause-Untersuchungen, Kohortenanalyse und Trendanalyse unterstützen. Gemeinsame Leitplanken umfassen katalogbasierte Definitionen von Feldern, Filtern und Query-Rezepten; Freshness Gates, die veraltete oder unvollständige Workflows stoppen, sofern nicht ausdrücklich freigegeben; Materialitätsschwellen, die sich auf bedeutsame Veränderungen konzentrieren; und epistemische Prüfungen, die mehrdeutige Definitionen und Annahmen sichtbar machen. Jede Antwort wird als CONFIRMED oder INFERRED gekennzeichnet, um ihre Herkunft explizit zu machen.
Governance durch architektonische Kontrollen durchsetzen
Traditionelle Analytics-Governance beruhte auf einer mehrstufigen Pipeline aus zertifizierten Daten und kontrollierten Dashboards. Agenten können beides umgehen und Daten direkt abfragen, weshalb Leitplanken nicht allein in Prompts oder Richtliniendokumenten existieren können. Die Aufmerksamkeit eines Agenten verteilt sich auf Skills, vortrainiertes Wissen, Dokumente, Konversationskontext und konkurrierende Warehouse-Tabellen. Governance muss deshalb außerhalb des Kontextfensters verankert sein.
Wir haben eine agentenbasierte Control Plane gebaut, die den Weg einschränkt, bevor ein Agent eine nicht kontrollierte Quelle auswählen kann. Eine Enterprise Skills Registry versioniert und verteilt kontrollierte Skills über alle unterstützten KI-Clients hinweg, sodass Governance den Nutzenden über verschiedene Oberflächen hinweg folgt.
Ein deterministischer Weg zu kontrollierten Antworten
Zurück zum NDR-Beispiel: Jede kontrollierte Interaktion folgt vier Schritten, die Entscheidungen entfernen, bei denen der Agent sonst falsch liegen könnte (siehe Abbildung 2).
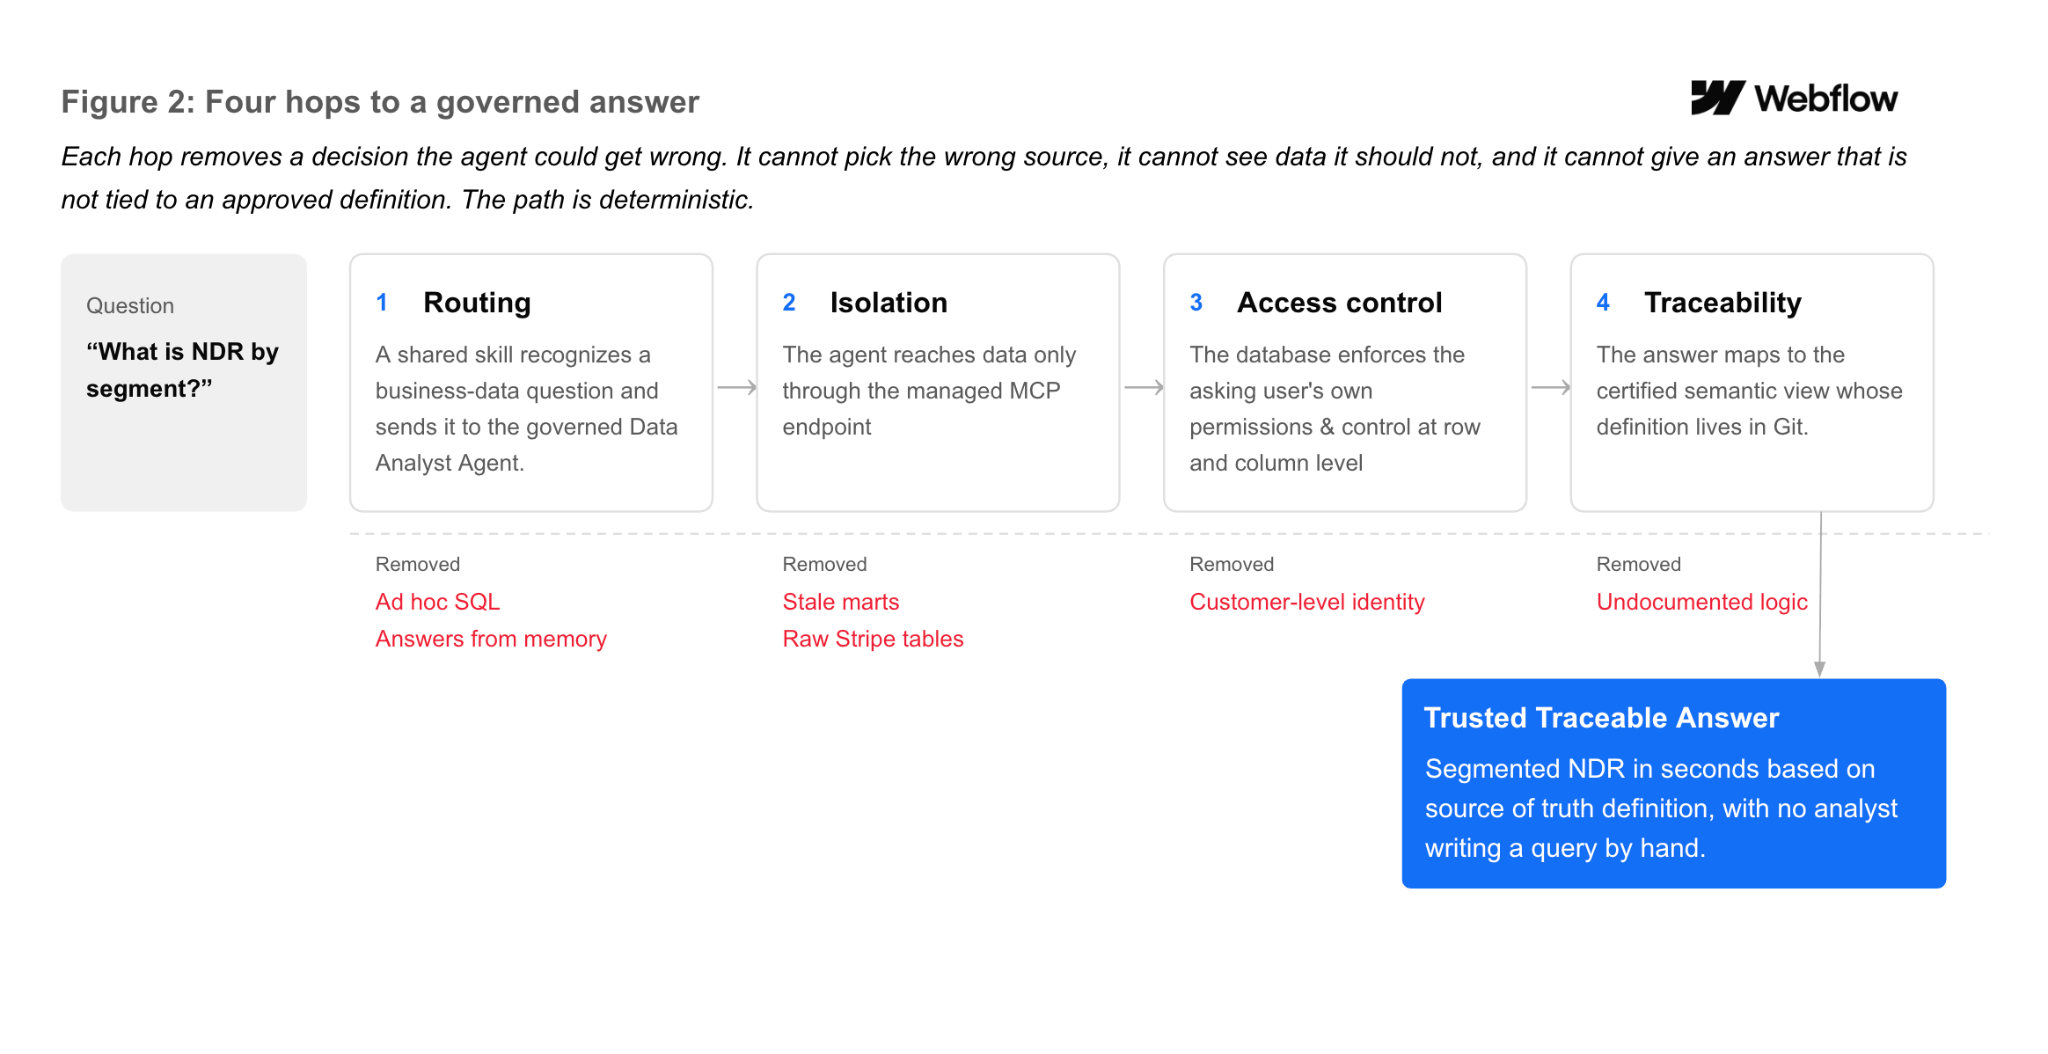
Diese Kontrollen schränken verfügbare Quellen, Kennzahlendefinitionen und Berechtigungen ein und reduzieren die risikobehafteten Entscheidungen, die dem Frontend-Agenten überlassen bleiben. Sie schließen Fehler nicht vollständig aus, da der Agent weiterhin die Nutzerabsicht interpretieren muss, aber sie verengen die verfügbaren Pfade und machen Abweichungen leichter erkennbar.
Die Control Plane validieren
Architektonische Kontrollen sind nur dann wirksam, wenn die dahinterliegenden Agenten und Skills vor der Veröffentlichung getestet und danach fortlaufend evaluiert werden. Wir haben zwei Systeme gebaut, um dies zu unterstützen.
Vor der Veröffentlichung testet unser Reliability-Evaluierungs-Framework Agenten und Skills in großem Maßstab und entscheidet, welche Versionen in Produktion gehen. Nach der Veröffentlichung prüft der Governor jeden Lauf, verifiziert, ob die Antwort aus einer kontrollierten Quelle stammt, und gibt ein „certify“- oder „warn“-Urteil ab. Das gibt den Nutzenden ein sichtbares Vertrauenssignal für jede Antwort.
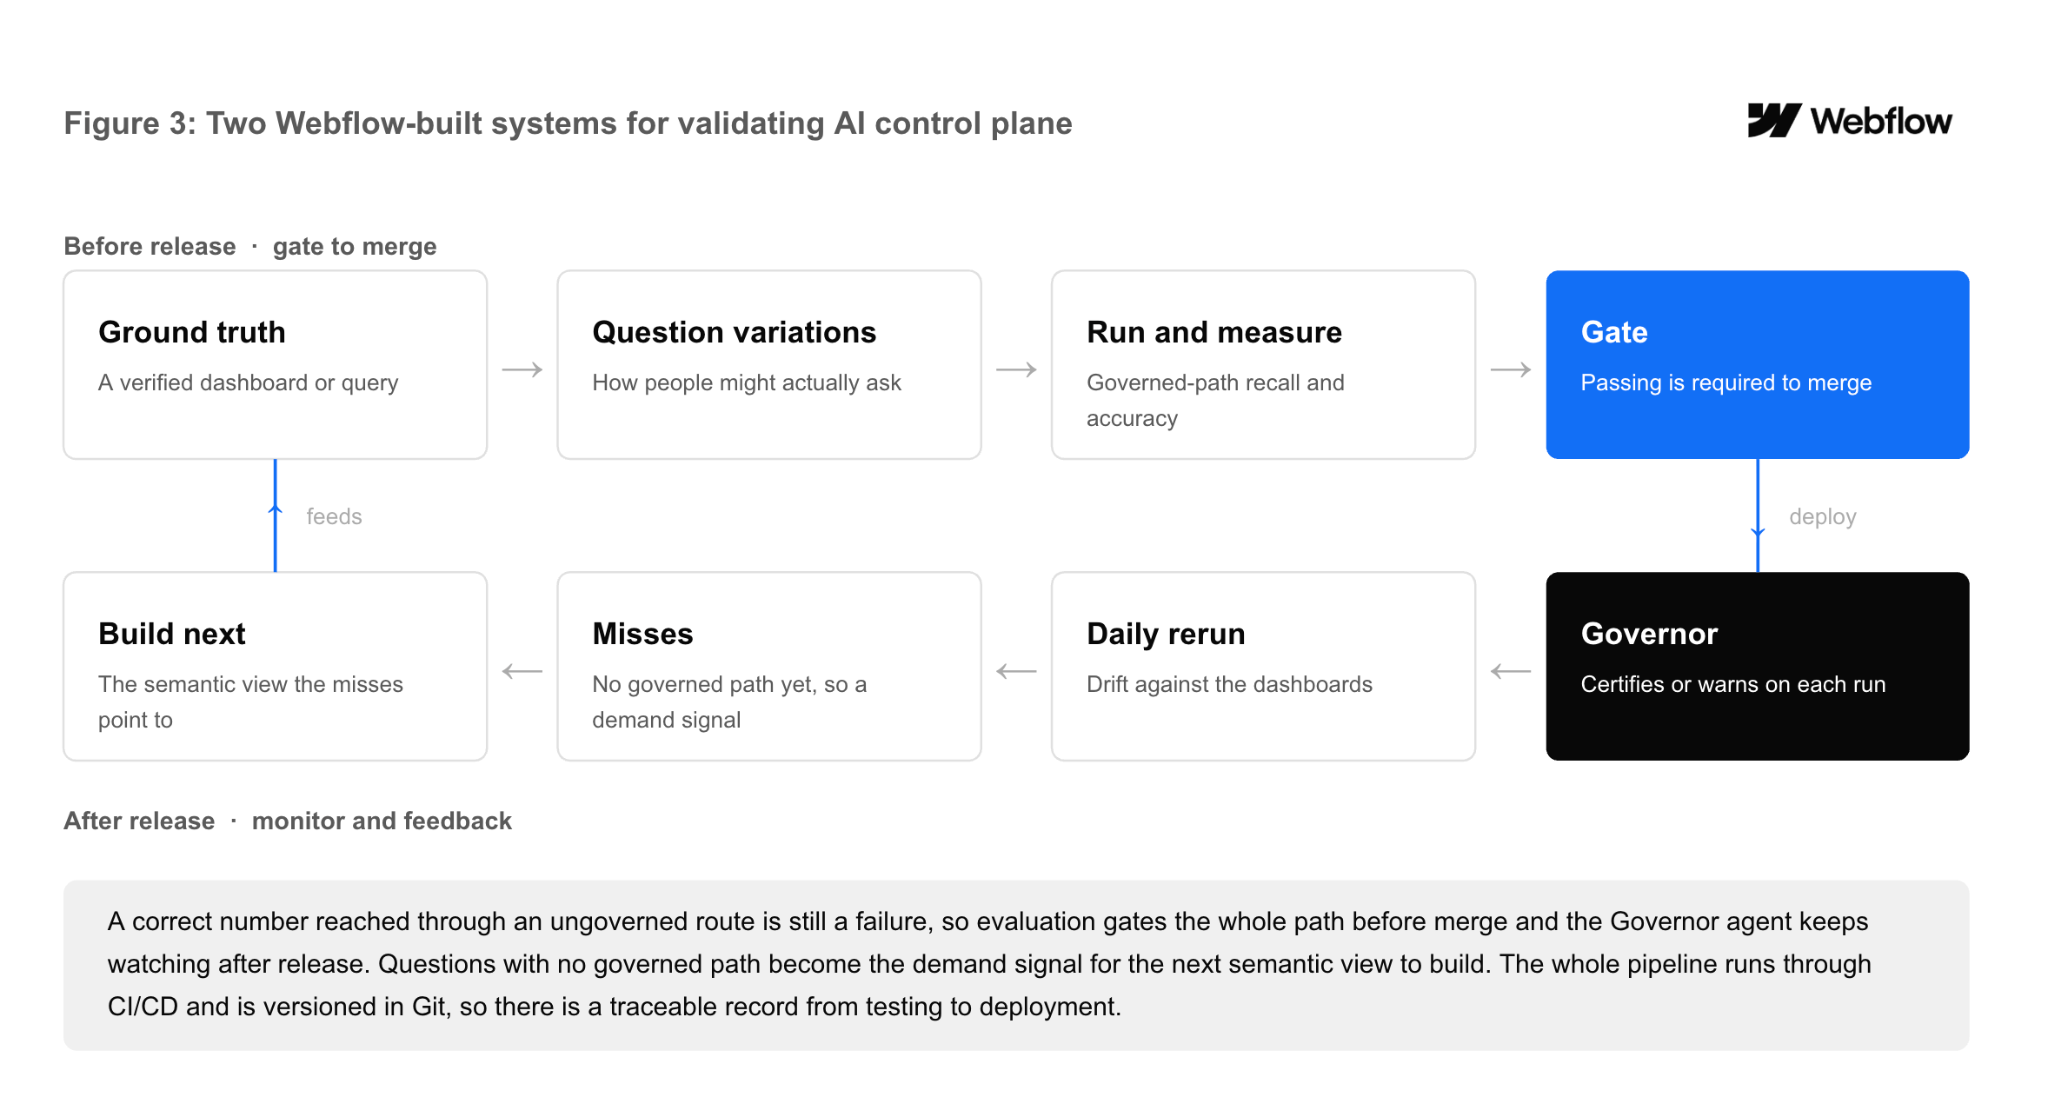
Wie Abbildung 3 zeigt, fließen Erkenntnisse aus dem Produktionsmonitoring in die nächste Testrunde ein und bestimmen, was wir als Nächstes bauen – so entsteht eine kontinuierliche Feedback-Schleife.
Wirkung über den gesamten Daten-Lifecycle
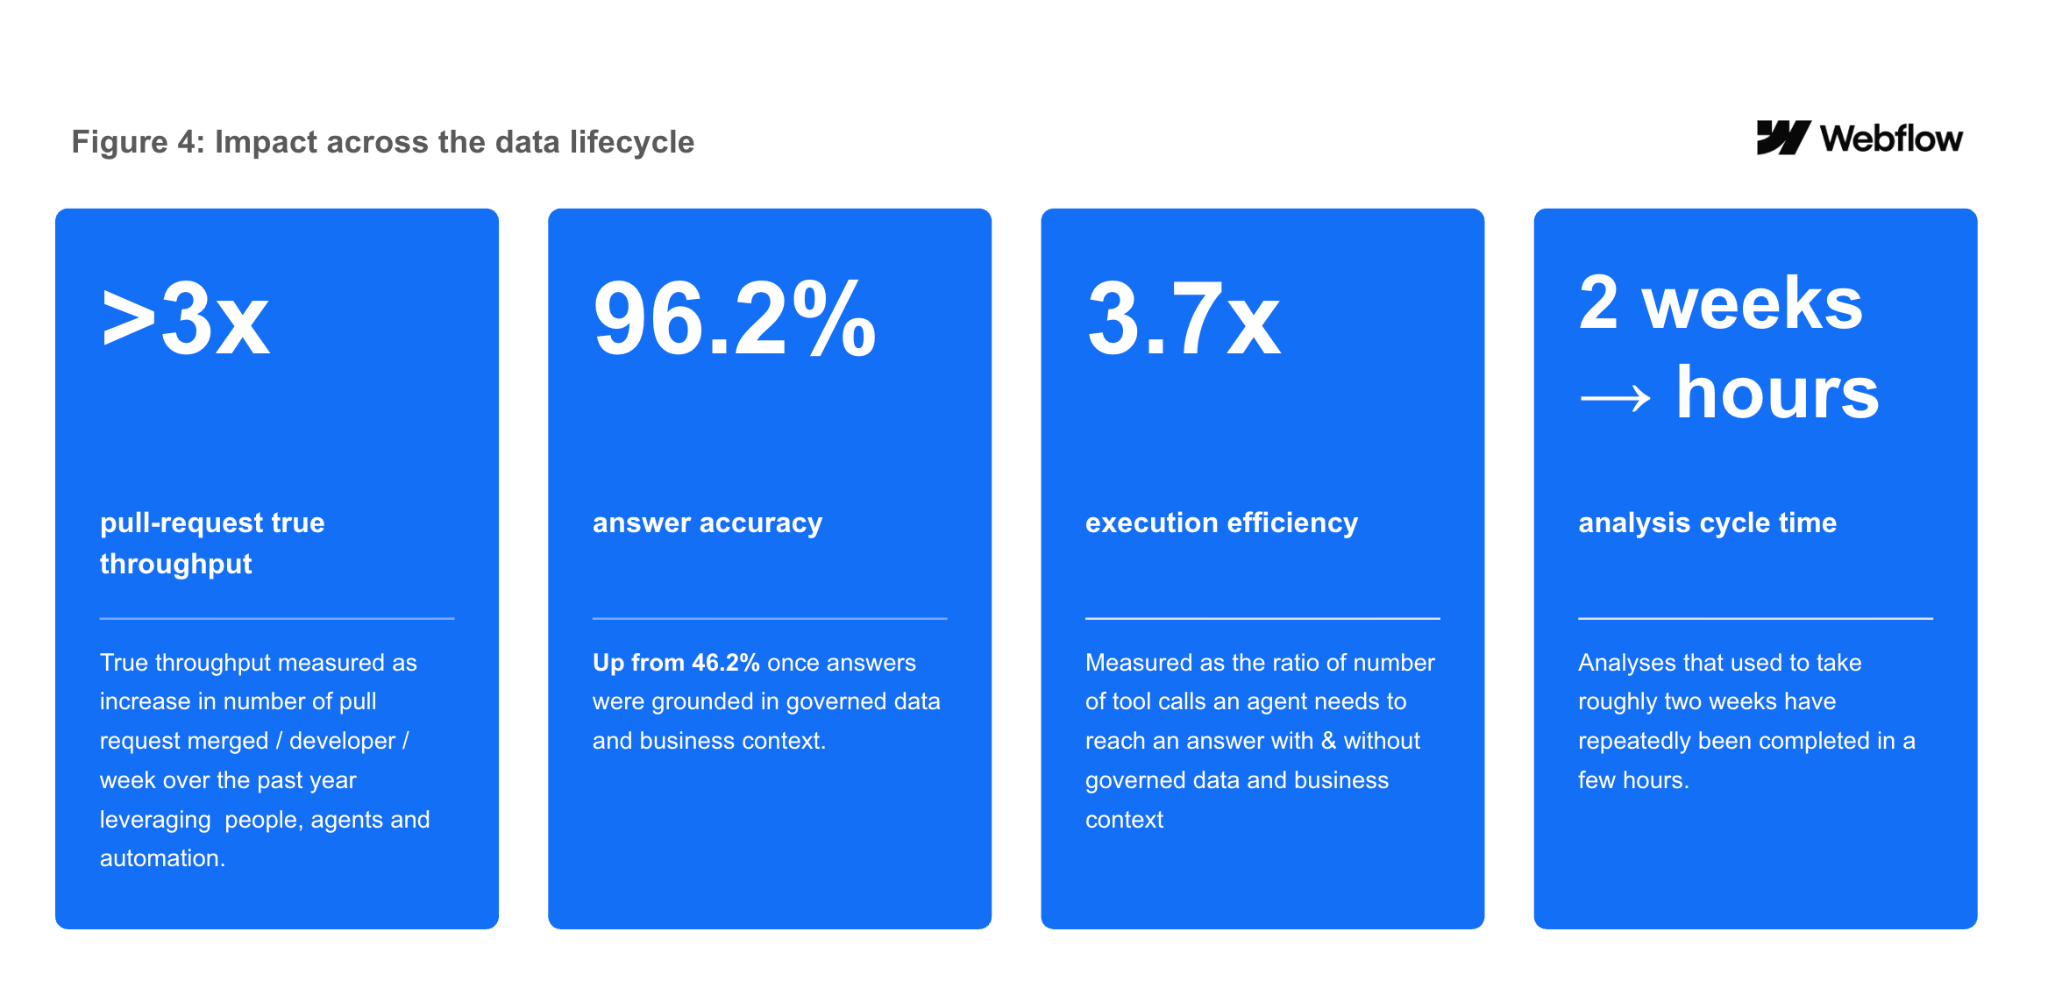
Die Wirkung erstreckt sich über den Teambetrieb, die Liefergeschwindigkeit und den Zugang zu vertrauenswürdigen Antworten in ganz Webflow (siehe Abbildung 4). Zusammen sparen diese Veränderungen Zeit, beschleunigen die Auslieferung von Assets und die Zyklen von Erkenntnis zu Entscheidung und verbessern die Entscheidungsqualität, während vertrauenswürdige Self-Service-Analysen ausgeweitet werden, ohne die Governance zu schwächen.
Schnellere Engineering-Auslieferung und effizientere Datenoperationen
Über Data Platform und Analytics Engineering hinweg ist der echte Pull-Request-Durchsatz im vergangenen Jahr um mehr als das 3-Fache gestiegen – ein Ausdruck der kombinierten Leistung von Menschen, Agenten und Automatisierung. Agenten unterstützen inzwischen das Verfassen, die Prüfung, die Untersuchung von Incidents und das Follow-up, wobei die menschliche Freigabe dort erhalten bleibt, wo Urteilsvermögen gefragt ist.
Agenten haben Datenqualitäts-Incidents in Produktion end-to-end gelöst, nachgelagerte Abhängigkeiten identifiziert und Pull Requests mit Diagnosen und Fixes eröffnet. Arbeit, die früher eine manuelle Untersuchung erforderte, lässt sich heute in wenigen Minuten abschließen.
Höhere Analysegeschwindigkeit und strategischer Hebel
Wir haben wiederholt Analysen in wenigen Stunden abgeschlossen, die zuvor rund zwei Wochen gedauert hätten, während auch die Zykluszeiten für Kennzahlenuntersuchungen und Root-Cause-Analysen gesunken sind.
Data Scientists haben nun mehr Kapazität für strategische Arbeit und verbringen mehr Zeit damit, Agenten-Output zu prüfen, geschäftliches Urteilsvermögen anzuwenden und Analysen in Handlungen zu übersetzen. Die Rolle verschiebt sich davon, eine korrekte Zahl zu liefern, hin zu einer Empfehlung, was das Unternehmen tun sollte. Das hat verändert, wie wir Agenten gestalten: Wir konzentrieren uns auf Workflows, die Menschen dort einbeziehen, wo ihr Urteilsvermögen am wertvollsten ist, statt eine gesamte Analyse in einem Durchgang zu automatisieren.
Ein kontrollierter Weg zu vertrauenswürdigen Self-Service-Analysen
Diese Grundlagen ermöglichen nun zunehmend einen breiteren Zugang zu kontrollierten Insights in ganz Webflow. Unser Data Analyst Agent unterstützt kontrollierte Kennzahlen über Produkt, Finance und Sales hinweg.
Frühe Nutzende können Fragen über eine vertraute KI-Oberfläche stellen, während die Control Plane jede Frage an zertifizierte Semantic Views weiterleitet, Zugriffskontrollen anwendet und die Antwort mit einer freigegebenen Definition verknüpft. Mit der Erweiterung von Zugang und Kennzahlenabdeckung können wir schnellere Antworten liefern, ohne Konsistenz, Sicherheit oder Nachvollziehbarkeit zu opfern.
In unserem internen Evaluierungs-Set steigerte die Verankerung von Agenten in kontrolliertem Kontext und architektonischen Kontrollen die Antwortgenauigkeit von 46,2 % auf 96,2 % und verbesserte die Ausführungseffizienz um das 3,7-Fache, gemessen an der Anzahl der Tool-Calls, die für eine Antwort benötigt wurden. Anthropic berichtete von einer Steigerung von 21 % auf mehr als 95 %, nachdem analytische Workflows als wiederverwendbare Skills kodifiziert wurden; Snowflake berichtete von einer Steigerung von 25 % auf 86 % durch verbesserten Geschäftskontext; und dbt Labs berichtete von einer Steigerung von rund 90 % bei reinem Text-zu-SQL auf 98–100 % mit einer kontrollierten Semantic Layer. Diese Benchmarks nutzen zwar unterschiedliche Methodiken, zeigen aber ein einheitliches Muster: vertrauenswürdiger Geschäftskontext – nicht das Modell allein – treibt verlässliche Antworten an.
Was wir gelernt haben
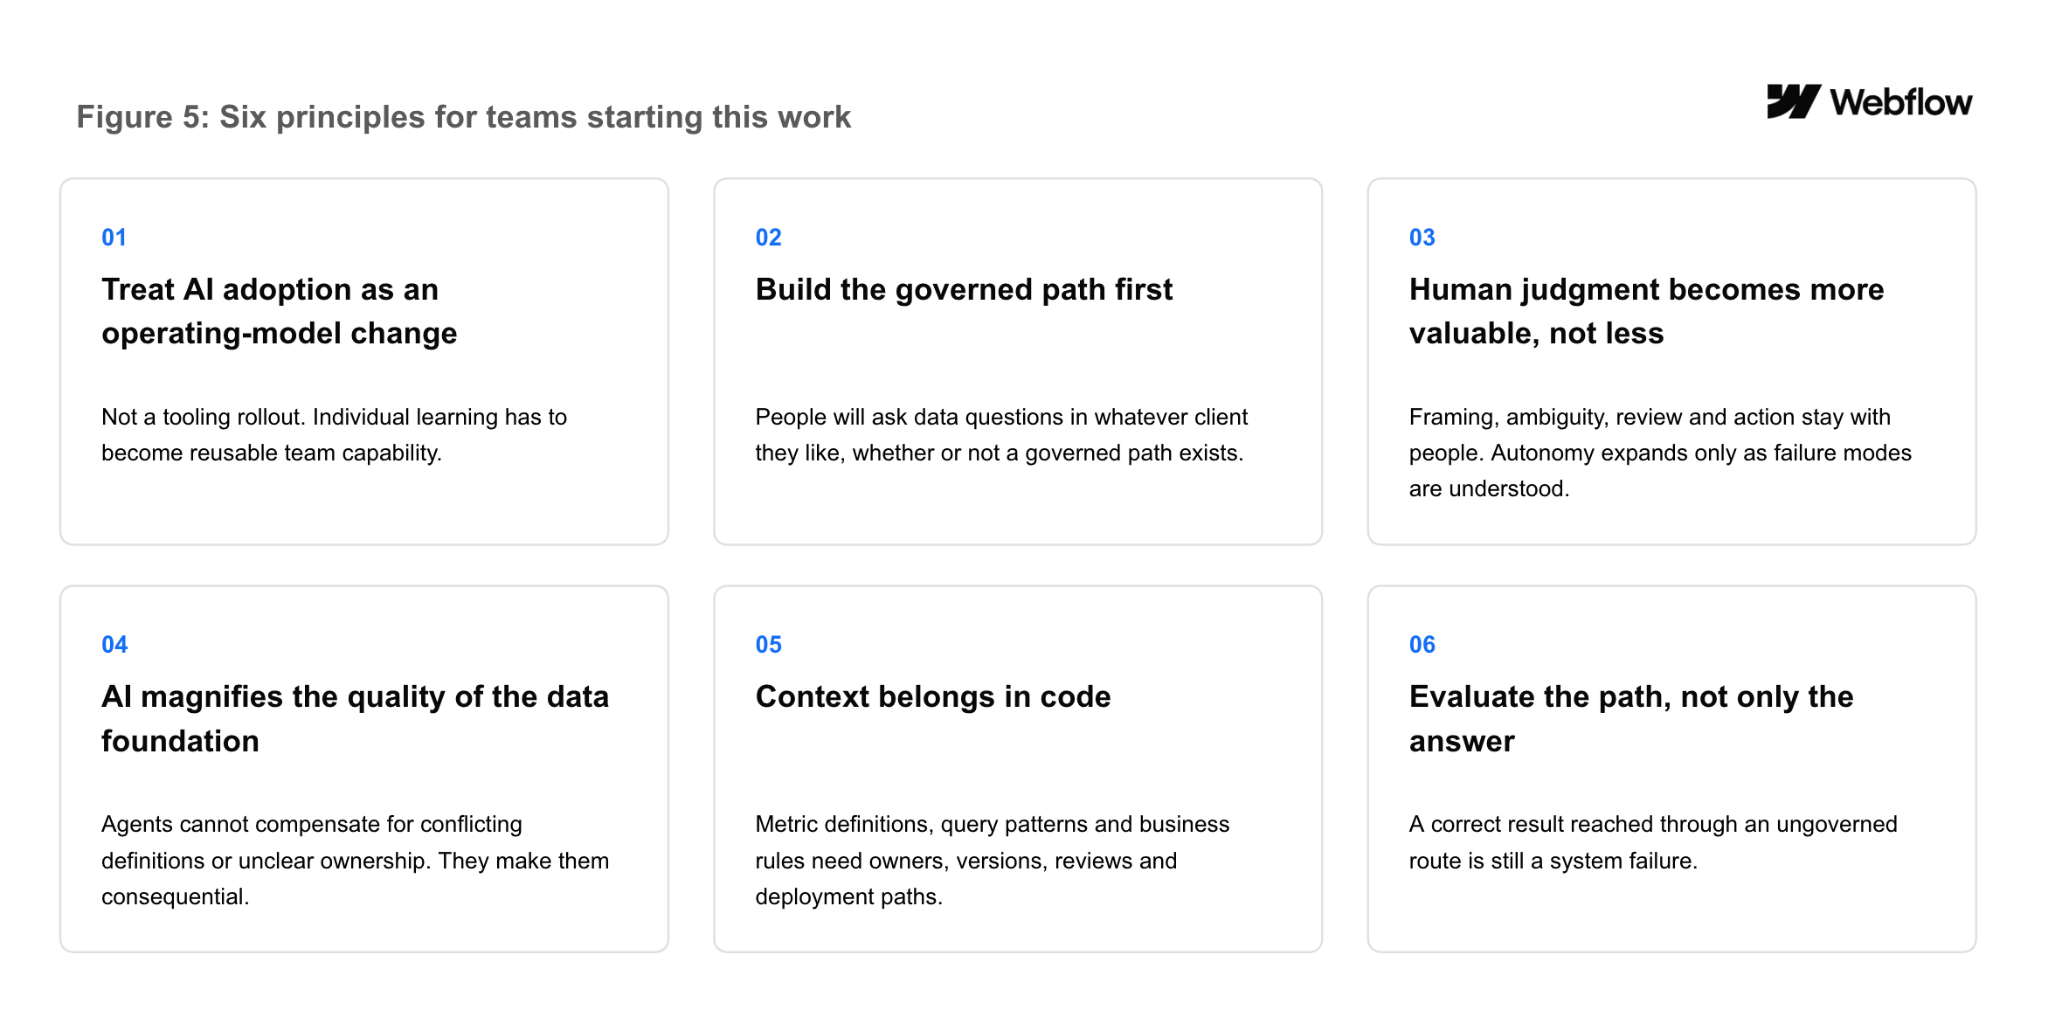
Abbildung 5 fasst sechs Prinzipien aus unserer Erfahrung beim Aufbau und der Skalierung eines KI-nativen Data & Insights-Betriebssystems zusammen.
Der größere Wandel
Wir stehen erst am Anfang. Während wir diese Fähigkeiten erweitern, besteht die nächste Herausforderung darin, plausible, aber falsche Antworten zu erkennen, bevor sie Entscheidungen beeinflussen. Das bedeutet, Aktualität, Herkunft, Annahmen und Konfidenz sichtbar zu machen, die Evaluierung zu stärken und menschliche Prüfung dort zu erhalten, wo Fehler hohe Kosten verursachen. Eine weitere Grenze ist der Aufbau vollständig geschlossener, autonomer analytischer Systeme, die von der Fragestellung über dynamische Modellierung bis zur Ausführung reichen, verankert in aus Code abgeleiteter Geschäftsbedeutung, mit menschlicher Freigabe an kritischen Punkten.
Letztlich definiert sich ein KI-natives Data & Insights-Team nicht danach, wie viele Agenten es baut, sondern danach, ob KI innerhalb eines vertrauenswürdigen Systems aus kontrollierten Daten, explizitem Kontext, wiederverwendbaren Workflows, architektonischen Kontrollen, messbarer Qualität und menschlichem Urteilsvermögen operiert. Wir haben damit begonnen zu fragen, wie Agenten uns helfen könnten, anders zu arbeiten. Wir bauen jetzt auf ein größeres Ergebnis hin: vertrauenswürdige Self-Service-Analysen für mehr Menschen, einen kürzeren Weg von der Frage zur Entscheidung und bessere Entscheidungen, ohne die Governance zu kompromittieren. Das ist das Versprechen eines KI-nativen Data & Insights-Betriebssystems.


















