

Fragmentar grandes conjuntos de datos de producción rara vez es un evento único; es un proceso cuidadoso e incremental. En Webflow, migramos cientos de millones de documentos de una base de datos escalada verticalmente a una arquitectura fragmentada utilizando capas adaptadoras, colas y trabajos idempotentes. Así es como lo logramos sin tiempo de inactividad ni inconsistencias en los datos.
Como muchas plataformas en crecimiento, la arquitectura de datos de Webflow ha evolucionado con el tiempo a medida que aumentaban los requisitos de escala y fiabilidad. Al principio, una única base de datos gestionaba las cargas de trabajo principales con escalado vertical (añadiendo CPU, memoria o almacenamiento), lo que proporcionaba un amplio margen y crecimiento con una sobrecarga operativa relativamente baja. Este enfoque funcionó bien para la plataforma gracias a su simplicidad y rápida iteración, incluso cuando se introdujeron redundancia y clústeres de bases de datos adicionales para respaldar las necesidades cambiantes del producto y la infraestructura.
Con el tiempo, el crecimiento sostenido en el volumen de datos y el rendimiento expuso los límites prácticos del escalado vertical. Los costes de hardware aumentaron, las mejoras de rendimiento comenzaron a estancarse y el riesgo operativo creció a medida que los clústeres aumentaban de tamaño. En el caso de Webflow, uno de los conjuntos de réplicas máximo de nuestro clúster de documentos tenía un límite de 4 TB establecido por el proveedor, lo que imponía un techo estricto a la capacidad de escalado vertical del clúster. Ese clúster servía como sistema de registro para una gran parte de los datos no estructurados de la plataforma, incluidos el DOM del sitio, componentes, estilos e interacciones, y sus colecciones seguían creciendo de forma constante. Aunque la fragmentación era un requisito futuro conocido y ya se habían logrado avances hacia la migración de datos del sitio, otras inversiones en escalabilidad y fiabilidad tuvieron prioridad como parte de una evolución más amplia de la plataforma a lo largo de varios años.
A medida que el clúster se acercaba a sus límites superiores de escalado, esos límites teóricos se convirtieron en riesgos operativos tangibles. La recuperación tras fallos se volvió más lenta y compleja, con volúmenes de datos crecientes que ampliaban el radio de impacto y extendían los plazos de recuperación. Lo que alguna vez fue una consideración de escalabilidad a futuro se convirtió en una preocupación inmediata de fiabilidad. En respuesta, lanzamos un esfuerzo de migración enfocado para extraer las cuatro colecciones más grandes de la base de datos de documentos, reduciendo su tamaño total a más de la mitad y sentando las bases para la arquitectura fragmentada descrita en el resto de este artículo.
Descripción general de la estrategia de migración
Evaluamos varias estrategias para ejecutar la migración, incluyendo enfoques de "big-bang", bajo demanda y graduales. Finalmente, elegimos una migración gradual por algunas razones clave:
- Necesitábamos mantener la estabilidad del producto y lograr un tiempo de inactividad cero
- Queríamos validar la migración de forma incremental, con salvaguardas claras y rutas de reversión (spoiler: no las necesitamos)
- Un enfoque bajo demanda no era viable, ya que muchos sitios están inactivos y nunca activarían una migración de forma natural, lo que impediría la limpieza completa de las colecciones no fragmentadas
Para respaldar una migración gradual, introdujimos una capa adaptadora, o una abstracción que permitía a la aplicación permanecer agnóstica sobre si los datos residían en la base de datos fragmentada o en la no fragmentada. Esto garantizó que no todos los sitios tuvieran que consultar la misma base de datos al mismo tiempo. La interfaz en sí también evolucionó, ya que consultar la base de datos fragmentada ahora requería una clave de fragmentación.
Por ejemplo, obtener nodos DOM en la abstracción heredada se veía así:
import * as fullDom from 'models/fullDom'; // our DOM model module

// Fetch the DOM data from the page ID
// Assumes all page IDs are unique
const node = await fullDom.getPage(pageId);
Con el nuevo enfoque, se convirtió en:
import {DomAdapter} from 'dataAccess/dom/domAdapter';
import {DomGetPage} from 'dataAccess/dom/domDbAction';

// Asynchronously generate our adapter layer based on which DB it should call
const domAdapter = await DomAdapter.create(
  siteId // our shard key
);
// Use the same parameters as before in a type-safe query API with a shard key adapter layer
const dom = await domAdapter.getPage(new DomGetPage(pageId));
Internamente, la capa DomAdapter era responsable de:
- Determinar de forma transparente si consultar la base de datos fragmentada o la no fragmentada, basándose en los metadatos de migración de un sitio
- Emitir consultas fragmentadas utilizando el identificador del sitio principal del recurso (ID del sitio) como clave de fragmentación, lo que se alineaba naturalmente con los patrones de acceso, ya que la mayoría de las consultas tienen como ámbito el sitio
Una vez que las capas adaptadoras estuvieron implementadas para cada colección, cada punto de llamada tuvo que actualizarse para usar la nueva interfaz. Algunas migraciones fueron sencillas; otras requirieron docenas de cambios y la adición de una cobertura de pruebas exhaustiva para garantizar la precisión.
Sistema de migración
En el momento en que se definió este proyecto, Webflow no contaba con un sistema integral para migraciones de datos a gran escala. El enfoque estándar consistía en poner en marcha un único pod efímero de Kubernetes y ejecutar scripts de migración durante el tiempo que fuera necesario. Dada la escala de los conjuntos de datos de Webflow, que a menudo involucran cientos de millones de documentos y terabytes de datos, esto resultaba frecuentemente en migraciones que duraban semanas, requerían un seguimiento manual del progreso y exigían una supervisión operativa constante.
Como parte de esta iniciativa, queríamos construir algo que pudiera operar a una escala significativamente mayor, con mejor observabilidad, tolerancia a fallos y automatización.
Un nuevo sistema de migración, justo a tiempo
Webflow ya utiliza Amazon SQS de forma extensiva para cargas de trabajo asíncronas, como la publicación de sitios y la generación de sitios con IA. Con el tiempo, hemos creado abstracciones e infraestructura que facilitan la definición de colas y trabajadores por lotes para nuevos casos de uso. Aprovechar este sistema existente fue una opción natural para la migración de datos a gran escala.
El desafío principal fue poner en cola decenas de millones de trabajos de manera eficiente, dado que SendMessageBatch está limitado a 10 mensajes por solicitud. Para solucionar esto, implementamos un patrón de distribución (fanout) utilizando una cola SQS adicional:
- Una solicitud asíncrona inicial (
initFanoutRequest) pone en cola un rango de IDs de sitios para ser migrados - Estos identificadores se agrupan en lotes y se envían como trabajos
fanoutBatchOfSitesa una cola de distribución fragmentada - Cada lote se divide luego en trabajos individuales por sitio y se encola en una cola de migración fragmentada
- Los trabajadores de migración procesan estos trabajos, aplicando lógica ETL para migrar los datos a la base de datos fragmentada

Diseño del trabajo de migración
Cada trabajo de migración se implementó como una tarea idempotente de responsabilidad única que migraba los recursos de la colección de un sitio individual y actualizaba los metadatos de migración utilizados por la capa adaptadora para resolver la fuente de verdad correcta. La migración realizó principalmente una copia directa de datos no fragmentados, mientras transformaba selectivamente ciertos campos de identificador de valores de cadena a tipos ObjectId para mejorar la eficiencia del almacenamiento y el rendimiento de las consultas, y añadiendo la clave de fragmentación del ID del sitio para alinearse mejor con los patrones de acceso basados en el sitio. Al aislar cada trabajo de migración a un solo sitio, las migraciones podían reintentarse o reanudarse de forma segura tras interrupciones como reinicios, tiempos de espera o despliegues, sin dejar estados parciales o inconsistentes.
Incluso después de una migración exitosa, mantuvimos un mecanismo de reversión como red de seguridad. Esto permitía revertir un sitio a la colección no fragmentada a través de la misma canalización de distribución, restaurando los documentos originales como fuente de verdad si surgían problemas operativos o de validación tras la migración. Afortunadamente, nunca fue necesario utilizar dicho mecanismo.
Concurrencia y consistencia de datos
Mientras las migraciones estaban en curso, existía el riesgo de condiciones de carrera si otro cliente intentaba escribir en los mismos documentos no fragmentados. Sin la coordinación adecuada, esto podría provocar corrupción de datos o estados inconsistentes entre transacciones en competencia. Para solucionar esto, implementamos un mecanismo de bloqueo respaldado por Redis para garantizar la consistencia de los datos. La primera operación de escritura adquiere el bloqueo, y las escrituras posteriores se bloquean hasta que se libera. El alcance del bloqueo fue intencionalmente estrecho, cubriendo solo las operaciones necesarias para leer los metadatos del estado de migración y escribir los datos del recurso correspondiente.
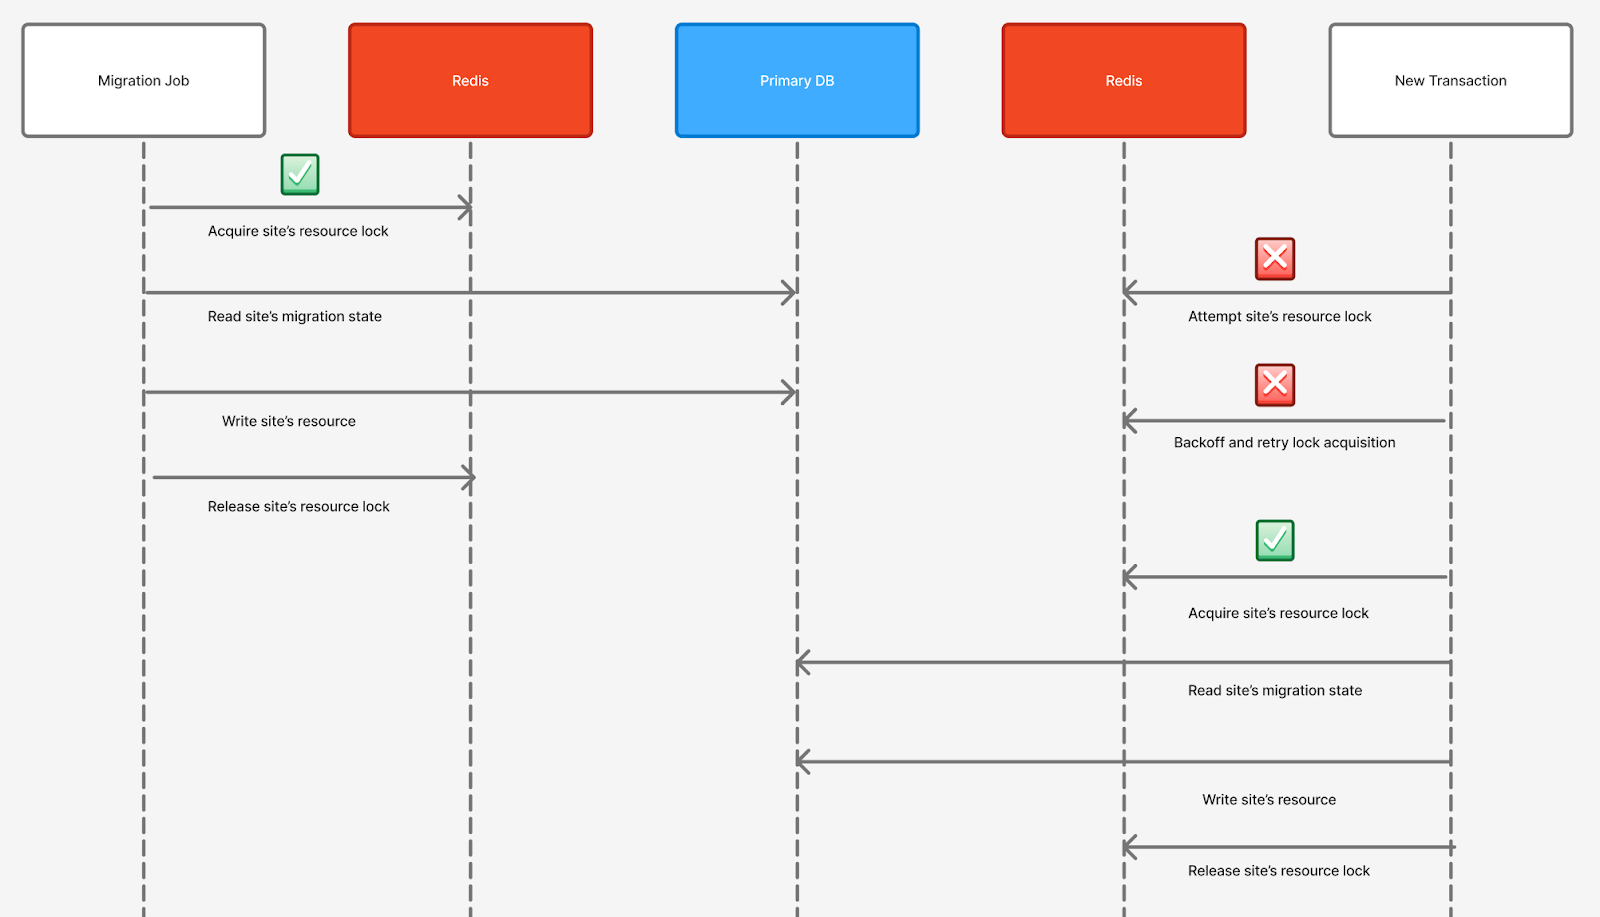
El bloqueo introduce sus propios riesgos, incluidos interbloqueos y contención de bloqueos, que pueden degradar el rendimiento o causar fallos graves. Para minimizar la exposición al riesgo, los bloqueos se aplicaron solo bajo condiciones estrictamente definidas y controladas dinámicamente: un ID de sitio debía caer dentro de un rango de ObjectId predefinido, y la ruta de escritura debía dirigirse a la colección que estaba siendo migrada activamente. Esto, en efecto, creó una ventana deslizante de IDs de sitios elegibles para bloqueo en cualquier momento dado. Debido a que el diseño de distribución por lotes enviaba los sitios en orden ascendente de ID y podía reanudarse desde cualquier punto de control, pudimos dirigirnos a rangos específicos de IDs de sitios y limitar el bloqueo a un subconjunto pequeño y controlado. Este enfoque aseguró que se mantuvieran garantías de consistencia fuerte durante las migraciones activas, manteniendo al mismo tiempo el impacto en el rendimiento y la fiabilidad de la plataforma bajo control.
Resultados e impacto
El resultado más inmediato de este proyecto fue una reducción sustancial en el tamaño de la base de datos principal de Webflow. Al extraer las cuatro colecciones más grandes, redujimos la huella de datos general en más de un 50%, eliminando más de 2 TB de datos y cientos de millones de documentos del clúster principal. Esto redujo materialmente el rendimiento de lectura y escritura en la base de datos principal, disminuyó el riesgo operativo al reducir el radio de impacto y los tiempos de recuperación, y mejoró el rendimiento en estado estable en toda la plataforma. Algunas colecciones vieron mejoras de latencia que oscilaron entre el 10% y el 45% en las operaciones principales de la base de datos. Estas ganancias fueron impulsadas en gran medida por un conjunto de trabajo más pequeño y una menor presión sobre los índices en el clúster principal, disminuyendo la contención en recursos compartidos como CPU, E/S de disco y coordinación de conjuntos de réplicas, y reduciendo la latencia de cola para las rutas de lectura y escritura comunes.
Más allá de estas victorias a corto plazo, la migración validó los beneficios a largo plazo de la fragmentación horizontal a medida que Webflow continúa escalando. Establecimos directrices internas de fragmentación, eliminamos las restricciones impuestas por una única instancia de base de datos y recuperamos margen para el crecimiento futuro. Igualmente importante, la capa adaptadora creó un modelo repetible para fragmentar colecciones adicionales, y la canalización de migración evolucionó hacia un marco agnóstico y probado en batalla, ahora reutilizado para otras migraciones de datos a gran escala sin interrumpir las cargas de trabajo de producción.

¡Estamos contratando!
Buscamos talento en producto e ingeniería para que se una a nuestra misión de poner superpoderes de desarrollo al alcance de todos.