


Durante los últimos meses, hemos estado invirtiendo activamente en la resiliencia de nuestra empresa. Esta entrada de blog explica cómo una de esas inversiones nos ayudó durante un incidente reciente en el que fallaron las operaciones de la base de datos.
Envíos de formularios
Webflow impulsa tanto a nuestros clientes como a los clientes de estos. Para muchas empresas, los embudos de ventas dependen de los envíos de formularios entrantes, por lo que la disponibilidad y durabilidad de esta función son fundamentales.
Un envío de formulario típico llega a la API de Webflow, pasa por controles de spam y se guarda en el sitio del cliente. Los clientes pueden ver y exportar estos envíos desde su panel de control de Webflow. A menudo, los clientes tienen configurados webhooks con estos formularios hacia sus propios sistemas internos, lo que les permite realizar acciones personalizadas con cada nuevo envío.
Objetivos de diseño
Nos propusimos garantizar que, incluso durante fallos en los sistemas secundarios, los envíos de formularios fueran:
- Duraderos: nunca se pierden, incluso si falla el guardado en la base de datos
- No bloqueantes: los mecanismos de recuperación no deben ralentizar la ruta crítica de la solicitud
- Idempotentes: seguros para volver a procesar sin crear duplicados
- Operables: fáciles de dirigir a un solo cliente o ejecutar en todo el sistema
Fase 1: Copias de seguridad con registro previo (Write-Ahead Backups)
La primera pregunta que debíamos hacernos era: ¿dónde deberían residir las copias de seguridad? Queríamos suficiente contexto para volver a procesar correctamente, sin añadir dependencias externas que pudieran fallar antes de que se registrara la copia de seguridad.
Optamos por colocar esto lo más arriba posible en la capa de la API, después de la validación básica del middleware, pero antes de realizar cualquier llamada a la base de datos. Al priorizar la disponibilidad de las copias de seguridad, decidimos almacenar copias de todos los envíos, incluso aquellos que luego se filtrarían como spam, así como los que se procesarían correctamente.
Decidimos usar Amazon S3 para almacenar estas copias de seguridad. Como en cualquier sistema distribuido, tuvimos que considerar qué sucedería si la solicitud de copia de seguridad fallaba y si debía ser una llamada de red bloqueante. La prioridad era servir el envío del formulario en la ruta crítica; proteger el tráfico en vivo tiene prioridad sobre el éxito de la copia de seguridad.
Fase 2: Reintento (Replay)
Con las copias de seguridad guardadas en disco, nos propusimos construir un sistema para volver a procesar los envíos de formularios en caso de una interrupción del servicio que impidiera guardarlos correctamente en la base de datos. Llamamos a este sistema replay. Esta operación debía ejecutarse en dos modos: reintento por cliente y reintento global.
Modo 1: Reintento por sitio
Este modo de reintento se ejecutaría en caso de que un solo sitio o un pequeño grupo de sitios necesitaran ser procesados nuevamente. Sería un enfoque más rápido y específico para solucionar una interrupción en el envío de formularios que afectara a un solo cliente.
Modo 2: Reintento global
Esta sería la forma más contundente de ejecutar la operación e implicaría recorrer las copias de seguridad de todos los clientes y volver a procesarlas de forma generalizada. Esta operación sería más lenta, pero se utilizaría ante una interrupción sistémica que afectara a una gran parte de los clientes.
Hashes de envío
Las interrupciones rara vez provocan el fallo del 100% de las solicitudes. Un patrón típico se ve así:
✅✅⛔✅⛔⛔✅⛔⛔⛔⛔✅
Donde ✅ representa un envío procesado correctamente y ⛔ uno que falló antes de guardarse en la base de datos. Queríamos asegurarnos de que, al repetir el proceso de principio a fin, no duplicáramos los envíos de formularios marcados con ✅ que ya habían sido procesados.
Para lograrlo, decidimos implementar un concepto llamado hashes de envío. Cada envío de formulario se representa como un hash único y estable, donde el hash SHA-256 engloba todo lo que hace que ese envío sea único: la marca de tiempo en la que entró al sistema, los datos del cliente, el cuerpo del formulario, los metadatos de la solicitud y más. Estos hashes se serializan en la ruta crítica de cada envío de formulario, independientemente del contexto de repetición.
También almacenamos y añadimos un índice de base de datos en este campo, de modo que pudiéramos consultar de forma eficiente los envíos por su hash para determinar si ya habían sido procesados con éxito.
Esto significa que, al eliminar duplicados mediante hashes de envío, pudimos crear un proceso de repetición idempotente. Así, podíamos repetir envíos en un rango amplio y asegurar que la única diferencia fueran aquellos que no se procesaron correctamente la primera vez. Además, al elegir la ventana de tiempo para la repetición, podíamos seleccionar con total tranquilidad marcas de tiempo muy anteriores y posteriores a la interrupción, garantizando que cubríamos todo el rango sin preocuparnos por procesar registros que ya estaban guardados.
const isDuplicate = await checkIfDuplicateFormSubmission({
   siteId,
   workspace,
   body,
   createdOn,
});

if (isDuplicate) {
   return;
}
Pruebas de caos
Además de las pruebas unitarias y de integración, necesitábamos simular una interrupción real para comprobar que esta herramienta funcionaba. Para ello, realizamos una prueba en nuestro entorno de pruebas (staging) donde rompimos deliberadamente los envíos de formularios. Lo hicimos lanzando una excepción no controlada en la ruta de ingesta, simulando una interrupción estándar.
Luego, intentamos realizar varios envíos que, como esperábamos, no se procesaron correctamente. Después, desplegamos una versión que corregía el entorno (simulando la reversión de un cambio problemático). Con eso, obtuvimos nuestro escenario de repetición: envíos de formularios que faltaban en la base de datos del cliente pero que estaban presentes en nuestras copias de seguridad.
A partir de ahí, ejecutamos el proceso de repetición. Primero, fuera del periodo de interrupción para confirmar que no pasaba nada. Luego, ejecutamos el proceso justo durante el periodo de interrupción para demostrar que podíamos recuperar los envíos perdidos. Después, realizamos una repetición que abarcaba tanto antes como después del periodo de interrupción, demostrando que solo se repetían los envíos faltantes. Por último, ejecutamos el proceso varias veces para probar que la operación era idempotente y que los hashes de envío eliminaban correctamente los duplicados.
Tras esto, tuvimos la confianza de que esta era una herramienta que podíamos usar en caso de incidente.
Consideraciones sobre el spam
Los formularios atraen spam. Utilizamos múltiples defensas en las capas de red y de aplicación. Una verificación en la capa de aplicación depende de un token descendente con un TTL (tiempo de vida) de 1 hora; durante incidentes prolongados, esa señal no es fiable. La repetición recurre a las otras capas, pero en la recuperación elegimos "más datos antes que menos", lo que significa que algo de spam adicional podría llegar a los clientes en ciertos escenarios de repetición.
Gestión de incidentes
Durante nuestro reciente incidente, nos encontramos en una situación donde este trabajo de resiliencia fue puesto a prueba. Las escrituras en la base de datos estaban fallando y necesitábamos evaluar si era necesario realizar tareas de repetición.
Para evaluarlo, revisamos nuestras métricas. Por lo general, debería haber un trabajo de respaldo por cada formulario almacenado; la proporción esperada durante el tráfico normal es aproximadamente 1:1. Sin embargo, en caso de una interrupción del servicio, las métricas mostrarían una brecha entre el volumen de respaldo y el volumen de envíos persistidos, lo que indicaría que había trabajo de repetición pendiente.
Teníamos un manual de procedimientos, monitores y la experiencia de haber hecho esto antes. Así que analizamos la situación y elaboramos un plan para ejecutar una operación de repetición global.
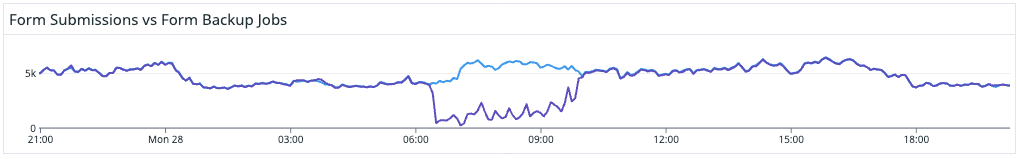
La magnitud del problema y la necesidad de la operación de repetición eran considerables, con varias horas de respaldos por procesar. Afortunadamente, la operación se desarrolló sin contratiempos, procesando millones de respaldos y enviando los formularios correctamente a nuestros clientes.
¿Qué sigue?
Todavía queda trabajo por hacer.
- Mover los respaldos aún más atrás en la pila para reducir las ventanas de fallo previas al respaldo. Filtrado de spam más inteligente durante la repetición y en la ruta crítica. Repetición más rápida y económica: tuberías de transmisión, contrapresión y particionamiento más granular para reducir el consumo de cómputo, manteniendo la idempotencia y resiliencia actuales.
Conclusión
Perder los datos de los formularios de los clientes es catastrófico. La resiliencia en esta área es fundamental para nuestros clientes, por lo que contar con sistemas para realizar la recuperación de datos es esencial. Igual de importante es tener un manual de procedimientos y la experiencia necesaria para ejecutar estos sistemas de forma segura. Nos tomamos las interrupciones del servicio muy en serio. Cuando ocurren, priorizamos una recuperación segura y verificable. En este incidente, recuperamos casi un millón de envíos de formularios respaldados y los entregamos a los destinatarios correctos.
¿Te apasiona crear sistemas distribuidos resilientes? Si es así, únete a nuestro equipo!

¡Estamos contratando!
Buscamos talento en producto e ingeniería para que se una a nuestra misión de poner superpoderes de desarrollo al alcance de todos.