

En este artículo, compartimos cómo el equipo de Seguridad de Aplicaciones (AppSec) de Webflow implementó con éxito un programa de Análisis de Composición de Software (SCA). Repasaremos las herramientas y procesos que creamos, cómo los pusimos en marcha y las lecciones clave que aprendimos en el camino.
Antecedentes
El Análisis de Composición de Software (SCA) es un control de seguridad fundamental para gestionar las vulnerabilidades introducidas a través de dependencias de software de terceros. Aunque analizar las bases de código en busca de problemas conocidos es esencial, un programa de seguridad maduro va más allá al poner en práctica esos hallazgos y permitir que los equipos actúen sobre ellos de manera eficiente y efectiva. Incorporar el SCA a un programa de seguridad suele presentar desafíos importantes, como el volumen abrumador de alertas y falsos positivos, la cobertura inconsistente en diversas pilas tecnológicas y la dificultad de integrarse sin problemas en los flujos de trabajo del Ciclo de Vida de Desarrollo de Software (SDLC), todo lo cual puede obstaculizar la remediación oportuna y reducir la eficacia general del programa.
Queríamos aplicar el SCA desde las primeras etapas del desarrollo para permitir que los desarrolladores recibieran comentarios oportunos y prácticos dentro de sus herramientas existentes, reduciendo la fricción y los tiempos de respuesta. Adelantar el SCA permite una mayor visibilidad, una clasificación más rápida y una alineación con los principios de seguridad desde el diseño. Esto prepara el camino para un programa de Seguridad de Aplicaciones maduro y proactivo que se escala eficazmente en toda la organización.
Una de las lecciones más valiosas que aprendimos al implementar el SCA fue la importancia de crear una solución que se alineara tanto con las necesidades de ingeniería como con la cultura de la empresa. La flexibilidad fue la clave. Para cada control o proceso que propusimos, ofrecimos múltiples opciones de implementación y dimos a los equipos la libertad de elegir lo que mejor les funcionara.
También adoptamos una estrategia de despliegue incremental. Cada nueva iniciativa comenzó a pequeña escala, enfocándose en uno a cinco equipos, repositorios o tickets de Jira. Recopilamos comentarios, hicimos ajustes y solo avanzamos una vez que recibimos una respuesta 100% positiva. Con esa confianza, ampliamos gradualmente el alcance, incorporando equipos adicionales, repositorios o emitiendo una cobertura de tickets más amplia. Una vez que logramos la cobertura total para esa fase, repetimos el mismo enfoque medido para el siguiente paso del proceso.

Desafíos del SCA
Implementar una solución de Análisis de Composición de Software (SCA) aporta beneficios significativos para asegurar las cadenas de suministro de software, pero tuvimos que enfrentar varios desafíos. Aquí hay algunos ejemplos:
- Falsos positivos y ruido - Muchas herramientas de SCA informan de vulnerabilidades que:
- No son realmente explotables (por ejemplo, solo en código de prueba o desarrollo).
- Ya están mitigadas por la lógica o la configuración de la aplicación.
- Esto genera fatiga por alertas, lo que reduce la participación de los desarrolladores.
- Contexto de vulnerabilidad y priorización
- No todas las CVE son iguales. Sin contexto (por ejemplo, rutas de código alcanzables, bibliotecas en uso), es difícil saber qué arreglar primero.
- Los equipos necesitan ayuda para clasificar el riesgo real frente al teórico.
- Conflictos de versiones y capacidad de reparación
- Incluso cuando una vulnerabilidad tiene una solución, actualizar una biblioteca podría romper otras partes del sistema.
- La complejidad de las dependencias y el acoplamiento estrecho ralentizan la remediación.
- Adopción por parte de los desarrolladores e integración en el flujo de trabajo
- Si la herramienta no está integrada en CI/CD o en las herramientas de desarrollo (por ejemplo, GitHub, VS Code), la adopción se ve afectada.
- Los procesos manuales para revisar o suprimir problemas generan fricción.
- Problemas de cumplimiento de licencias
- Muchos equipos se centran en las CVE, pero pasan por alto las infracciones de licencias de código abierto, lo que puede suponer un riesgo legal.
- Gestionar las políticas de licencias (GPL, MIT, BSD, etc.) en todas las dependencias añade un nivel extra de complejidad.
- Políticas incoherentes entre equipos
- Sin una gobernanza centralizada, cada equipo puede gestionar las vulnerabilidades de forma distinta: algunos aplican parches de inmediato, mientras que otros los ignoran o los retrasan.
- La falta de objetivos de nivel de servicio (SLO), supresiones o procesos de excepción estándar conduce a resultados inconsistentes.
En la siguiente sección, explicamos cómo implementamos con éxito un programa de SCA en Webflow, superando los desafíos clave que conlleva.

¡Estamos contratando!
Buscamos talento en producto e ingeniería para que se una a nuestra misión de poner superpoderes de desarrollo al alcance de todos.
Pasos para la implementación
Paso 0: Inventario: no puedes proteger lo que no conoces
Un punto de partida fundamental para cualquier programa de SCA es establecer un inventario preciso y actualizado continuamente de los repositorios. En una organización de ingeniería en constante movimiento, los ingenieros crean y retiran repositorios con frecuencia, por lo que nuestra solución de SCA debía adaptarse dinámicamente a estos cambios.
Para identificar qué repositorios debían estar cubiertos por el SCA, el equipo de AppSec propuso tres enfoques de inventario:
- Temas de GitHub: los equipos de ingeniería etiquetan sus repositorios con temas predefinidos (por ejemplo,
business-critical-yesobusiness-critical-no) en el momento de la creación. - Archivo de metadatos: cada repositorio mantiene un archivo
metadata.jsonque contiene campos como "habilitar escaneo SCA", microservicio asociado, información de despliegue, etc. - Base de datos externa: una hoja de cálculo centralizada, gestionada conjuntamente por los equipos de ingeniería, que enumera todos los repositorios con su propiedad y los metadatos relacionados con el SCA.
Ingeniería eligió la opción de los temas de GitHub. A partir de ahí, automatizamos este proceso con un bot que se ejecuta semanalmente y compila tres listas:
- Todos los repositorios etiquetados como
business-critical-yes- Estos repositorios se añaden a nuestra herramienta de escaneo SCA si no han sido escaneados previamente.
- Estos repositorios se añaden a nuestra herramienta de escaneo SCA si no han sido escaneados previamente.
- Todos los repositorios etiquetados como
business-critical-no- Esos repositorios se eliminan del escáner.
- Esos repositorios se eliminan del escáner.
- Nuevos repositorios sin un tema crítico para el negocio y con propiedad inferida (a través del archivo
CODEOWNERSo del creador del repositorio)- AppSec contacta a los propietarios para asignar los temas correspondientes. Seguimos un modelo de "confiar, pero verificar": animamos a los equipos de ingeniería a etiquetar los repositorios al crearlos, y AppSec solo interviene cuando faltan etiquetas.
La automatización utiliza los metadatos para generar también un archivo de configuración que se usará durante el proceso de escaneo SCA (más información sobre esto en las siguientes secciones).inventory.jsoninventory.json
Paso 0.1: Propiedad: saber quién es el responsable
Una propiedad precisa es esencial para un SCA eficaz, especialmente en lo que respecta a la elaboración de informes y la corrección. Para la mayoría de los repositorios, la propiedad puede derivarse del archivo o del creador original. Sin embargo, en monorepositorios o bases de código compartidas, la propiedad debe ser más granular, hasta el nivel de dependencias específicas de terceros.CODEOWNERS
Propusimos tres opciones para registrar la propiedad:
- Archivo CODEOWNERS
- Archivo de metadatos
- Fuente de información externa (por ejemplo, Google Sheets, Confluence, Renovate)
Nuestra automatización se diseñó para ser agnóstica respecto a la fuente de los datos de propiedad. Independientemente de la opción que eligiera un equipo, el script analizaba y normalizaba los datos antes de enviarlos al módulo de informes.
Al permitir que los equipos de ingeniería eligieran el mecanismo de propiedad que mejor se adaptara a su flujo de trabajo, aumentamos significativamente la adopción y la precisión. En nuestro caso, el enfoque preferido fue una herramienta de código abierto llamada Renovate, que nuestros equipos de Productividad del Desarrollador introdujeron para la aplicación automática de parches. Nuestros scripts extraen los datos de Renovate () a través de una API para correlacionar la propiedad de los paquetes antes de emitir cualquier informe.renovate.json
Esta flexibilidad ayudó a establecer asociaciones más sólidas entre AppSec y el equipo de ingeniería, al resolver problemas juntos en lugar de imponer procesos rígidos.
Paso 1: Incorporación: escaneo de dependencias vulnerables
Aunque la mayoría de las herramientas SCA modernas admiten las integraciones de API necesarias para automatizar la incorporación de repositorios, la ejecución de escaneos y la recuperación de resultados, nos aseguramos de que nuestro escáner SCA también aportara un buen valor en cuanto a:
- Tasa de falsos positivos y capacidades de ajuste
- Calidad de los resultados del escaneo
- Facilidad de integración y configuración
Creamos nuestra capa de automatización para que fuera independiente del proveedor; reemplazar el escáner subyacente simplemente requeriría actualizar las llamadas a la API dentro de nuestros scripts. La herramienta SCA escanea cada nueva solicitud de extracción (PR) en busca de dependencias que se añadan a la base de código. Además, también ejecuta un escaneo completo diario con el objetivo de detectar nuevas vulnerabilidades que puedan haberse revelado después de que la dependencia se haya añadido a la base de código.
Paso 2: Integración: incorporación de los resultados del escaneo al ciclo de vida de desarrollo de software (SDLC)
Una vez que los repositorios se incorporan y se escanean con regularidad (escaneos completos diarios y en cada PR para nuevas dependencias), el siguiente paso es integrar los resultados en el flujo de trabajo de ingeniería de una manera que se alinee con los procesos existentes y minimice la fricción.
En Webflow, los equipos de ingeniería utilizan Jira para el seguimiento del trabajo, organizando los elementos en épicas, tareas, errores, etc. Para integrar el SCA en su SDLC de forma natural, diseñamos nuestra automatización para generar hallazgos como tickets de Jira, formateados y categorizados de una manera que coincida con la forma en que los equipos ya operan. La función lambda de integración cubrirá todos y cada uno de los repositorios del y ejecutará al menos una sincronización al mes para garantizar que los datos del escáner SCA y los tickets de Jira sean coherentes.inventory.json
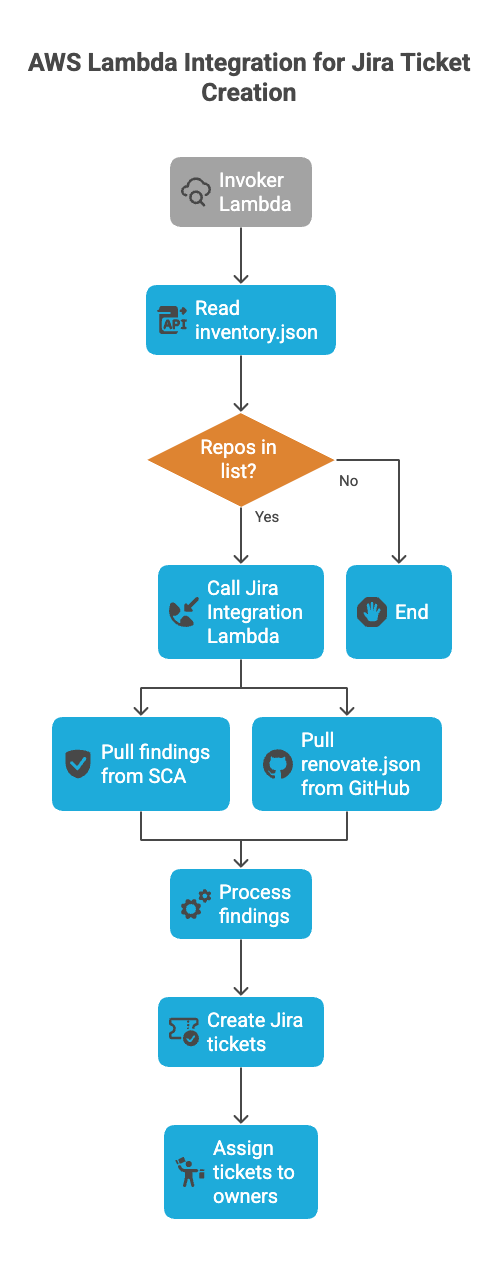
En lugar de inundar a los equipos con tickets inmediatamente después de incorporar un nuevo repositorio, adoptamos un enfoque gradual y controlado para evitar abrumarlos.
Modo de prueba por defecto
Cuando un repositorio se incorpora por primera vez a SCA, entra en un modo de "prueba" según la configuración predeterminada en el archivo inventory.json. Durante esta fase, se ejecutan los escaneos, pero en lugar de crear tickets, los resultados se recopilan en un informe interno. Esto le da al equipo de AppSec la oportunidad de:
- Revisar los hallazgos críticos antes de escalarlos.
- Eliminar los falsos positivos.
- Ajustar las clasificaciones de gravedad si es necesario.
- Validar la relación señal-ruido antes de entregárselo a ingeniería.
Si confirmamos algún problema Crítico, notificamos al equipo responsable y emitimos un ticket de inmediato. De lo contrario, ponemos los hallazgos en cola para una clasificación posterior o les restamos prioridad según corresponda.
Sincronización con los equipos de ingeniería
AppSec mantiene sincronizaciones mensuales con cada pilar de ingeniería. Estos puntos de contacto tienen dos propósitos:
- Conocer los próximos cambios en su hoja de ruta (por ejemplo, funciones que necesitan aportes de seguridad).
- Compartir actualizaciones de AppSec, como nuevas herramientas, iniciativas o hallazgos.
También discutimos los hallazgos de las pruebas durante estas reuniones. Avisar a los equipos les permite planificar con antelación y asignar recursos en los próximos sprints. Cuando el repositorio está listo para salir del modo de prueba, habilitamos la generación de tickets, comenzando solo con problemas de gravedad Crítica y Alta.

Una vez que el backlog de alta prioridad está bajo control, comenzamos a mostrar gradualmente los hallazgos de gravedad Media y Baja, ayudando a los equipos a mejorar continuamente sin verse enterrados en alertas desde el primer día. Implementamos la configuración personalizando el inventory.jsonarchivo de configuración. El fragmento a continuación muestra una configuración de "prueba" para el monorepo de Webflow que se ejecuta cada segundo día del mes y solo informa hallazgos P0 y P1 (Críticos y Altos).
Paso 3: Automatización - reportar hallazgos a escala
En esta etapa, ya hemos identificado los repositorios a escanear, integrado nuestro software SCA para escanearlos continuamente y establecido un proceso de revisión para los hallazgos. Ahora, el desafío es: ¿cómo reportamos estos hallazgos de manera eficiente entre muchos equipos, manteniendo al mismo tiempo la visibilidad y el control centralizados?
La solución fue automatizar la creación de tickets en Jira, enriquecidos con metadatos personalizados mediante etiquetas y campos personalizados. Esto nos permite integrarnos con los flujos de trabajo de los equipos de ingeniería y, al mismo tiempo, mantener la supervisión de AppSec.
Tickets basados en metadatos
Nuestros scripts de automatización analizan los hallazgos del escáner SCA y crean tickets de Jira con campos basados en metadatos. Por ejemplo:
- Un problema de gravedad alta con una puntuación CVSS de ocho se etiqueta automáticamente como
sec-sev-highy la fecha de vencimiento se establece según la gravedad. - Los tickets también pueden etiquetarse con el nombre del paquete afectado, el nombre del repositorio y la fuente del análisis.
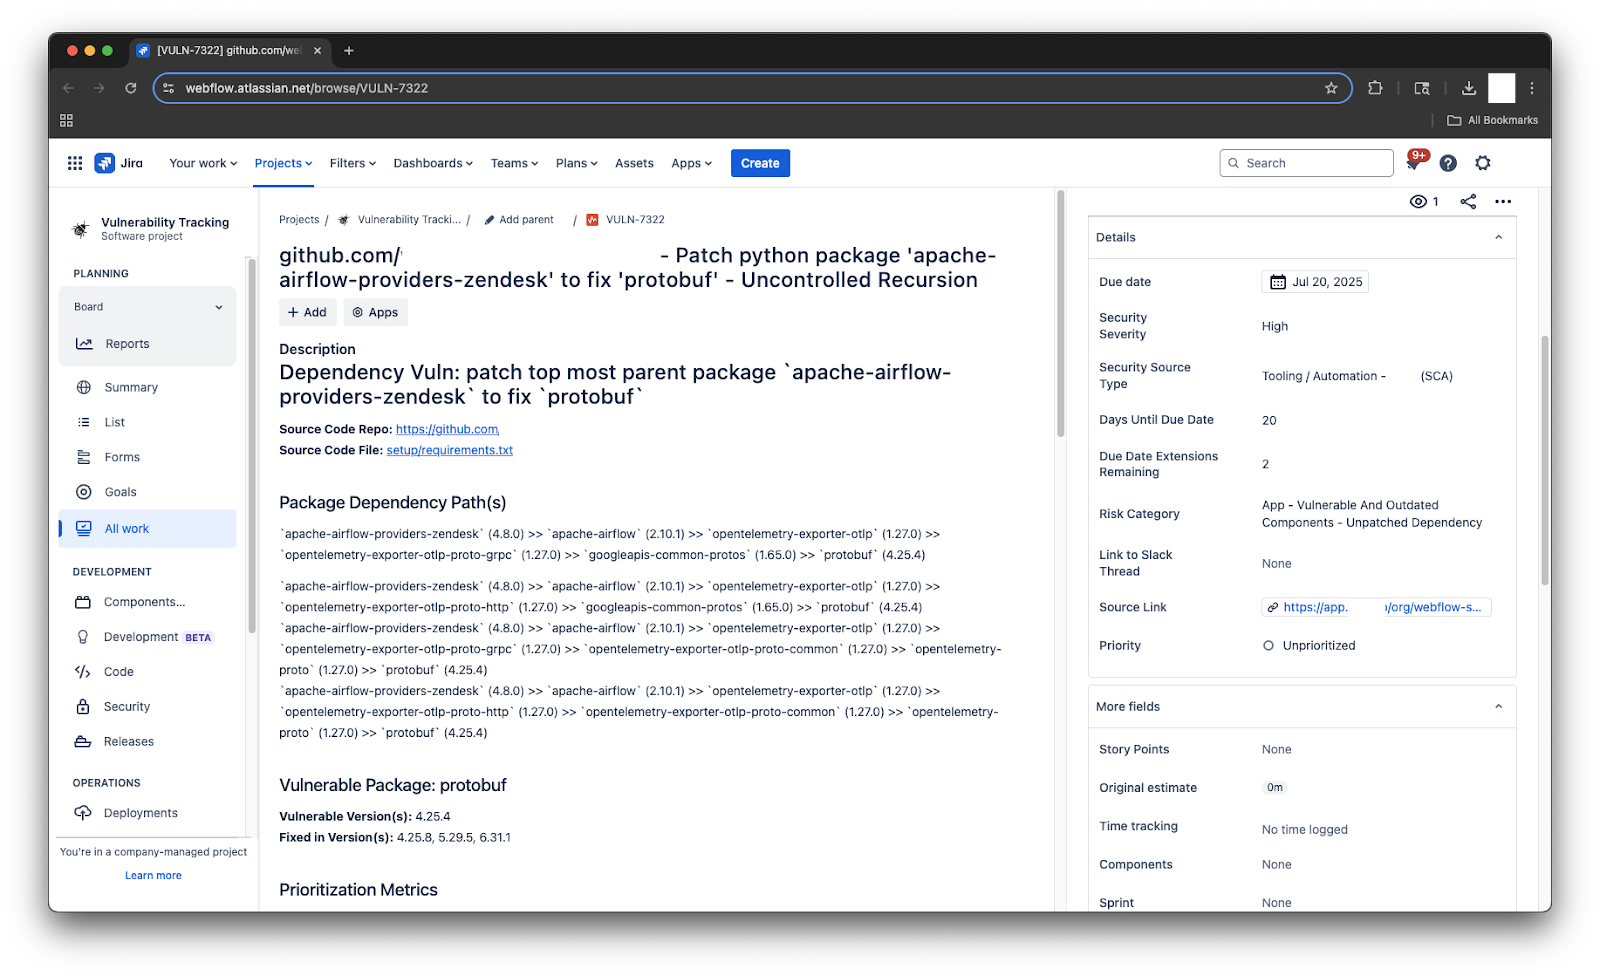
Este etiquetado estructurado y los campos personalizados permiten al equipo de AppSec:
- Rastrear las tendencias de vulnerabilidad entre equipos o servicios.
- Crear paneles y mapas de calor para visualizar los problemas abiertos por gravedad o ubicación.
- Monitorear el progreso de la remediación por equipo o por clase de vulnerabilidad.
El equipo de AppSec organiza su trabajo en sprints. Después de cada reunión diaria, revisamos los linters de Jira para rastrear las nuevas vulnerabilidades identificadas por los escáneres SCA, además de monitorear el estado de los problemas ya asignados a los equipos de ingeniería. Además de estos linters, los paneles de Jira ofrecen una visión más amplia de las tendencias. Si detectamos anomalías, como un aumento inesperado de vulnerabilidades, investigamos proactivamente la causa raíz y tomamos medidas antes de que la situación se agrave.
Enrutamiento y control de flujo de trabajo
En lugar de asignar tickets inmediatamente a los proyectos de Jira de los equipos de ingeniería, primero creamos tickets para todos los hallazgos nuevos en un proyecto intermedio de Jira utilizado para la Gestión de Vulnerabilidades general (por ejemplo: el proyecto VULN de Jira). Este paso permite una revisión manual antes de enviar tickets masivos al ciclo de vida de desarrollo (SDLC) de un equipo.
Esta revisión ayuda a garantizar la precisión y la relevancia. Por ejemplo:
- Un problema de alta gravedad en un paquete utilizado solo por un servicio programado para su eliminación podría reducirse de categoría.
- Un hallazgo podría marcarse como falso positivo o reclasificarse según el contexto empresarial externo que el escáner no puede detectar.
Una vez revisado y aprobado, movemos el ticket al proyecto de Jira del equipo de ingeniería correspondiente, basándonos en metadatos o reglas de enrutamiento.
Autonomía de ingeniería
Aunque AppSec posee y controla los metadatos de seguridad, los equipos de ingeniería mantienen el control total sobre sus campos específicos del SDLC, como la prioridad, la estimación de esfuerzo o las etiquetas de planificación de sprints. Esta separación de responsabilidades garantiza la alineación sin interferir en los procesos específicos de cada equipo.
Este enfoque de automatización estructurada brinda a AppSec una visión centralizada de las vulnerabilidades SCA, al tiempo que integra sin problemas los flujos de trabajo de remediación en los procesos de ingeniería.
Aunque los equipos de ingeniería varían, descubrimos que la gran mayoría resolvió sistemáticamente los hallazgos de SCA dentro del SLA de AppSec. Esto ha permitido al equipo de AppSec reducir los hallazgos críticos a cero y proyectar con confianza un progreso similar en los problemas de alta gravedad durante los próximos uno o dos trimestres. Para los pocos casos excepcionales que no pueden cumplir con el SLA, brindamos apoyo a través de reuniones de seguimiento, como se detalla en las siguientes secciones.
Paso 4: Casos excepcionales: ¿podemos parchearlo todo?
La mayoría de los flujos de trabajo de SCA se centran en la gravedad, las versiones vulnerables y el estado de remediación, pero los escenarios del mundo real a menudo presentan casos límite que no encajan perfectamente en esas categorías. En Webflow, diseñamos nuestro programa para manejar estos casos excepcionales de manera efectiva, evitando fricciones innecesarias con los equipos de ingeniería y manteniendo al mismo tiempo una postura de seguridad sólida.
Accesibilidad: No todos los problemas críticos son iguales
Un campo de metadatos clave que aprovechamos es la accesibilidad, es decir, si el código vulnerable se invoca realmente en la aplicación.
Un hallazgo marcado como Crítico por el escáner SCA normalmente activaría una respuesta de alta prioridad, posiblemente incluso un incidente de seguridad. Pero si la accesibilidad está marcada como falsa, lo tratamos como una vulnerabilidad no explotable. En ese caso, podemos reducir la gravedad a Alta, permitiendo que siga siendo urgente pero evitando interrumpir los flujos de trabajo del equipo.
Este enfoque nos ayuda a equilibrar el riesgo con el pragmatismo, asegurándonos de centrar la urgencia a nivel de incidente solo en los problemas explotables.
Licencias de terceros y fin de vida útil
Incluso si un paquete de terceros no tiene vulnerabilidades conocidas, eso no significa que esté aprobado automáticamente para su uso. Para abordar esto, el equipo de AppSec colaboró con el equipo legal de Webflow para definir un estándar para el uso de bibliotecas de terceros. Nuestra automatización también crea tickets de Jira para paquetes que utilizan licencias no autorizadas, así como para aquellos marcados por Renovate como obsoletos o sin mantenimiento. Este proceso permite al equipo de AppSec revisar estos casos excepcionales y colaborar con Ingeniería para garantizar que solo se adopten paquetes de terceros aprobados.
Sin solución disponible: no pierdas el tiempo
Otro campo importante es “¿Hay solución disponible?”. Si una vulnerabilidad crítica confirmada no tiene una solución disponible, es un motivo de preocupación inmediata. AppSec y el equipo de ingeniería responsable trabajan juntos en estrategias de mitigación, como reemplazar la dependencia, implementar controles compensatorios o aislar los componentes afectados.
Sin embargo, si el problema es no crítico y no se puede parchear, no tiene sentido generar ruido. Estos se etiquetan como sec-no-fix y se rastrean como tickets de Jira inactivos en el proyecto VULN.
Nuestra automatización vuelve a comprobar estos hallazgos periódicamente. Si hay un parche disponible, el script actualiza el ticket con la versión de la solución y una etiqueta sec-new-fix, y lo reactiva para su revisión.
Triaje mediante linter para soluciones tardías
También mantenemos linters de Jira que monitorean los tickets etiquetados con sec-new-fix. Estos representan vulnerabilidades que antes no tenían solución y que ahora cuentan con un parche, lo que significa que la ventana de exposición finalmente se puede cerrar.
Durante las reuniones diarias de sprint de AppSec, revisamos estos tickets marcados varias veces a la semana. Una vez verificados, los clasificamos y asignamos de inmediato al equipo de ingeniería correcto para su remediación.
Por qué esto es importante
Las herramientas SCA siempre sacarán a la luz casos excepcionales. Si no se manejan con cuidado, pueden:
- Generar fricción entre AppSec y los equipos de ingeniería.
- Provocar idas y vueltas innecesarias.
- Causar retrasos en la remediación o debilitar el compromiso.
Hallazgos de SCA: triaje de casos excepcionales


Al combinar un diseño de procesos inteligente con automatización personalizada, hemos creado un sistema que tiene en cuenta estos matices, filtrando el ruido y asegurando que solo los hallazgos procesables lleguen a ingeniería.
Paso 5: Apoyar al equipo de ingeniería: sé un socio, no un obstáculo
Una vez que los hallazgos de SCA fluyen hacia los canales de Jira de los equipos de ingeniería mediante la automatización, comienza el verdadero trabajo. Un programa de AppSec maduro no se detiene en la creación de tickets. La seguridad no consiste solo en identificar problemas, sino en capacitar a los equipos para que los solucionen de manera efectiva.
Los hallazgos son el comienzo, no el final
Esperar que los equipos de ingeniería se encarguen de cada vulnerabilidad por su cuenta no es realista. Incluso con buenas herramientas y etiquetas de gravedad claras, el desarrollo en el mundo real introduce complejidad:
- Actualizar un paquete puede causar cambios incompatibles.
- Es posible que la dependencia vulnerable esté programada para su obsolescencia en un punto próximo de la hoja de ruta.
- Corregir una vulnerabilidad de inmediato podría retrasar una refactorización mayor que la eliminaría por completo.
Si AppSec quiere elevar el nivel de seguridad, debe estar preparada para ir más allá de la detección.
Cambia la mentalidad: facilita la misión
La mentalidad de AppSec debería ser:
"Estamos aquí para proteger la misión de la empresa y a sus clientes, no para parchear todo a ciegas".
Esto significa comprender el contexto detrás de cada problema. La seguridad debe alinearse con los objetivos comerciales y de ingeniería, no interrumpirlos.
Cómo se ve el apoyo en la práctica
Los equipos de AppSec deberían estar preparados para:
- Colaborar en la priorización cuando una solución no es viable de inmediato.
- Proponer alternativas, como bibliotecas más seguras, o recomendar controles compensatorios (por ejemplo, firewalls de aplicaciones web, encabezados HTTP, etc.) para reducir el riesgo mientras se gana tiempo.
- Contribuir directamente al código base ayudando a escribir solicitudes de extracción (PR) u ofreciendo orientación sobre los desafíos de implementación para paquetes compartidos.
Estar dispuesto a profundizar, ya sea uniéndose a una sesión de planificación de ingeniería o ayudando a solucionar problemas en una compilación fallida, transforma a AppSec de un ejecutor de políticas a un socio de confianza.
Por qué vale la pena el esfuerzo
Sí, este modelo añade más responsabilidad y presión al equipo de AppSec. Por eso es tan importante ajustar los pasos anteriores, especialmente filtrar el ruido, para que solo las vulnerabilidades más significativas y procesables lleguen a ingeniería.
Pero la recompensa es enorme: los equipos de ingeniería empezarán a ver a AppSec no como un cuello de botella, sino como un aliado valioso, un equipo que no solo señala problemas, sino que ayuda a resolverlos.
Con el tiempo, esta confianza conduce a una cultura de seguridad más sólida, tiempos de respuesta más rápidos y una mejor adopción de prácticas de desarrollo seguro en toda la organización.
Paso 6: Cerrar el ciclo: validar las correcciones y fortalecer la postura de seguridad de Webflow
Queda una cosa más antes de dar por terminado el trabajo de SCA. Debemos validar que los problemas reportados se hayan resuelto realmente y usar esto para impulsar una mejora continua. Este enfoque ha fortalecido el programa SCA, reduciendo a cero los hallazgos críticos y garantizando que cualquier problema nuevo se solucione en cuestión de días. También prepara el terreno para lograr el mismo nivel de control sobre los hallazgos de gravedad alta y media. Estimamos que esto se logrará en los próximos 3 a 6 meses.
Validación automatizada tras el cierre de tickets
Se emite automáticamente un nuevo ticket de validación para AppSec una vez que se cierra el ticket de ingeniería original, siempre que la gravedad sea alta o crítica. Este ticket solicita al equipo de AppSec que verifique la corrección, comprobando que el parche mitigue por completo la vulnerabilidad reportada y que el siguiente escaneo del repositorio refleje un resultado limpio.
Monitoreo proactivo de SLA y tickets estancados
La misma automatización también rastrea los tickets de SCA que se acercan o superan los umbrales de SLA, o que están marcados como abiertos pero no muestran ninguna actividad reciente.
En lugar de dejar que estos problemas se acumulen, los abordamos de forma proactiva en nuestras reuniones periódicas con los equipos de ingeniería. Estas reuniones se llevan a cabo mensualmente entre AppSec y el liderazgo de los equipos de ingeniería. Entre los diversos temas rutinarios de la agenda, revisamos un linter de Jira y discutimos todos los tickets que requieren atención debido a sus fechas de vencimiento.
Este paso final garantiza la responsabilidad y el seguimiento, evitando que los problemas críticos pasen desapercibidos. Lo más importante es que refuerza que SCA no es solo un requisito de cumplimiento, sino un proceso colaborativo y continuo que eleva la postura de seguridad de la organización con el tiempo.
Conclusión: construir un programa SCA sostenible que los ingenieros realmente utilicen
Implementar un programa exitoso de Análisis de Composición de Software (SCA) no consiste en introducir herramientas en el flujo de trabajo y esperar lo mejor. Se trata de generar confianza, crear flexibilidad e integrar la seguridad en la forma en que los equipos de ingeniería ya trabajan.
En Webflow, abordamos el SCA no como un mandato único para todos, sino como un esfuerzo colaborativo. Al diseñar procesos incrementales, personalizables y fáciles de automatizar, logramos escalar la seguridad sin afectar la velocidad de desarrollo. Cada paso del flujo de trabajo, desde el inventario de repositorios y el mapeo de propiedad hasta la clasificación, validación y seguimiento de tickets, se diseñó bajo un principio: la seguridad debe ser un facilitador, no un obstáculo.
¿El resultado? Los equipos de ingeniería responden mejor a los problemas de seguridad, confían más en las herramientas y procesos que hemos construido juntos y están más abiertos a trabajar con AppSec como un socio estratégico. Y eso, más que cualquier métrica de panel o recuento de vulnerabilidades, es lo que significa una verdadera madurez en AppSec.
Si estás creando o escalando tu propio programa SCA, empieza por las personas y luego construye la automatización. Empodera a los ingenieros con contexto y apoyo. Y apunta siempre a obtener hallazgos significativos y procesables, no ruido.
Agradecimientos especiales
Este proyecto tuvo éxito gracias al apoyo y la colaboración de muchas personas y equipos que no solo ayudaron a construir la solución, sino que también la adoptaron, dieron su opinión y reportaron problemas durante el proceso. Estoy especialmente agradecido a los equipos de ingeniería de Webflow por adoptar nuestro programa SCA y fortalecer nuestra postura de seguridad.
Agradecimientos especiales a Topher Chung, Ankit Agrawal, Albert Chang y Matias Altman por llevar los esfuerzos de SCA en Webflow al siguiente nivel.