

Con millones de sitios alojados en nuestra plataforma, obtener una comprensión más profunda de las tendencias de diseño y las preferencias de los usuarios en un ecosistema tan vasto y visualmente diverso es tanto un desafío como una oportunidad emocionante.
Para abordar esto a gran escala, desarrollamos un sistema interno basado en IA y tecnologías de código abierto que analiza e interpreta elementos de diseño visual, descubriendo información valiosa para mejorar nuestras ofertas de plataforma y futuras innovaciones.
¿Por qué optar por una solución interna y de código abierto?
Quizás te preguntes por qué decidimos confiar en herramientas de código abierto para construir este sistema desde cero:
Privacidad y cumplimiento
Elegimos un enfoque interno para garantizar que cumplimos plenamente con los Términos de servicio y las directrices de privacidad de Webflow, y para mantener un control estricto sobre cómo y dónde se procesan los datos.
Eficiencia de costos
Al momento de escribir este artículo, utilizar proveedores externos como OpenAI o Anthropic para procesar contenido visual habría sido prohibitivamente costoso. Al aprovechar herramientas de código abierto y alojar la infraestructura nosotros mismos, logramos una notable reducción de costos de 17 veces, haciendo que el análisis a gran escala sea factible y altamente eficiente.
Control total y personalización
Desarrollar el sistema internamente nos dio control total sobre el proceso, permitiéndonos integrarlo sin problemas con nuestra infraestructura y adaptar el sistema a los requisitos únicos de Webflow.
Entendiendo los componentes técnicos
Para dar vida a esta solución interna, diseñamos un sistema robusto que combina modelos de IA de última generación con una infraestructura escalable, capaz de analizar sitios web de manera eficiente. Así es como se unen las piezas:
Modelo de visión-lenguaje
Elección del modelo
En el corazón de todo nuestro sistema se encuentra el modelo de visión-lenguaje, encargado de analizar el diseño visual y el contenido de los sitios web para extraer información significativa.
Para este papel fundamental, seleccionamos Qwen2-VL-7B-Instruct, un modelo de código abierto con licencia Apache 2.0 que, a noviembre de 2024, no solo era uno de los modelos más avanzados disponibles, equilibrando un rendimiento de vanguardia con escalabilidad y eficiencia de costos, sino que también superó a GPT-4 Vision Mini en múltiples pruebas de referencia.
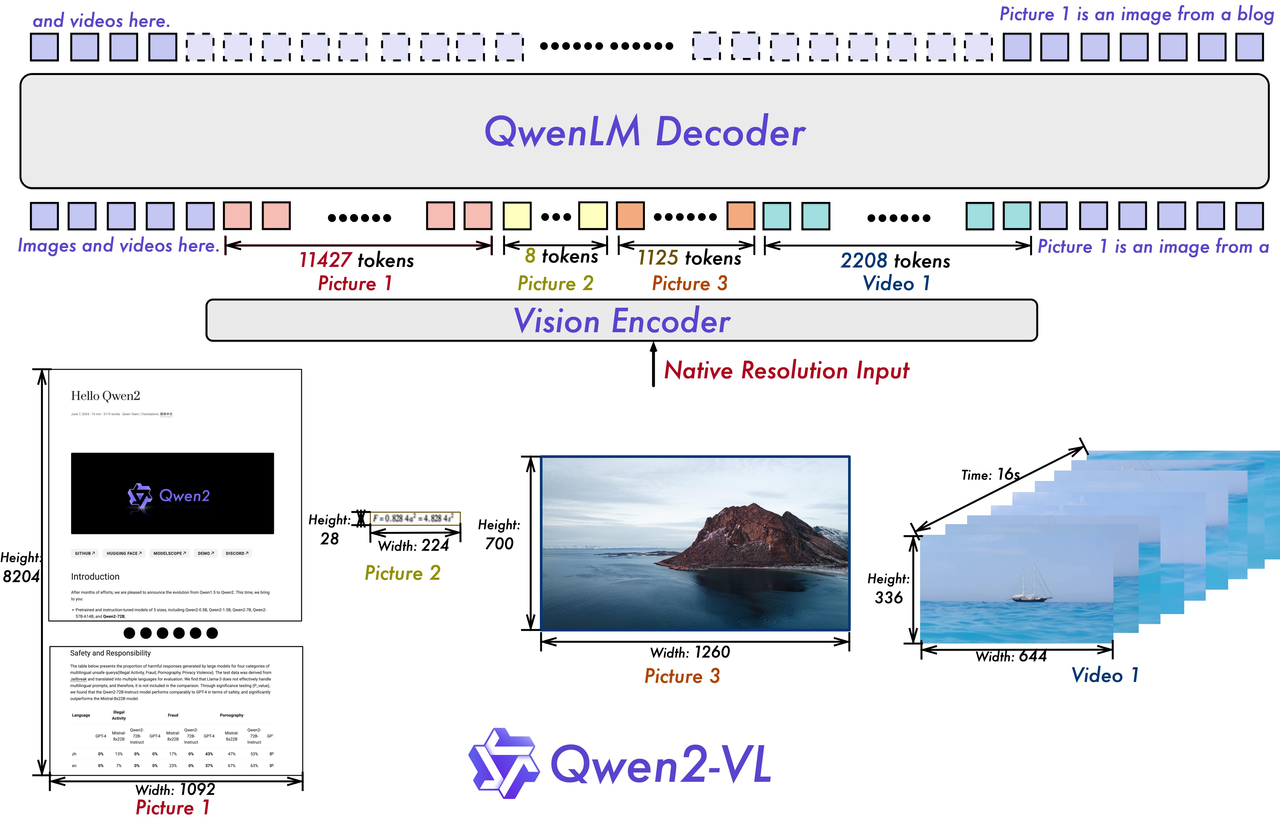
Además, con 7 mil millones de parámetros, logra un equilibrio ideal entre capacidad y eficiencia de recursos, lo que lo hace adecuado para aplicaciones a gran escala como la nuestra.
Características del modelo
Integración de Vision Transformer (ViT)
El modelo incorpora un Vision Transformer (ViT) como codificador visual y utiliza funciones de activación SwiGLU y capas de RMSNorm. Estas mejoras alinean el ViT con la estructura del modelo de lenguaje Qwen2.5, lo que aumenta la velocidad de inferencia.
Gestión dinámica de resolución
Qwen2-VL-7B-Instruct admite resolución dinámica, lo que le permite procesar imágenes de diversos tamaños y relaciones de aspecto sin sacrificar el rendimiento. Esta flexibilidad es fundamental para analizar diseños web variados.
Procesamiento multilingüe
Webflow impulsa sitios web en todo el mundo, dando soporte a empresas, freelancers y negocios en diversas regiones e idiomas. Con nuestro producto Localize, los usuarios pueden traducir sus sitios a varios idiomas sin complicaciones, garantizando la accesibilidad para diferentes audiencias. Para estar a la altura de este alcance global, nuestro analizador de sitios necesitaba gestionar el análisis de texto multilingüe sin perder precisión.
Ajuste de instrucciones
La variante de Qwen2-VL-7B ajustada por instrucciones está diseñada específicamente para gestionar tareas que requieren comprender y generar respuestas basadas en directrices concretas. Este ajuste lo hace experto en producir resultados coherentes y estructurados, como datos en formato JSON, algo esencial para guardar la información en nuestra base de datos.
Generación de texto escalable con vLLM
Para potenciar la generación de texto, aprovechamos vLLM, una biblioteca de alto rendimiento optimizada para una inferencia de LLM eficiente, escalable y flexible. Esta biblioteca encajaba a la perfección en nuestro sistema gracias a sus funciones avanzadas:
- Mecanismo PagedAttention: vLLM optimiza el uso de la memoria al reducir la fragmentación, lo que resulta en un mayor rendimiento y una mejor eficiencia de los recursos.
- Procesamiento paralelo con múltiples GPU: Admite la paralelización de tensores, lo que permite distribuir las cargas de trabajo entre varias GPU y reducir significativamente el tiempo de procesamiento.
- Flexibilidad para entradas multimodales: Puede gestionar sin problemas tanto texto como imágenes, alineándose perfectamente con nuestra necesidad de procesamiento de visión y lenguaje.
Despliegue con SkyPilot en AWS
Para gestionar y escalar nuestras cargas de trabajo de IA de manera eficiente, utilizamos SkyPilot, un marco de trabajo de código abierto que se integra perfectamente con AWS para orquestar y equilibrar las cargas de trabajo entre múltiples GPU. SkyPilot distribuye las tareas de forma dinámica, minimiza el tiempo de inactividad y pone las solicitudes en cola cuando las GPU están ocupadas, garantizando un uso óptimo de los recursos.
Para este sistema en concreto, desplegamos un clúster de 8 GPU con NVIDIA L40, lo que permite el procesamiento paralelo de múltiples instancias de vLLM.
Integración de los componentes
Así es como integramos todos los componentes para crear un flujo de trabajo de análisis de sitios fluido:
Punto de conexión API y gestión de entradas
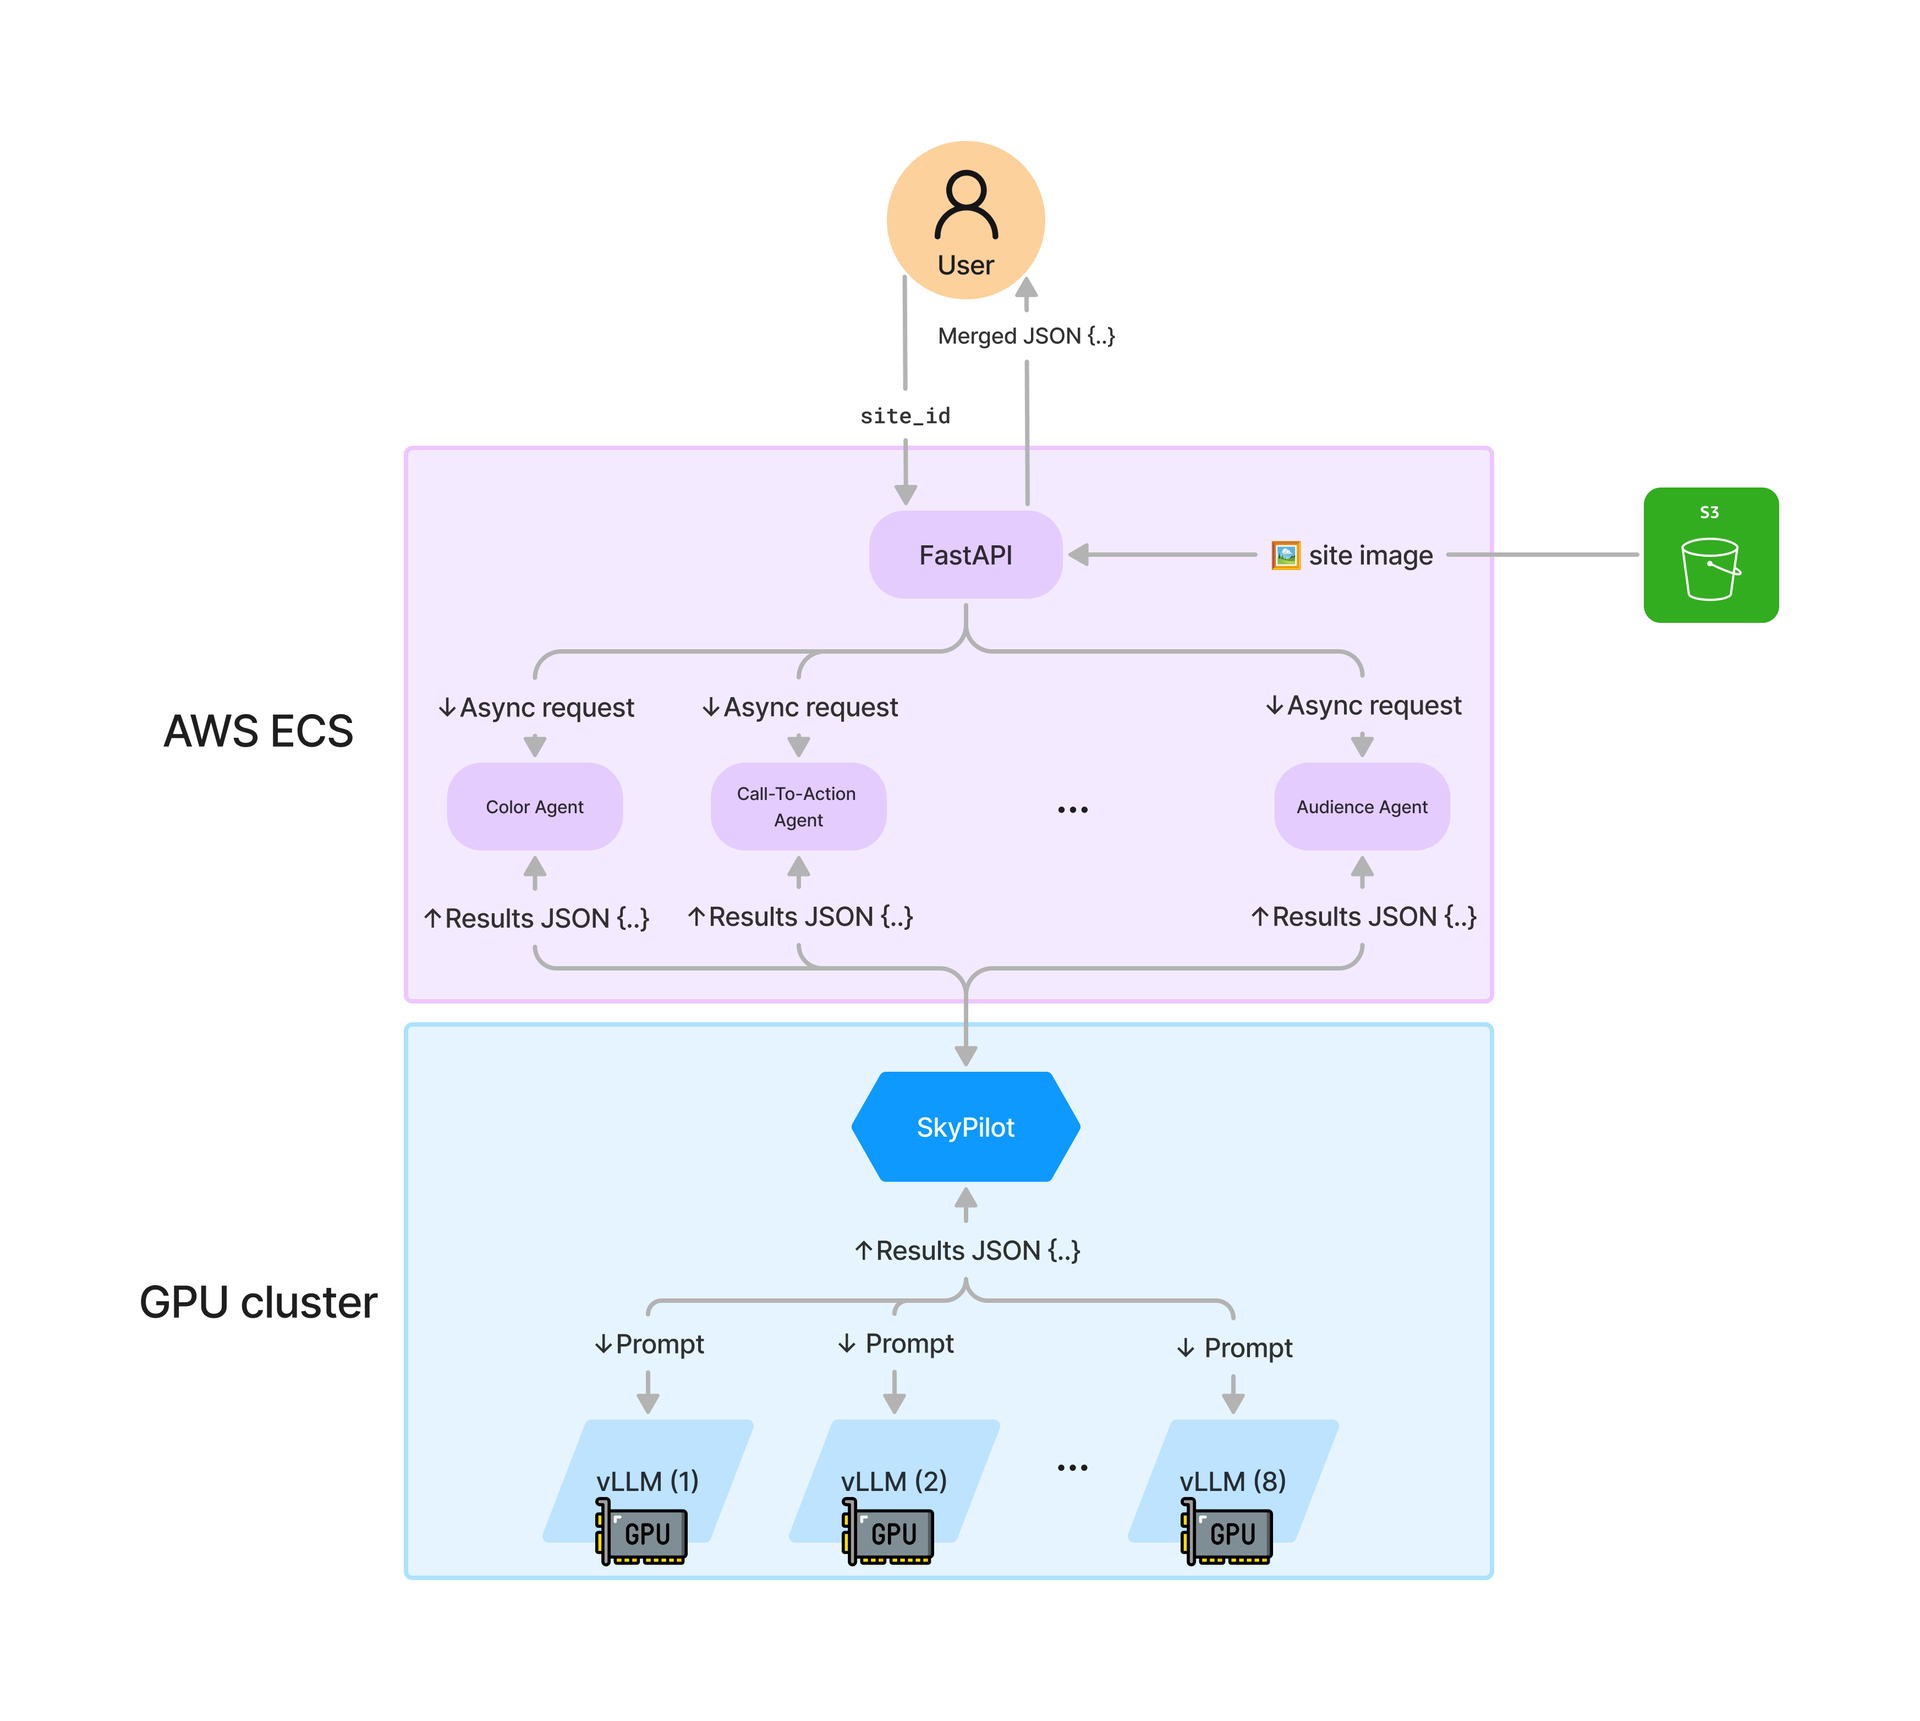
Configuramos una aplicación FastAPI en Docker desplegada en Amazon Elastic Container Service (ECS), a través de la cual se inicia el análisis realizando una llamada a la API utilizando el identificador único del sitio (site_id) como argumento.
Agentes de información asíncronos
Al recibir el site_id, la aplicación FastAPI obtiene los componentes visuales del sitio desde nuestra base de datos y organiza el análisis enviando múltiples agentes especializados, cada uno responsable de un aspecto distinto del diseño y la funcionalidad del sitio. Por ejemplo, hay agentes dedicados al análisis de color, segmentación de audiencia, análisis de llamadas a la acción (CTA), entre otros datos clave. Estos agentes operan de forma asíncrona, lo que permite el procesamiento en paralelo y reduce significativamente el tiempo de respuesta general.
Enrutamiento de solicitudes con SkyPilot
Cada agente de análisis envía una solicitud GET a SkyPilot, nuestra capa de orquestación elegida, que gestiona de manera eficiente el equilibrio de carga entre nuestras instancias con GPU. SkyPilot enruta dinámicamente cada solicitud a la instancia de GPU adecuada dentro de nuestro clúster NVIDIA L40 de 8 GPU, aprovechando su capacidad para minimizar el tiempo de inactividad y maximizar el uso de los recursos. Esto garantiza que cada agente reciba la potencia computacional necesaria para realizar tareas complejas de visión y lenguaje sin cuellos de botella.
Procesamiento con modelos de visión y lenguaje
Una vez enrutado, el modelo Qwen2-VL-7B-Instruct procesa la información específica requerida por el agente.
Agregación y construcción de la respuesta
A medida que cada agente completa su análisis, los resultados se envían de vuelta a la aplicación FastAPI, que espera a recibir todas las conclusiones. Una vez que todos los agentes han devuelto sus hallazgos, la aplicación FastAPI agrega los datos, fusionando las conclusiones individuales en una estructura de respuesta unificada. Estos datos agregados se envían entonces al usuario, proporcionando una visión integral del diseño y las métricas de rendimiento del sitio.
Formato de salida estructurado
Para garantizar la coherencia y fiabilidad en todos los agentes de análisis, aplicamos un formato JSON estructurado para cada salida. Cada agente —ya sea que analice esquemas de color, CTA o segmentación de audiencia— devuelve los datos en un esquema estandarizado. Este enfoque estructurado facilita almacenar, consultar y agregar información a gran escala.
Aquí tienes un ejemplo de un sitio web "ficticio" que creamos para demostrar el potencial de nuestro analizador de sitios con IA:
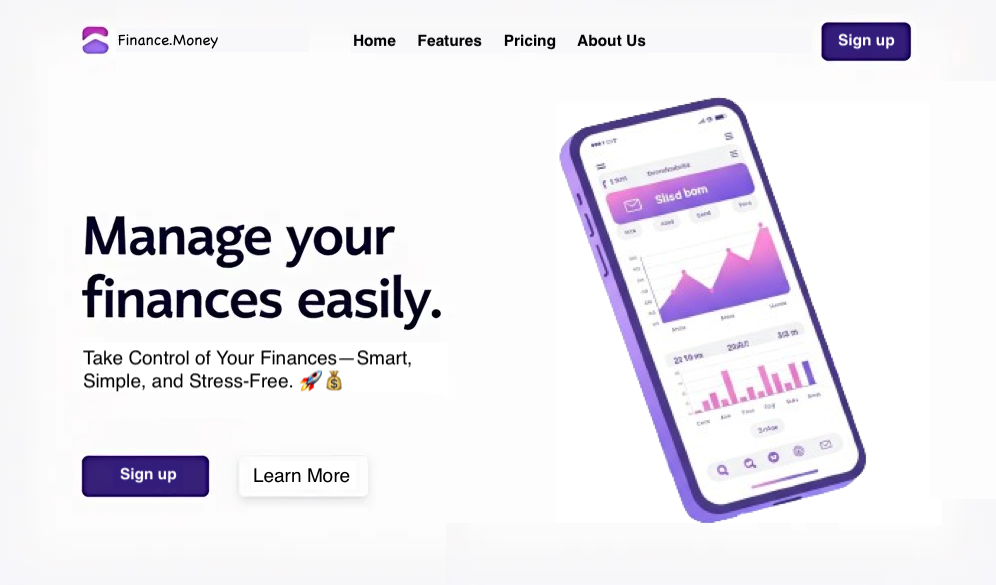
El sistema proporcionó la siguiente salida JSON:
Cómo optimizamos la inferencia de IA para el análisis de sitios web a gran escala
Crear un analizador de sitios con IA escalable no solo consistió en elegir el modelo adecuado; requirió un intenso trabajo de ingeniería para garantizar una inferencia rápida, eficiente y fiable en miles de solicitudes. Esta sección cubre las técnicas de optimización que implementamos para Qwen2-VL-7B-Instruct, vLLM y FastAPI para hacer posible el análisis de sitios web a gran escala.
Gestión de problemas de caché KV en vLLM
Uno de los mayores desafíos que enfrentamos con vLLM fue su agresivo mecanismo de caché de clave-valor (KV). vLLM está diseñado para optimizar la inferencia reutilizando secuencias en caché cuando el prompt de entrada es similar en varias solicitudes.
Sin embargo, en nuestro caso, esto provocó una repetición inesperada en la inferencia, donde sitios web completamente diferentes producían el mismo resultado porque el inicio del prompt era demasiado similar. Para solucionar esto, introdujimos marcadores de posición dinámicos en el prompt del sistema, asegurando que cada solicitud tuviera ligeras variaciones en la redacción mientras mantenía su intención original.
Por lo tanto, en el momento de la inferencia, reemplazamos dinámicamente los marcadores de posición con sinónimos seleccionados al azar; esto introduce pequeñas variaciones y evita el almacenamiento excesivo en la caché KV.
import random

# System prompt with placeholders
system_prompt = """
{synonym_for_you_are} a vision-language {synonym_for_ai} for Webflow.
Your task is to analyze website screenshots and extract {synonym_for_relevant} {synonym_for_insights}.
"""

# List of synonyms
synonyms_for_you_are = ["You're", "You are", "You act as", "Imagine you are"]
synonyms_for_ai = ["AI assistant", "language model", "intelligent agent"]
synonyms_for_relevant = ["valuable", "useful", "key"]
synonyms_for_insights = ["findings", "analysis", "observations"]

# Function to generate prompts
def generate_prompt(system_prompt: str) -> str:
    """
    Replaces placeholders with randomly synonyms to introduce slight variations
    and prevent excessive KV caching in vLLM inference.

    Args:
        system_prompt (str): A template string containing placeholders.

    Returns:
        str: The formatted system prompt with randomized synonyms.
    """
    return system_prompt.format(
        synonym_for_you_are=random.choice(synonyms_for_you_are),
        synonym_for_ai=random.choice(synonyms_for_ai),
        synonym_for_relevant=random.choice(synonyms_for_relevant),
        synonym_for_insights=random.choice(synonyms_for_insights),
    )

print(generate_prompt(system_prompt))
Ejecución de vLLM como proceso independiente para un mejor rendimiento
Durante el desarrollo, experimentamos integrando vLLM directamente dentro de FastAPI, pero descubrimos que ejecutar vLLM como un servidor independiente mediante el modo de API compatible con OpenAI, permitiendo que FastAPI interactúe con vLLM a través de HTTP, ofrecía un mejor rendimiento y estabilidad.
# Start vLLM as an OpenAI-compatible API server
python -u -m vllm.entrypoints.openai.api_server \
       --host $HOST \
       --port $VISION_LANGUAGE_PORT \
       --model $VISION_LANGUAGE_MODEL_ID \
       --max-model-len $VISION_LANGUAGE_MAX_MODEL_LEN \
       --device $VISION_LANGUAGE_DEVICE \
       --dtype $VISION_LANGUAGE_DTYPE \
       --load-format safetensors \
       --gpu-memory-utilization $VISION_LANGUAGE_GPU_MEMORY_UTILIZATION \
       --cpu-offload-gb $VISION_LANGUAGE_CPU_OFFLOAD_GB \
       --tensor-parallel-size $VISION_LANGUAGE_TENSOR_PARALLEL_SIZE \
       --enforce-eager \
       --disable-custom-all-reduce \
       --max-num-batched-tokens $VISION_LANGUAGE_MAX_NUM_BATCHED_TOKENS \
       --trust-remote-code &

# Start FastAPI separately
uvicorn site_analyzer.main:app --host $APP_HOST --port $APP_PORT
Aquí, lo iniciamos en un puerto, mientras que FastAPI se ejecuta en otro puerto y realiza las llamadas a vLLM.
Experimentando con diferentes configuraciones de vLLM
Para garantizar una inferencia eficiente para Qwen2-VL-7B-Instruct, ajustamos parámetros clave de vLLM según nuestra infraestructura y carga de trabajo. A continuación, presentamos un desglose de los parámetros utilizados, por qué son importantes y cómo afectaron al rendimiento.
- max_model_len: 8192Qué hace: Define el número máximo de tokens que se pueden procesar en una sola solicitudPor qué elegimos este valor: Una mayor longitud de contexto permite procesar capturas de pantalla de sitios web completos sin truncamientos.Valores alternativos:2048 o 4096 → Menor uso de memoria, pero insuficiente para el texto de sitios web de página completa.8192+ → Requiere más memoria GPU y puede reducir la velocidad de inferencia.
- max_new_tokens: 2000Qué hace: Limita el número de tokens que el modelo puede generar como respuesta.Por qué elegimos este valor: Evita resultados excesivamente largos, manteniendo las respuestas estructuradas.Valores alternativos:512 → Inferencia más rápida, pero podría truncar respuestas complejas.4000+ → Respuestas más detalladas, pero aumenta la latencia.
- device: 'cuda'Qué hace: Especifica dónde ejecutar el modelo ('cuda' para GPU, 'cpu' para CPU).Por qué elegimos este valor: Ejecutar en GPUs NVIDIA L40 garantizó una ejecución rápida y paralelizada. La inferencia en CPU sería demasiado lenta para el procesamiento en tiempo real de miles de sitios.
- dtype: 'bfloat16'Qué hace: Define el formato de precisión para los cálculos de punto flotante.Por qué elegimos este valor:Inferencia más rápida que float32, manteniendo la precisión.Más estable que float16, que puede sufrir subdesbordamiento en algunos casos.Valores alternativos:'float32' → Mayor precisión, pero ejecución más lenta.'float16' → Más eficiente en memoria, pero puede causar inestabilidad numérica en ciertos casos.
- gpu_memory_utilization: 0.8Qué hace: Determina la fracción de memoria de la GPU asignada a vLLM.Por qué elegimos este valor:Mantiene el uso de memoria por debajo del 100% para evitar errores de OOM (falta de memoria).Deja espacio para procesos del sistema y la orquestación de SkyPilot.Valores alternativos:0.6 → Conservadoramente bajo, puede subutilizar la potencia de la GPU.0.9-1.0 → Riesgo de desbordamiento de memoria, lo que provoca fallos bajo carga pesada.
Cómo planeamos usar este sistema
Nuestro prototipo actual ha demostrado el poder de los modelos de lenguaje visual, dándonos una idea de cómo los conocimientos de diseño pueden moldear las decisiones de producto. Y apenas estamos comenzando. Hemos imaginado muchas formas de utilizar esta inteligencia visual en nuestro negocio. Al estructurar los conocimientos del modelo en un formato escalable y consistente, esta tecnología abre una amplia gama de aplicaciones en Webflow:
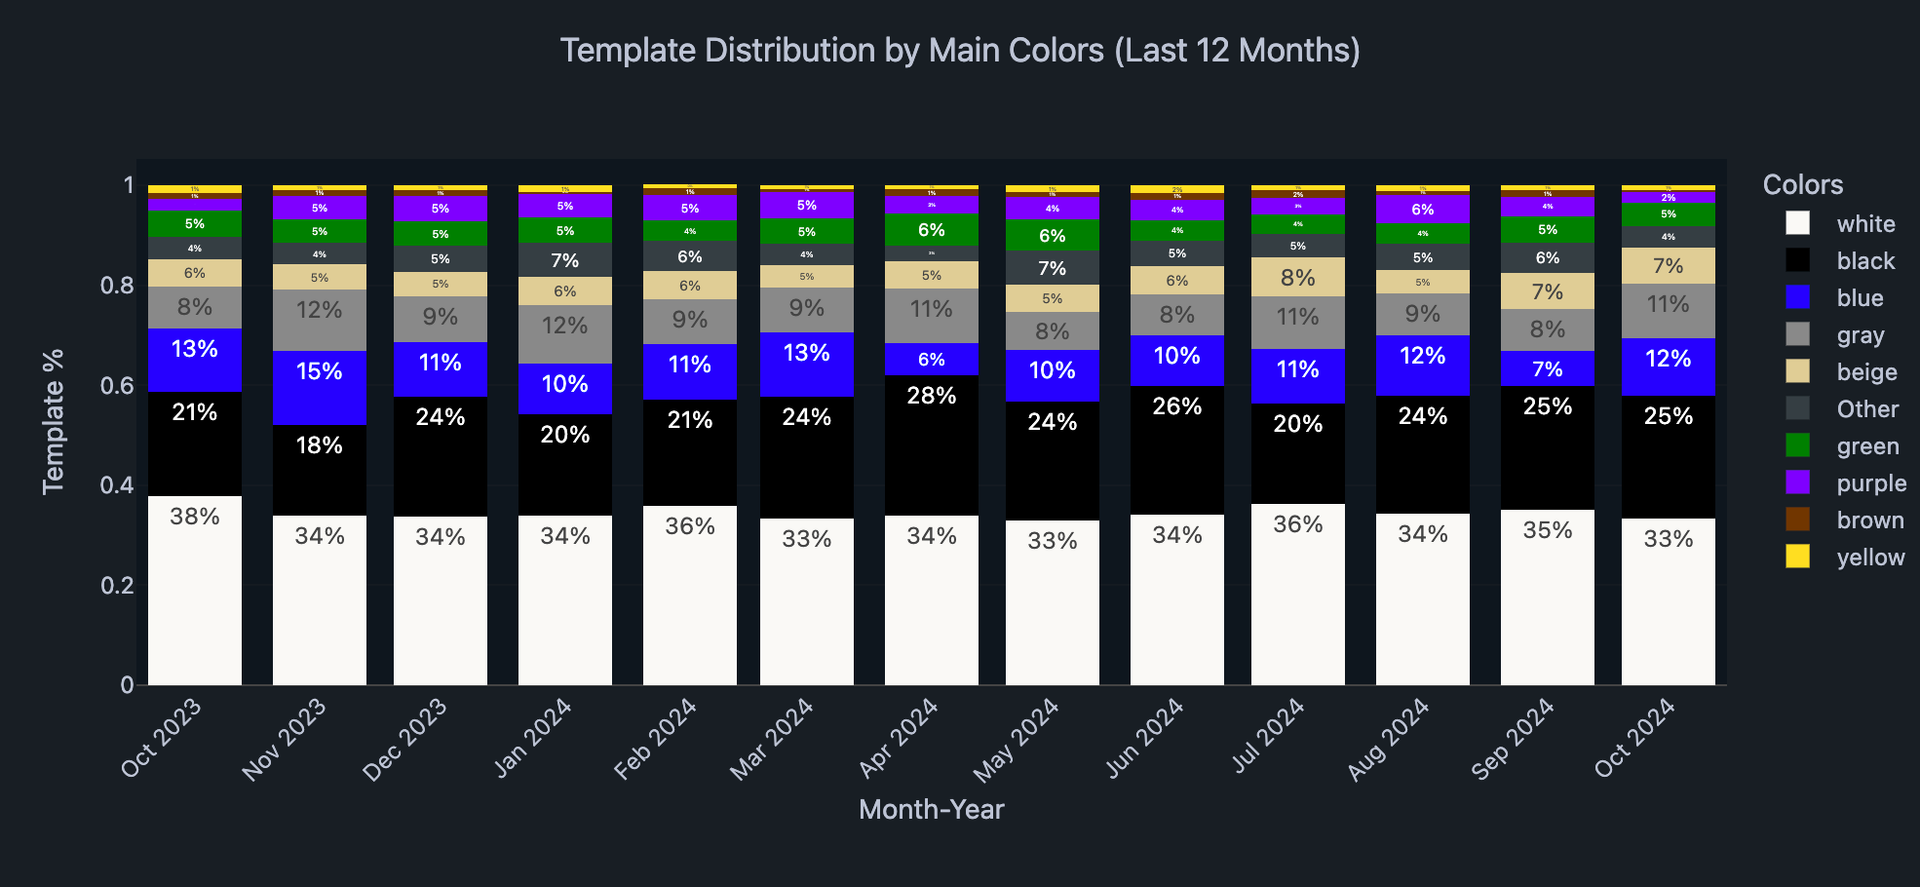
- Análisis de tendencias – Al rastrear las tendencias de diseño a lo largo del tiempo —como los cambios en las preferencias de color, el uso de tipografía y las estructuras de diseño— podemos realizar mejoras basadas en datos en las plantillas, recomendaciones de diseño y herramientas asistidas por IA de Webflow. Comprender cómo evoluciona el diseño nos ayuda a anticipar las necesidades de los usuarios y garantizar que Webflow se mantenga a la vanguardia de las tendencias de la industria.
- Habilitación de ventas – Hoy en día, los equipos de ventas a menudo preguntan si alojamos sitios de empresas en una industria específica al trabajar para cerrar acuerdos empresariales. Con este sistema, podemos mostrar ejemplos relevantes al instante, haciendo que esas conversaciones sean más rápidas y basadas en datos.
- Recomendaciones personalizadas – Para los usuarios que aprovechan Webflow Analyze, podemos ir más allá de las métricas estándar. Si un botón de llamada a la acción (CTA) tiene una tasa de conversión del 5%, podemos compararlo con sitios similares y sugerir optimizaciones, como cambiar a un botón rosa si nuestros datos muestran tasas de conversión más altas para ese color. Esta información podría integrarse perfectamente en Webflow Optimize, permitiendo a los usuarios realizar pruebas A/B de estas recomendaciones y fomentar una mejor interacción.
Al aprovechar los conocimientos impulsados por IA a escala, no solo estamos ayudando a los usuarios a crear sitios web hermosos, sino que les estamos dando los datos que necesitan para tomar decisiones de diseño más inteligentes y de alto impacto.
Conclusión
La creación de este analizador de sitios ejemplifica cómo Webflow aprovecha la IA de vanguardia y las herramientas de código abierto para resolver desafíos complejos a escala. Al integrar perfectamente modelos de lenguaje visual e infraestructura escalable, hemos desarrollado un sistema que nos permite comprender las tendencias de diseño y extraer información procesable. Este enfoque nos permite mejorar nuestras ofertas de plataforma e impulsar la innovación futura de manera efectiva.
En Webflow, constantemente superamos los límites de la innovación en aprendizaje automático e IA para ofrecer valor a nuestros usuarios. Si te atrae enfrentar desafíos emocionantes como estos, echa un vistazo a nuestra página de Carreras: ¡nos encantaría que te unieras al equipo!

¡Estamos contratando!
Buscamos talento en producto e ingeniería para que se una a nuestra misión de poner superpoderes de desarrollo al alcance de todos.