









Los agentes pueden generar respuestas; los datos gobernados, la experiencia codificada y los controles arquitectónicos hacen que esas respuestas sean confiables.
Mientras Webflow construye la plataforma de marketing web basada en agentes, nuestro equipo de Datos e Insights aplicó la misma mentalidad de "IA primero" a la toma de decisiones interna. Un agente puede escribir SQL válido y aun así producir una respuesta de negocio incorrecta. Una pregunta se volvió central: ¿qué debe cumplirse para que un agente produzca un trabajo en el que las personas puedan confiar?
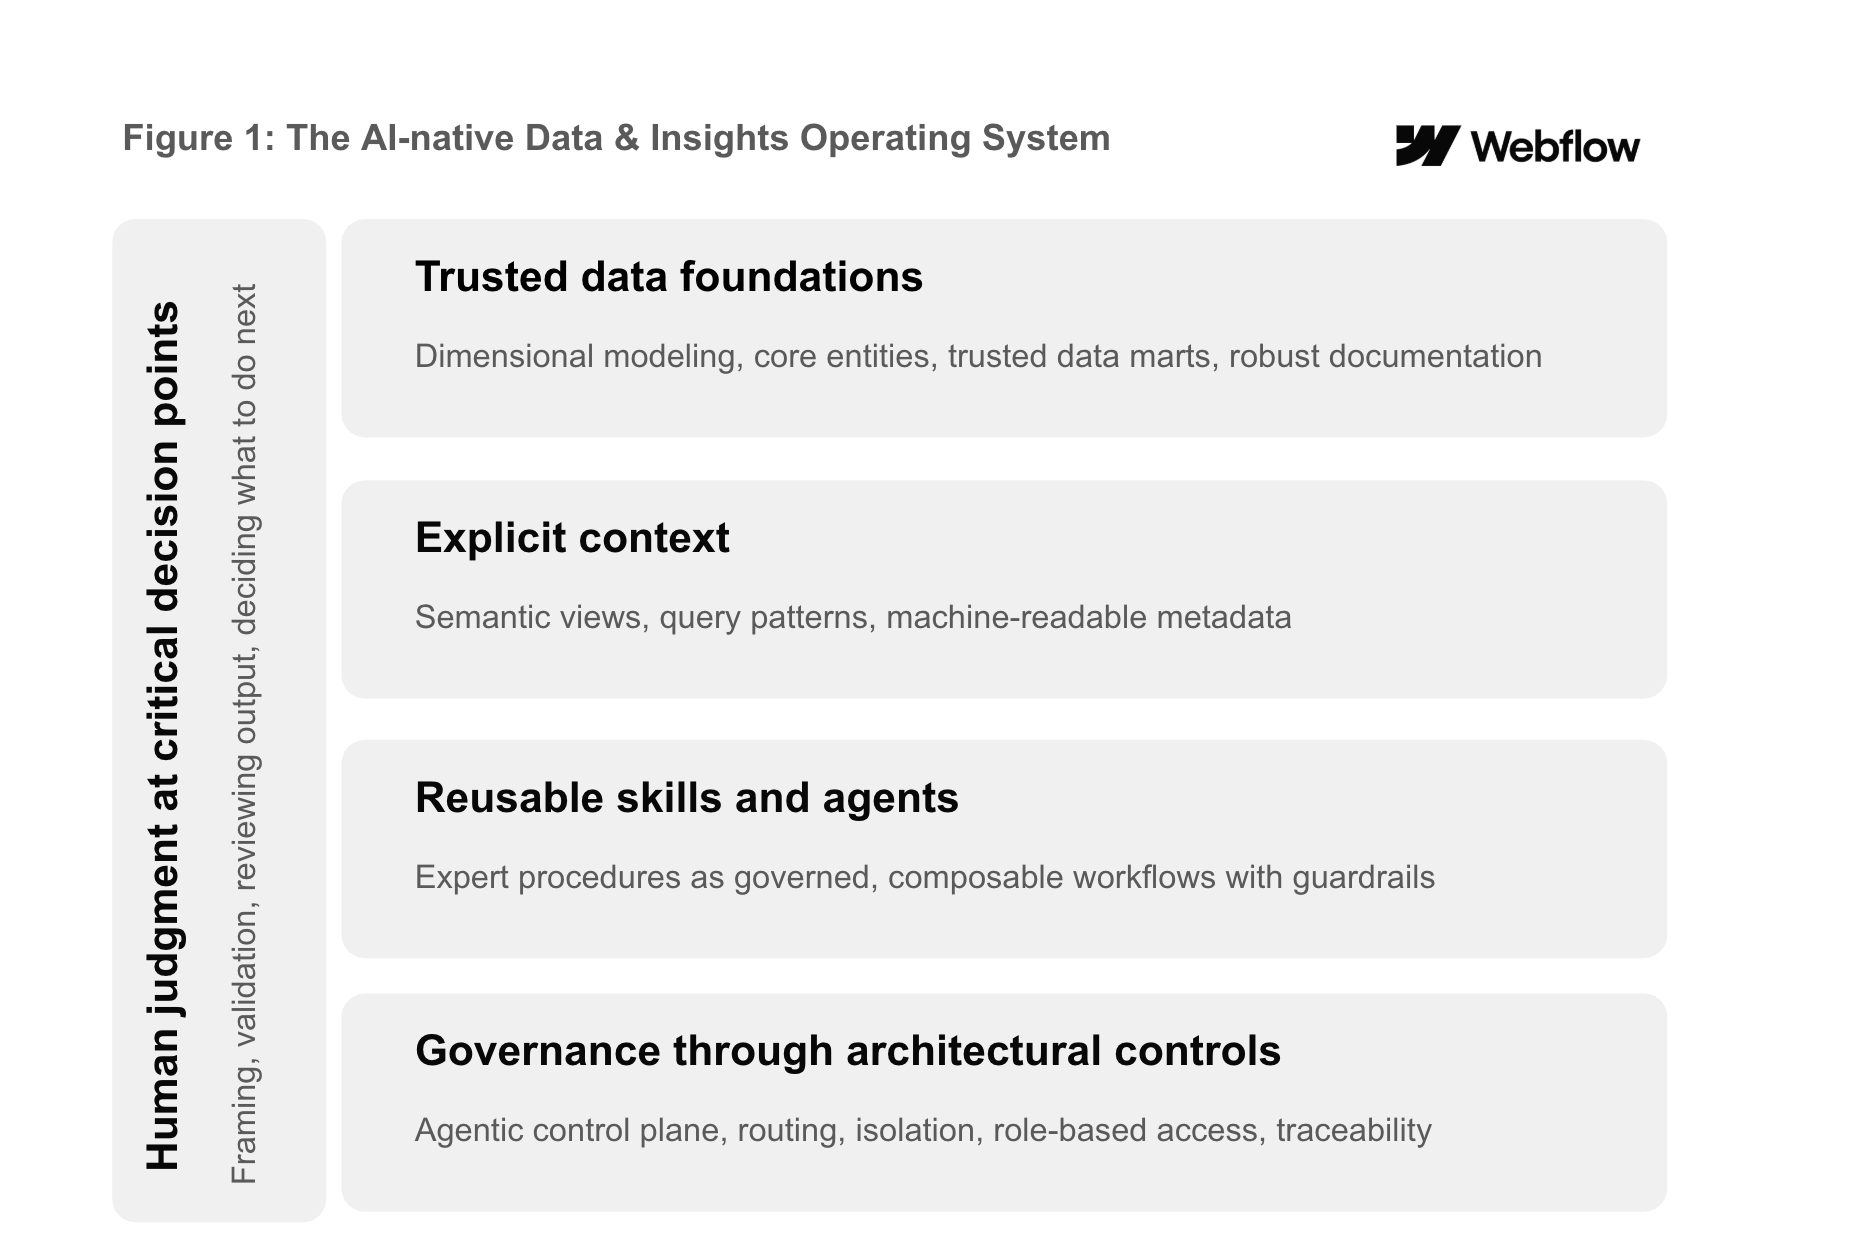
Nuestro equipo abarca la ingeniería de plataformas de datos, la ingeniería de análisis, la inteligencia de negocios y la ciencia de datos. Para construir un análisis de autoservicio confiable, primero tuvimos que convertirnos en usuarios eficaces de la IA y en constructores de agentes. El uso de agentes en nuestros propios flujos de trabajo nos mostró dónde generaban valor, dónde fallaban y qué contexto, estándares, puntos de revisión y controles necesitaban para operar de manera confiable. Esa experiencia también nos obligó a codificar la experiencia que antes residía en flujos de trabajo individuales. Aprendimos que hacer que el equipo sea nativo en IA y permitir un análisis de autoservicio confiable en todo Webflow no son transformaciones separadas. Ambas dependen del mismo sistema operativo: datos gobernados, contexto de negocio ejecutable, habilidades y agentes reutilizables, controles arquitectónicos y juicio humano.
Generar una consulta es fácil. El desafío más difícil es codificar las definiciones de negocio, las fuentes aprobadas, los permisos y las expectativas de revisión de Webflow para que un agente pueda operar de manera confiable. Un sistema operativo nativo en IA debe seguir evolucionando con las necesidades del negocio y las formas de trabajar. En este artículo, compartimos lo que construimos, cómo cambió nuestro trabajo y el impacto que estamos viendo.
El análisis de autoservicio confiable comienza con un equipo nativo en IA
Antes de poder ofrecer respuestas confiables a gran escala, necesitábamos hacer que la IA fuera parte de la forma en que trabajaba nuestro propio equipo. El acceso a un asistente de IA no era suficiente. Integramos una mentalidad de "Agente primero" en las normas del equipo y las expectativas profesionales, rediseñamos los flujos de trabajo y protegimos el tiempo para el aprendizaje y la experimentación.
Las nuevas ideas podían probarse libremente, mientras que las habilidades y el contexto reutilizables se enviaban a repositorios centralizados y se organizaban por nivel de madurez y confianza. Los defensores de la IA y los foros semanales ayudaron al equipo a compartir ejemplos prácticos, resolver problemas recurrentes y convertir el aprendizaje individual en capacidades compartidas del equipo. Este cambio generó eficiencias inmediatas y nos dio experiencia de primera mano colaborando con agentes.
El equipo adoptó una pregunta recurrente: ¿Cómo podríamos hacer esto con un agente?
El sistema operativo
Escalar el análisis de autoservicio confiable requería un sistema operativo más amplio que los agentes pudieran navegar de manera confiable y en el que las personas pudieran confiar.
Comience con cimientos de datos confiables
Durante la última década, Webflow acumuló cientos de fuentes, tablas y modelos creados para expertos humanos, no para agentes. Elegir el activo correcto a menudo dependía del conocimiento tribal sobre qué tablas estaban actualizadas, cómo se asignaban los identificadores entre sistemas y qué definiciones se aplicaban. Los agentes hicieron que esa ambigüedad fuera más trascendental. El año pasado, comenzamos un esfuerzo de varios trimestres para reconstruir nuestro almacén de datos empresarial utilizando el modelado dimensional de Kimball. Los esquemas en estrella modulares ahora estandarizan hechos, dimensiones, identificadores y taxonomías en todos nuestros datos. Los mercados de datos gobernados, un diccionario de datos con capacidad de búsqueda y un flujo de trabajo de catálogo automatizado proporcionan una fuente de verdad común y documentada.
Construcción de mercados de datos centrados en el negocio con entidades estandarizadas
Anteriormente, la lógica de entidades duplicada, el mapeo de identificadores inconsistente y las definiciones de métricas a la deriva creaban resultados contradictorios entre los equipos. La nueva capa central estandariza siete entidades maestras. Cada nuevo modelo de hechos utiliza estas dimensiones estandarizadas, mientras que una clave de cliente común reconcilia los espacios de trabajo de autoservicio y las identidades de cuentas de ventas para un análisis consistente a nivel de cliente.
Además de ese núcleo, los mercados de datos gobernados sirven como capas de consulta confiables para varios casos de uso, reemplazando los informes fragmentados con datos listos para la toma de decisiones, diseñados específicamente para la forma en que trabaja cada equipo. Un mercado "Customer 360" combina datos de clientes y productos, con señales de adopción de productos que fluyen hacia Salesforce para apoyar a los equipos de campo con actualizaciones, retención y movimientos de expansión. Un mercado de ARR proporciona informes reconciliados de ingresos recurrentes y retención neta en dólares por cliente, suscripción y producto. Otros mercados gobernados cubren la adopción de productos, los viajes de los clientes, los embudos de marketing, el pipeline y las reservas, los créditos de IA, la utilización de asientos y el uso del sitio.
Incorpore la confiabilidad en los cimientos
Un cimiento de datos confiable no puede depender de que las personas o los agentes recuerden qué fuentes, definiciones y estándares usar. Codificamos esos controles directamente en los cimientos.
Los estándares de modelado, las definiciones semánticas y la documentación de referencia conviven en un repositorio con control de versiones, mientras que las herramientas dirigen a los agentes primero hacia los modelos confiables. El agente de revisión de PR verifica cada cambio en dbt en busca de violaciones arquitectónicas, desviaciones en los nombres, pruebas faltantes, exposición de PII y dependencias de activos no certificados. El trabajo posterior debe construirse sobre la capa confiable, con pruebas que detecten efectos no deseados antes de que los cambios se fusionen. El objetivo es hacer que el camino correcto sea el más fácil tanto para las personas como para los agentes.
Haz que el contexto empresarial sea ejecutable
Un almacén de datos gobernado es necesario, pero no suficiente. Los agentes también necesitan entender qué significa para Webflow el "ARR", un "cliente" o la "utilización de licencias", y cómo se relacionan esos conceptos con los datos. Creamos activos de contexto gobernados para que esas definiciones sean explícitas y utilizables por los agentes.
Vistas semánticas
Las vistas semánticas actúan como un contrato entre el lenguaje empresarial y los datos gobernados. Codifican métricas, dimensiones, relaciones y terminología aprobadas como código con control de versiones, lo que permite que los clientes de IA y los flujos de trabajo posteriores utilicen los mismos cálculos. Junto con los modelos de almacén y los metadatos, forman una capa de contexto legible por máquina, para que la lógica empresarial no viva solo en paneles o en la memoria de las personas. Los agentes pueden confiar en estas definiciones mantenidas centralmente en lugar de inferir el significado a partir de nombres de tablas y columnas.
Preguntas como "¿Cuál es el NDR por segmento?" ahora pueden responderse a partir de una definición de métrica validada en lugar de SQL improvisado. Nuestro Agente de Autoría de Vistas Semánticas ayuda a crear vistas semánticas de Snowflake a escala, mientras que los humanos mantienen la propiedad de las definiciones.
Patrones de consulta y contexto empresarial
Codificamos los análisis recurrentes como patrones específicos de dominio que definen la granularidad, los filtros, las suposiciones y los modos de fallo conocidos, partiendo de una lógica revisada en lugar de reconstruir el enfoque cada vez. Un repositorio legible por máquina organiza los metadatos de ciencia de datos, el contexto organizacional y el trabajo analítico para los agentes, creando un camino desde la perspectiva individual hasta el conocimiento institucional compartido.
Codifica flujos de trabajo expertos como habilidades y agentes
Mientras que las definiciones semánticas resuelven el significado empresarial, las habilidades gobiernan la ejecución. Nuestra mayor inversión ha sido codificar los procedimientos analíticos y los estándares de revisión de Webflow en flujos de trabajo repetibles que definen las fuentes y herramientas permitidas, los pasos de ejecución, los requisitos de validación, la revisión humana, el manejo de ambigüedades y la evidencia. Cada disciplina aplica este enfoque a su propio trabajo.
Operar la plataforma de datos con experiencia reutilizable
El trabajo en la plataforma de datos abarca sistemas de producción, repositorios y modos de fallo, lo que a menudo requiere experiencia distribuida. Creamos un mercado de complementos para crear, versionar, instalar y compartir esa experiencia, con actualizaciones automáticas para los consumidores.
Las habilidades cubren las operaciones principales: el triaje de calidad de datos diagnostica fallos mientras preserva las salvaguardas de producción de solo lectura; la validación del almacén de análisis compara los datos ingeridos con la fuente de registro; las habilidades de orquestación inspeccionan los conductos y coordinan los rellenos y trabajos de despliegue; y las habilidades de transmisión admiten operaciones de temas, conectores, grupos de consumidores y esquemas. Estos flujos de trabajo reducen la dependencia del conocimiento tribal y el cambio de interfaz.
Construir datos gobernados con flujos de trabajo componibles
La ingeniería de análisis creó una biblioteca de habilidades de cuatro niveles: los orquestadores gestionan flujos de trabajo de extremo a extremo, los coordinadores proporcionan experiencia de dominio y puntos de control, las habilidades funcionales completan los pasos del ciclo de vida y las habilidades primitivas realizan operaciones reutilizables. Esta estructura hace que la biblioteca sea componible y auditable, a la vez que ofrece a cada ingeniero de análisis respuestas consistentes a dos preguntas: ¿qué debo construir y dónde debe vivir?
El equipo utiliza un flujo de trabajo conectado: el Agente de Autoría dbt redacta SQL, YAML, pruebas y documentación para revisión humana; el Agente de Revisión de PR verifica el cambio frente a los estándares de ingeniería; y el Agente de Seguimiento aborda las advertencias diferidas. Los servicios de Cursor orquestan este flujo de trabajo, mientras que una interfaz de Slack permite al equipo investigar errores de datos sin cambiar de contexto.
Convertir datos gobernados en perspectivas y decisiones confiables
El equipo de ciencia de datos creó un laboratorio para publicar habilidades en tres niveles de madurez: experimental para borradores, estable para flujos de trabajo probados y compartido para uso interfuncional. La promoción requiere una revisión basada en la audiencia prevista.
Las habilidades apoyan el diseño de análisis, la previsión y la revisión del planteamiento de preguntas, mientras que los agentes coordinados apoyan el análisis descriptivo, el dimensionamiento de oportunidades, la investigación de causas raíz, el análisis de cohortes y el análisis de tendencias. Las barandillas compartidas incluyen definiciones de campos, filtros y recetas de consulta centradas en el catálogo; puertas de frescura que detienen los flujos de trabajo obsoletos o incompletos a menos que se aprueben explícitamente; umbrales de materialidad que se centran en cambios significativos; y comprobaciones epistémicas que sacan a la luz definiciones y suposiciones ambiguas. Cada respuesta está etiquetada como CONFIRMADA o INFERIDA para hacer explícita su procedencia.
Hacer cumplir la gobernanza mediante controles arquitectónicos
La gobernanza analítica tradicional dependía de un conducto en capas de datos certificados y paneles controlados. Los agentes pueden saltarse ambos y consultar los datos directamente, por lo que las barandillas no pueden vivir solo en avisos o documentos de política. La atención de un agente se distribuye entre habilidades, conocimiento preentrenado, documentos, contexto de conversación y tablas de almacén en competencia. Por lo tanto, la gobernanza debe situarse fuera de la ventana de contexto.
Hemos creado un plano de control para agentes que limita el camino antes de que un agente pueda seleccionar una fuente no regulada. Un Registro de Habilidades Empresariales versiona y despliega habilidades reguladas en los clientes de IA compatibles, permitiendo que la gobernanza acompañe a los usuarios a través de las distintas interfaces.
Un camino determinista hacia respuestas reguladas
Volviendo al ejemplo de NDR, cada interacción regulada sigue cuatro pasos que eliminan las decisiones en las que el agente podría equivocarse (ver Figura 2).
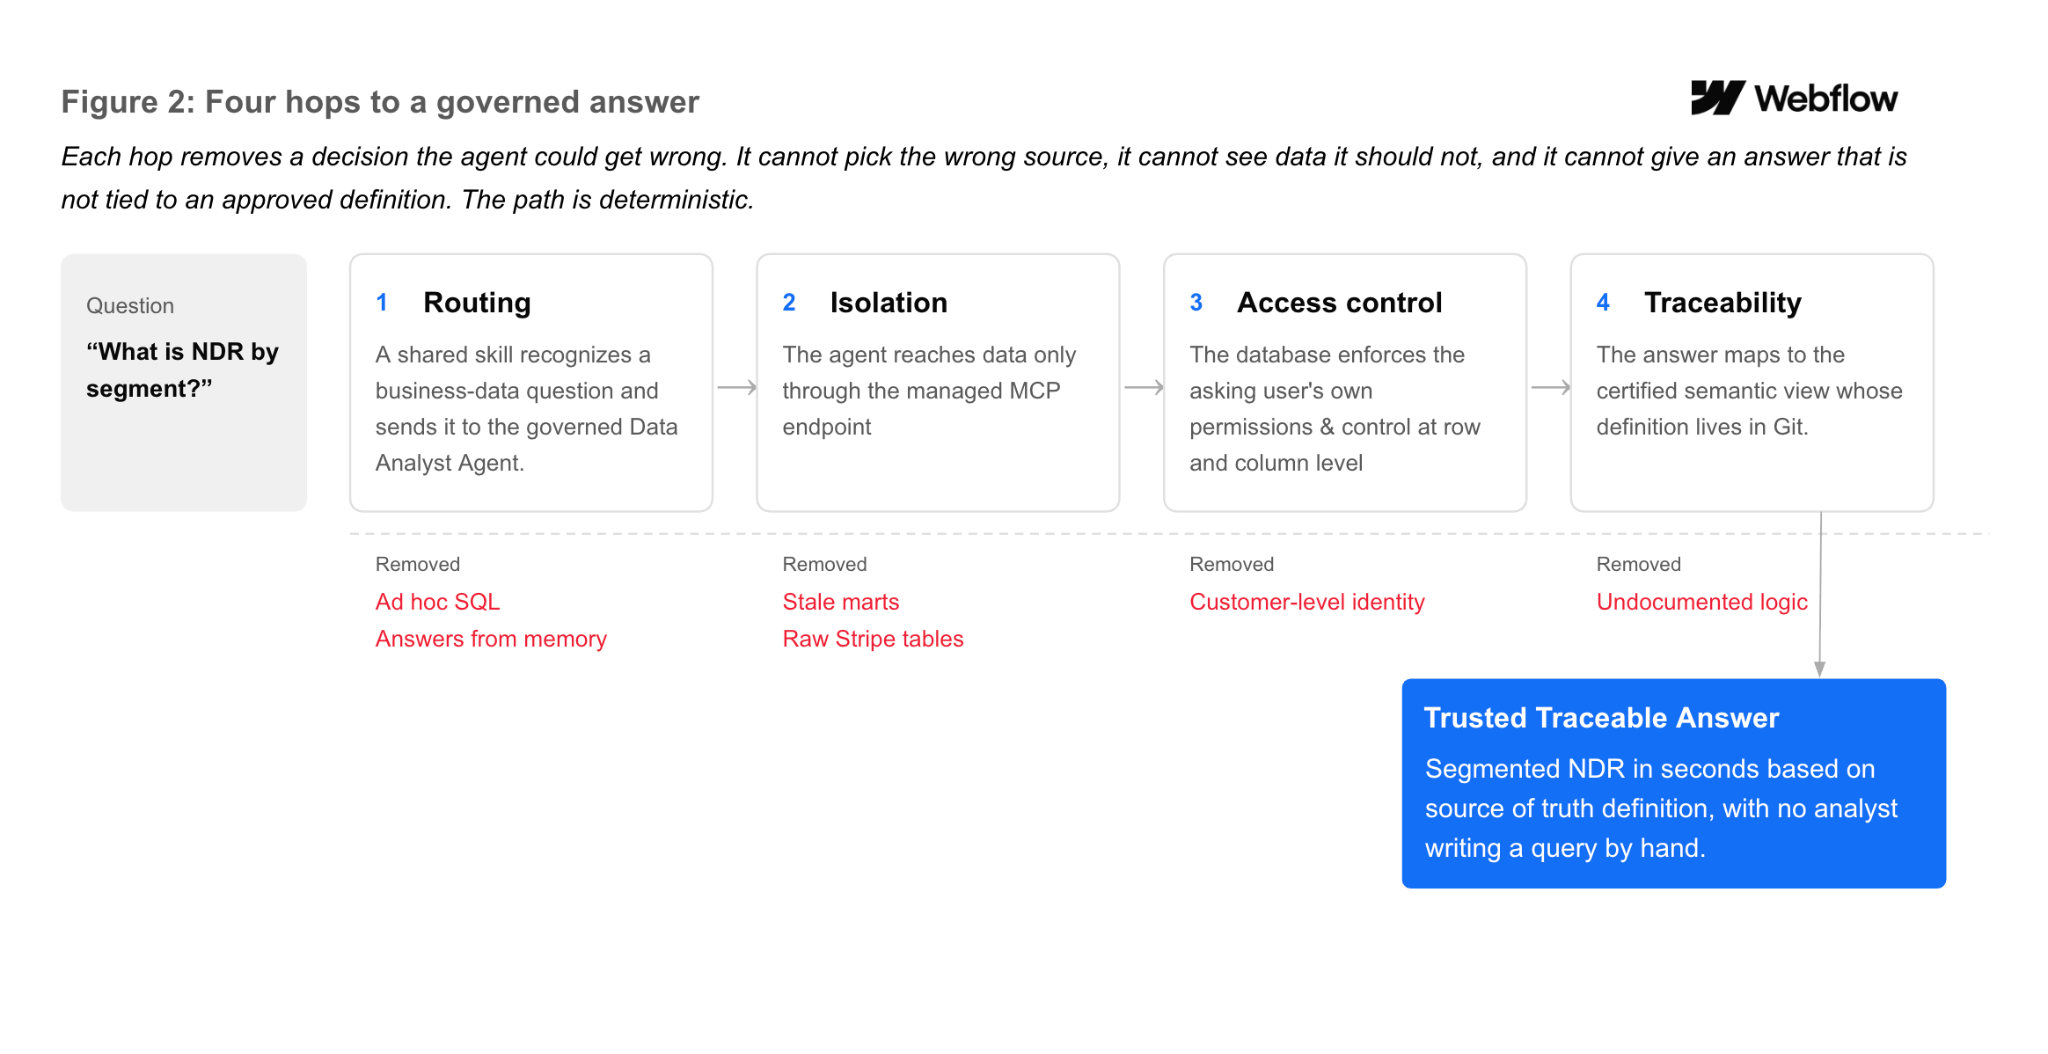
Estos controles limitan las fuentes disponibles, las definiciones de métricas y los permisos, reduciendo las decisiones de alto riesgo que quedan en manos del agente de frontend. No eliminan los fallos, ya que el agente aún debe interpretar la intención del usuario, pero estrechan los caminos disponibles y hacen que las desviaciones sean más fáciles de detectar.
Validación del plano de control
Los controles arquitectónicos solo importan si los agentes y las habilidades que los respaldan se prueban antes del lanzamiento y se evalúan continuamente después. Hemos creado dos sistemas para apoyar esto.
Antes del lanzamiento, nuestro marco de evaluación de fiabilidad prueba los agentes y las habilidades a escala y controla qué versiones llegan a producción. Tras el lanzamiento, el Gobernador revisa cada ejecución, verifica si la respuesta provino de una fuente regulada y devuelve un veredicto de "certificar" o "advertir". Esto ofrece a los usuarios una señal de confianza visible para cada respuesta.
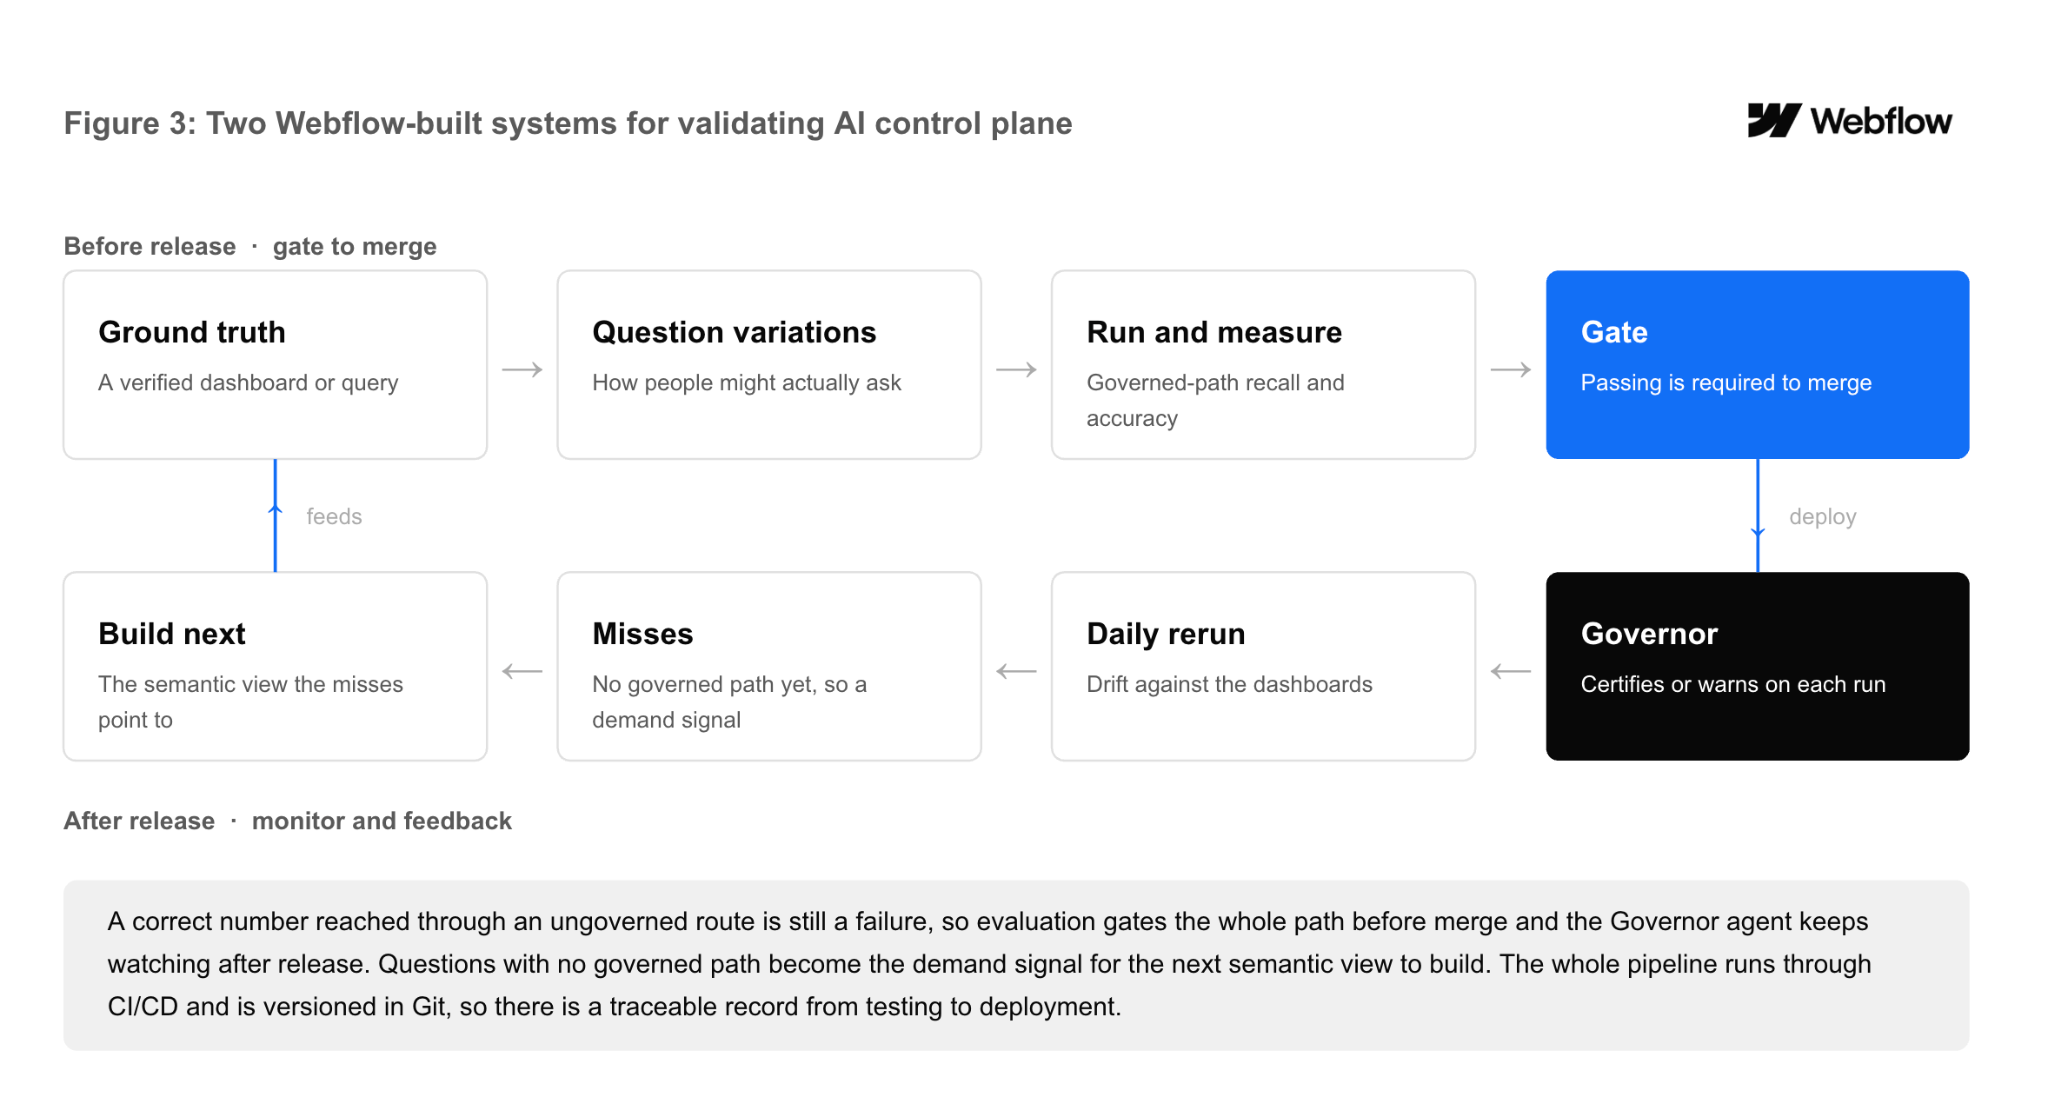
Como muestra la Figura 3, los hallazgos del monitoreo en producción alimentan la siguiente ronda de pruebas y determinan qué construiremos a continuación, creando un ciclo de retroalimentación continua.
Impacto en todo el ciclo de vida de los datos
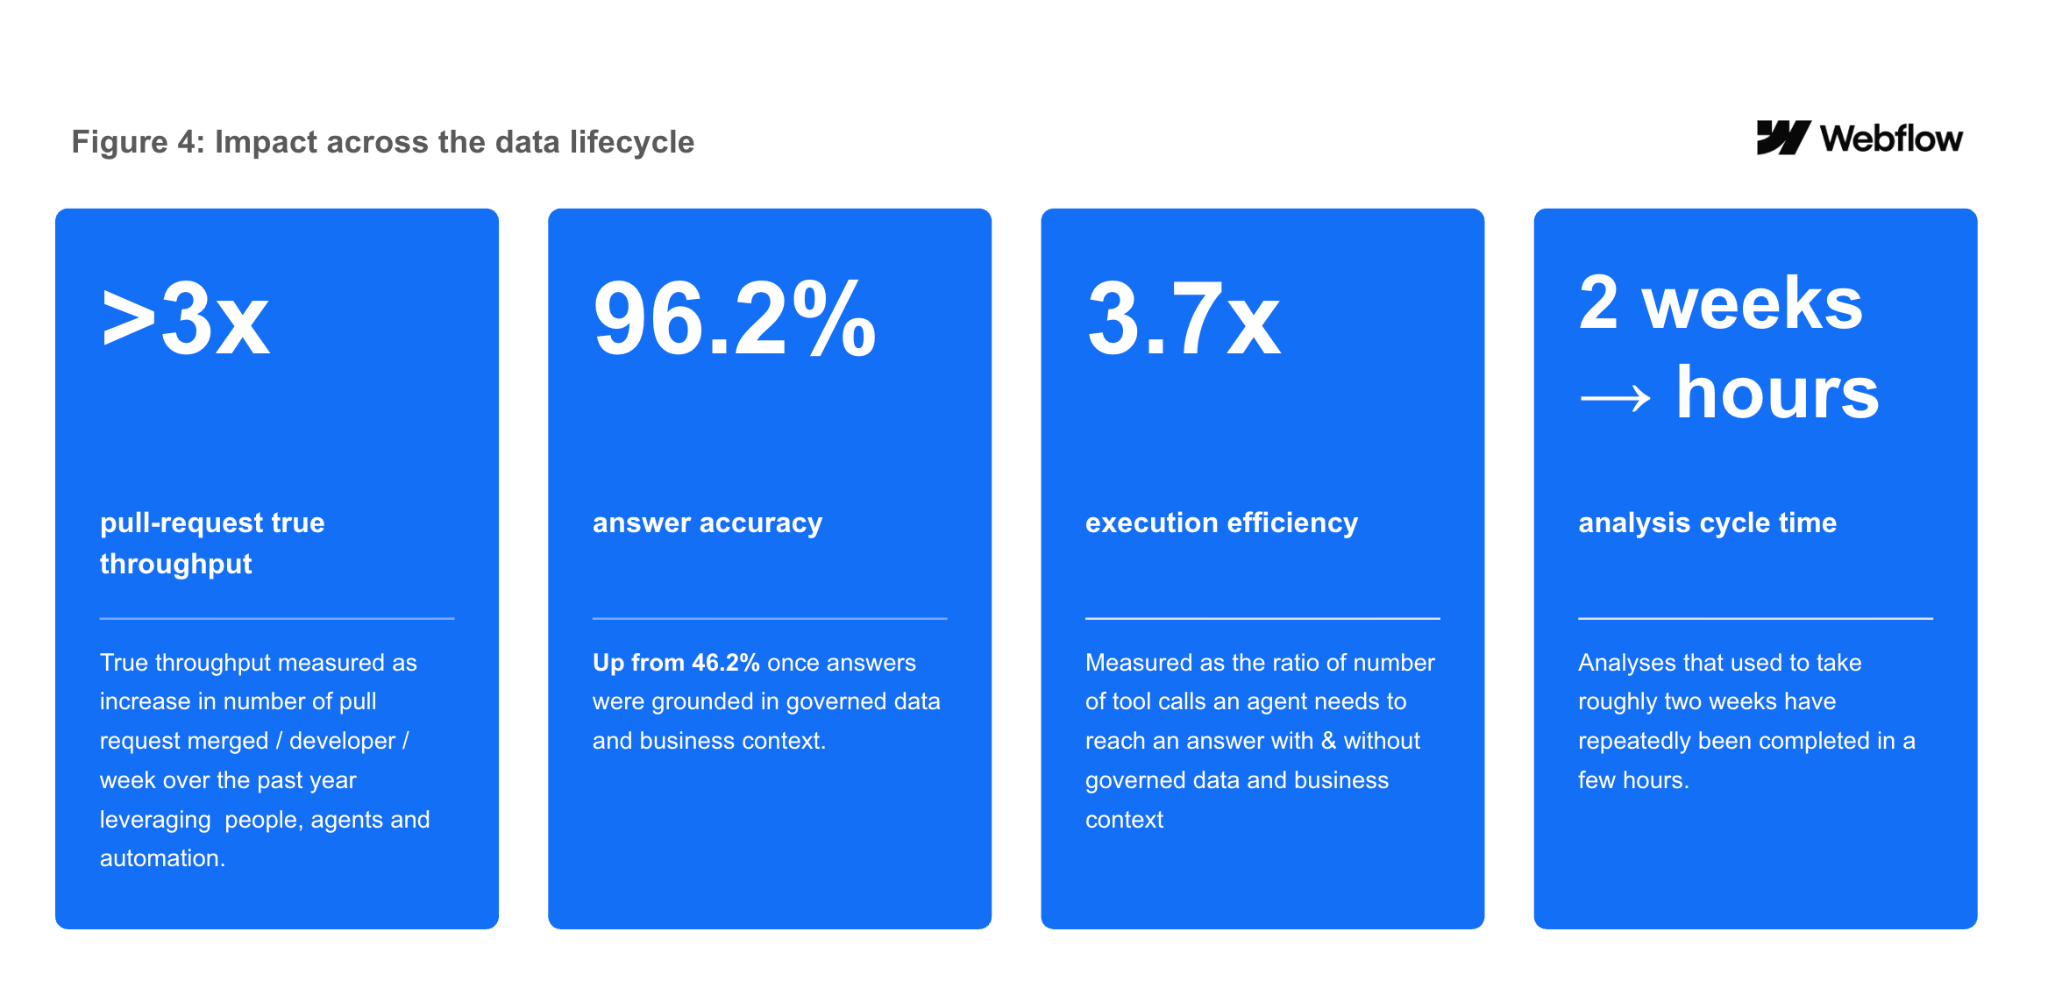
El impacto abarca las operaciones de equipo, la velocidad de entrega y el acceso a respuestas confiables en todo Webflow (ver Figura 4). En conjunto, estos cambios ahorran tiempo, aceleran la entrega de activos y los ciclos de análisis a decisión, y mejoran la calidad de las decisiones mientras amplían el autoservicio de análisis confiable sin debilitar la gobernanza.
Entrega de ingeniería más rápida y operaciones de datos más eficientes
En toda la plataforma de datos y la ingeniería de análisis, el rendimiento real de las solicitudes de extracción (pull requests) aumentó más de 3 veces durante el último año, reflejando el resultado combinado de personas, agentes y automatización. Los agentes ahora apoyan la creación, revisión, investigación de incidentes y seguimiento, manteniendo la aprobación humana donde se requiere criterio.
Los agentes han resuelto incidentes de calidad de datos en producción de principio a fin, identificando dependencias posteriores y abriendo solicitudes de extracción con diagnósticos y soluciones. El trabajo que antes requería una investigación manual ahora puede completarse en minutos.
Mayor velocidad de análisis y apalancamiento estratégico
Hemos completado repetidamente análisis en unas pocas horas que antes habrían tomado aproximadamente dos semanas, mientras que los tiempos de ciclo para las investigaciones de métricas y los análisis de causa raíz también han disminuido.
Los científicos de datos ahora tienen más capacidad para el trabajo estratégico y pasan más tiempo revisando los resultados de los agentes, aplicando criterio empresarial y traduciendo el análisis en acción. El rol está cambiando de producir un número correcto a recomendar qué debe hacer el negocio. Esto ha cambiado la forma en que diseñamos los agentes: nos enfocamos en flujos de trabajo que involucran a personas donde su criterio es más valioso, en lugar de automatizar un análisis completo de una sola vez.
Un camino regulado hacia el autoservicio de análisis confiable
Estos cimientos están empezando a permitir un acceso más amplio a conocimientos regulados en todo Webflow. Nuestro Agente de Analista de Datos admite métricas reguladas en productos, finanzas y ventas.
Los primeros usuarios pueden hacer preguntas a través de una interfaz de IA familiar, mientras que el plano de control dirige cada pregunta a vistas semánticas certificadas, aplica controles de acceso y vincula la respuesta a una definición aprobada. A medida que ampliamos el acceso y la cobertura de métricas, podemos ofrecer respuestas más rápidas sin sacrificar la consistencia, la seguridad o la trazabilidad.
En nuestro conjunto de evaluación interna, fundamentar a los agentes en un contexto regulado y controles arquitectónicos aumentó la precisión de las respuestas del 46,2% al 96,2% y mejoró la eficiencia de ejecución en 3,7 veces, medido por el número de llamadas a herramientas necesarias para llegar a una respuesta. Anthropic informó un aumento del 21% a más del 95% una vez que los flujos de trabajo analíticos se codificaron como habilidades reutilizables; Snowflake informó un aumento del 25% al 86% con un contexto empresarial mejorado; y dbt Labs informó un aumento de aproximadamente el 90% para texto a SQL sin procesar al 98–100% con una capa semántica regulada. Aunque estos puntos de referencia utilizan diferentes metodologías, muestran un patrón consistente: el contexto empresarial confiable, no solo el modelo, es lo que impulsa respuestas fiables.
Lo que hemos aprendido
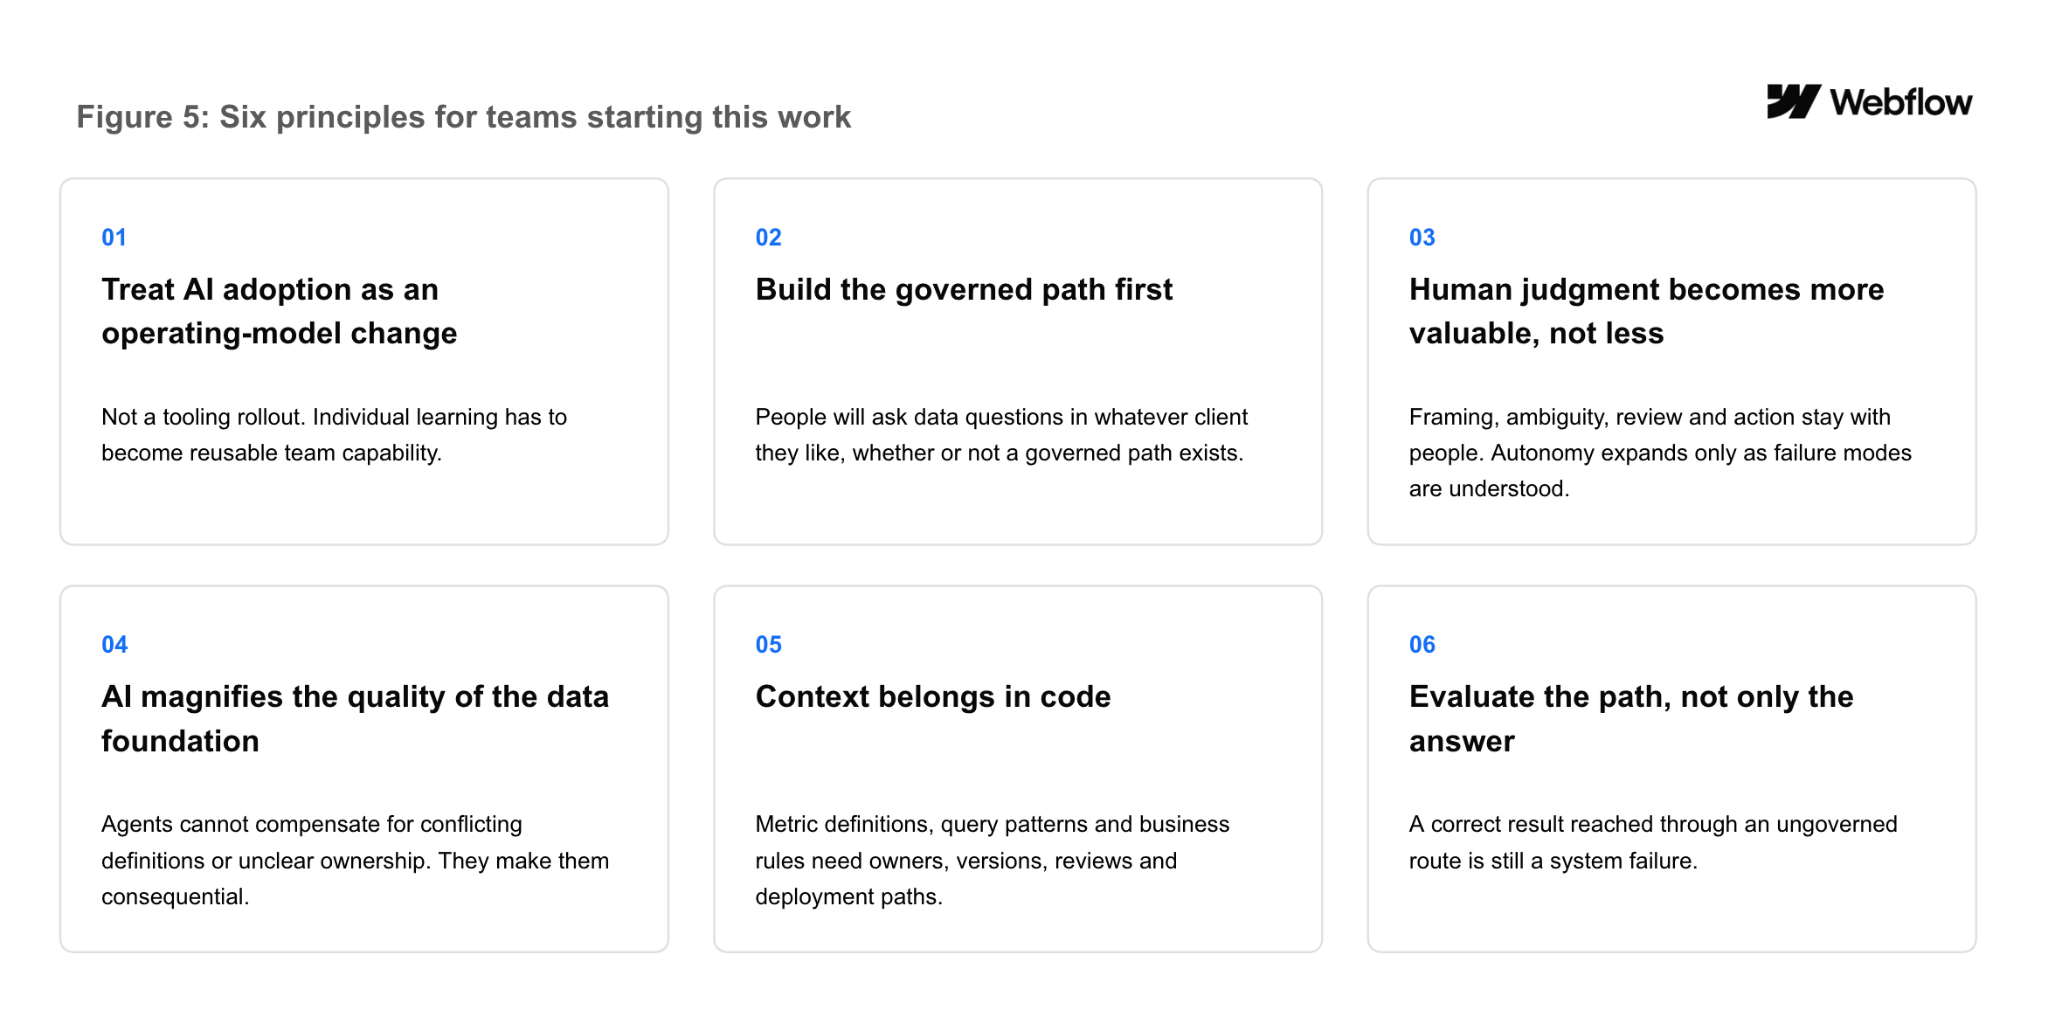
La figura 5 resume seis principios basados en nuestra experiencia creando y escalando un sistema operativo de datos e insights nativo de IA.
El gran cambio
Esto no ha hecho más que empezar. A medida que ampliamos estas capacidades, el siguiente reto es detectar respuestas plausibles pero incorrectas antes de que influyan en la toma de decisiones. Esto implica mostrar la frescura, procedencia, supuestos y nivel de confianza; reforzar la evaluación; y mantener la revisión humana allí donde los errores tengan un alto coste. Otra frontera es la creación de sistemas analíticos autónomos de ciclo cerrado que abarquen desde la recepción de preguntas hasta el modelado y ejecución dinámicos, basados en el significado de negocio derivado del código, con aprobación humana en puntos críticos.
En última instancia, un equipo de datos e insights nativo de IA no se define por cuántos agentes construye, sino por si la IA opera dentro de un sistema fiable de datos gobernados, contexto explícito, flujos de trabajo reutilizables, controles arquitectónicos, calidad medible y criterio humano. Empezamos preguntándonos cómo podían ayudarnos los agentes a trabajar de otra forma. Ahora avanzamos hacia un objetivo mayor: analítica de autoservicio fiable para más personas, un camino más corto de la pregunta a la decisión y mejores decisiones sin comprometer la gobernanza. Esa es la promesa de un sistema operativo de datos e insights nativo de IA.


















