

Crear un sitio web atractivo y funcional es solo el primer paso.
El verdadero desafío comienza cuando llega el momento de optimizar para lograr conversiones, interacción y resultados de negocio. Los equipos invierten innumerables recursos en atraer visitantes, pero ¿qué sucede después? ¿Cómo te aseguras de que cada clic cuente?
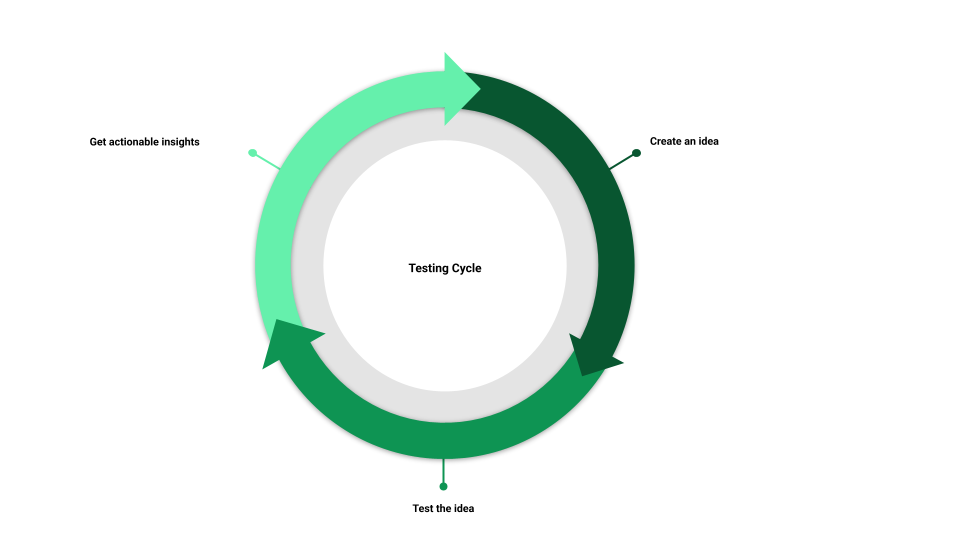
En Webflow, nos propusimos responder a esa pregunta con Webflow Optimize, una herramienta impulsada por IA diseñada para ayudar a los clientes a probar, analizar y mejorar sus sitios web. Nuestro enfoque sigue un ciclo estructurado: generación de ideas → pruebas → información útil → iteración.
Webflow Optimize simplifica la experiencia del usuario para que los especialistas en marketing puedan crear, probar y analizar el contenido de su sitio web, ahorrándoles un tiempo valioso. Esta solución innovadora aprovecha un sistema sofisticado que combina modelos de redes neuronales patentados e IA generativa.
Esta entrada de blog profundizará en las decisiones de ingeniería, las compensaciones y las soluciones que impulsan el motor de optimización de Webflow Optimize, y arrojará luz sobre cómo se aprovecha la IA para potenciar a los especialistas en marketing.
Sugerencias de IA: Acelerando la creación de ideas
La generación de mejoras de alto impacto para sitios web, como titulares, diseños y llamadas a la acción (CTA), a menudo se ve frenada por bloqueos creativos y limitaciones de tiempo. Para solucionar esto, creamos herramientas de IA generativa como Sugerir texto y el Generador de páginas de destino con IA.
Sugerir texto ayuda a los especialistas en marketing a elaborar titulares, CTA y otros tipos de variaciones atractivos. El Generador de páginas de destino con IA va un paso más allá, proponiendo tanto texto como sugerencias de ubicación precisas adaptadas a nuevas páginas de destino.
Al igual que con muchas aplicaciones creadas sobre modelos de lenguaje extensos (LLM), un desafío clave es garantizar que los resultados no solo sean inspiradores, sino también altamente relevantes para el contexto del usuario. Para el Generador de páginas de destino con IA, esto también significó garantizar que las ubicaciones propuestas pudieran integrarse perfectamente en la estructura de una página existente.
Para abordar estos desafíos, creamos un "rastreador" de páginas web para recopilar metadatos sobre la página web de destino, incluido el contexto detallado sobre las áreas que se están probando. También recuperamos información de pruebas en vivo de nuestro sistema interno para darle al modelo una visión completa del entorno. Debido a que la relevancia para el contexto es esencial, creamos entornos interactivos donde los usuarios podían probar sugerencias y proporcionar comentarios. Esos comentarios se destilaron en nuestros prompts.
Para validar los resultados del Generador de páginas de destino con IA, utilizamos nuestros validadores de ubicación para garantizar que las respuestas de la IA sean legítimas. En algunos casos, un toque final es inevitable; específicamente, corregir errores comunes en el código generado por IA utilizando programas especializados. Realizar esta validación final como parte de nuestro enfoque de "última milla" aumentó considerablemente la precisión del resultado.
A continuación, se muestran algunas capturas de pantalla que presentan un ejemplo de nuestras soluciones.
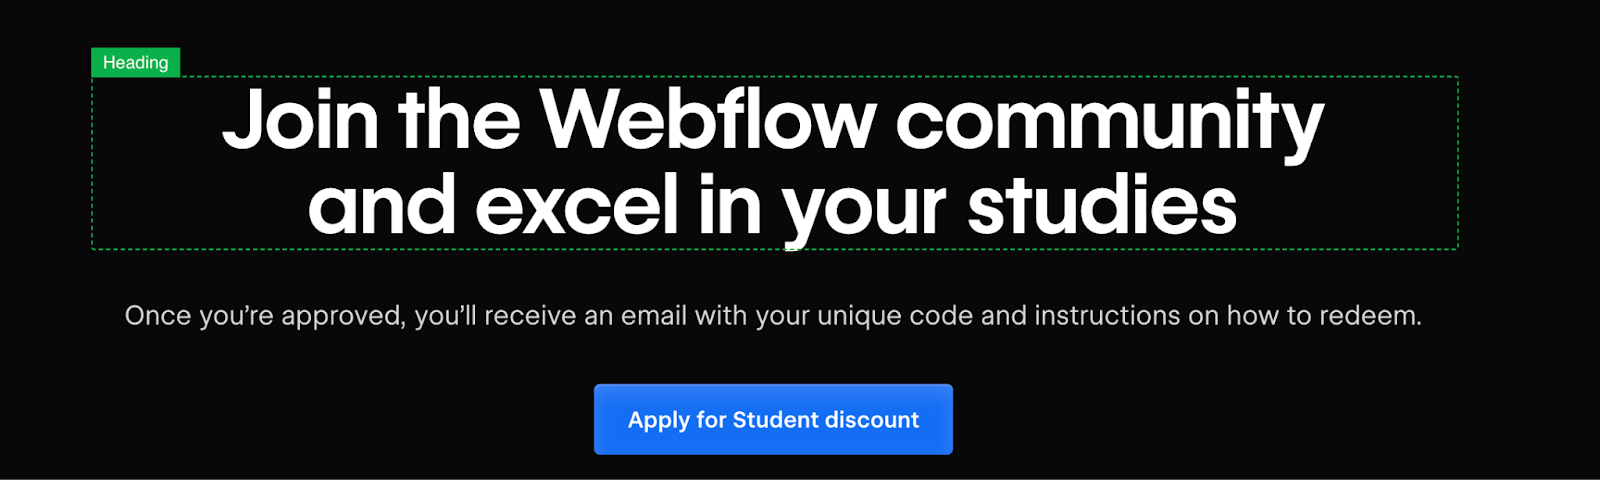
Le pedimos al Generador de páginas de destino con IA que creara una página web actualizada con la instrucción: "Actualiza esta página para atraer específicamente a estudiantes universitarios". En respuesta, sugirió cinco cambios en formato de lista.
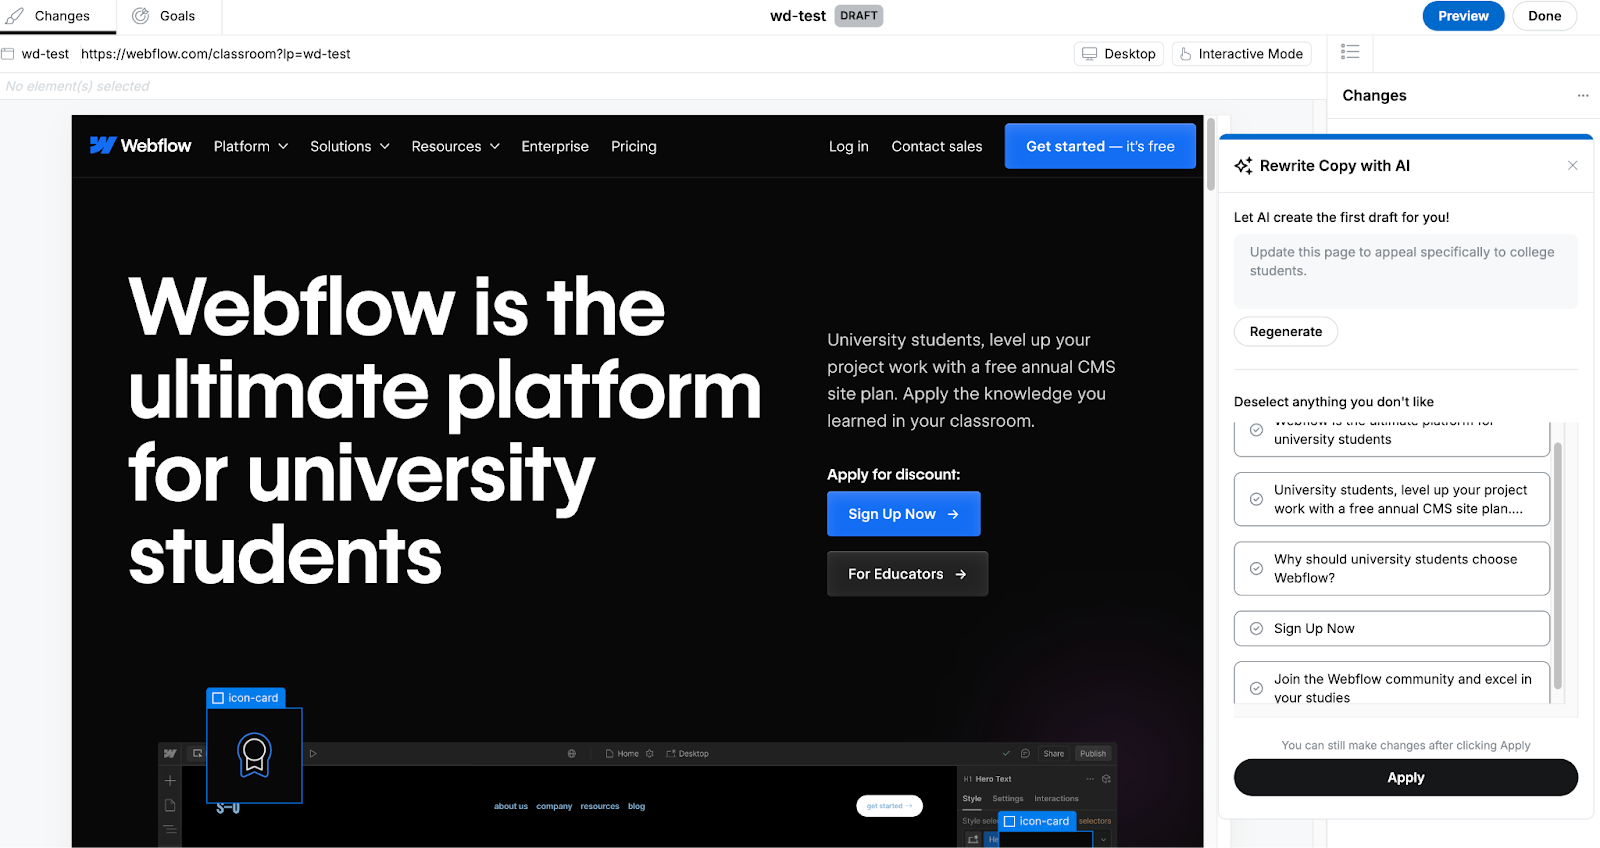
En las dos capturas de pantalla a continuación, vemos que el texto actualizado se refiere explícitamente a "estudiantes universitarios" en lugar del término más genérico "estudiantes". El resultado de la IA fue contextualmente relevante, alineándose bien tanto con el contenido circundante de la página como con la solicitud original.
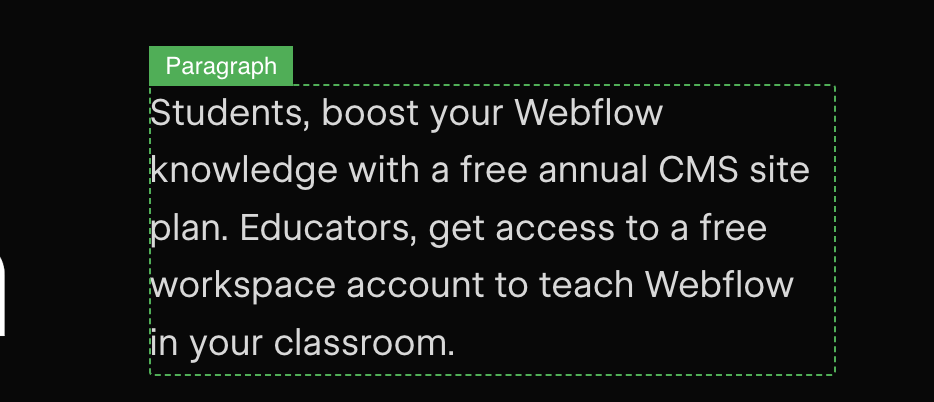
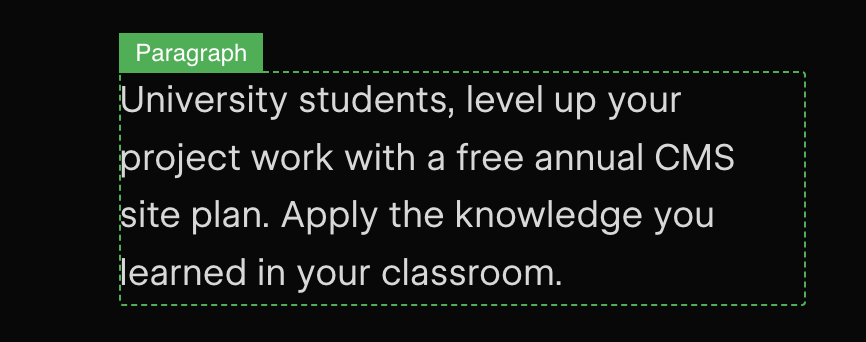
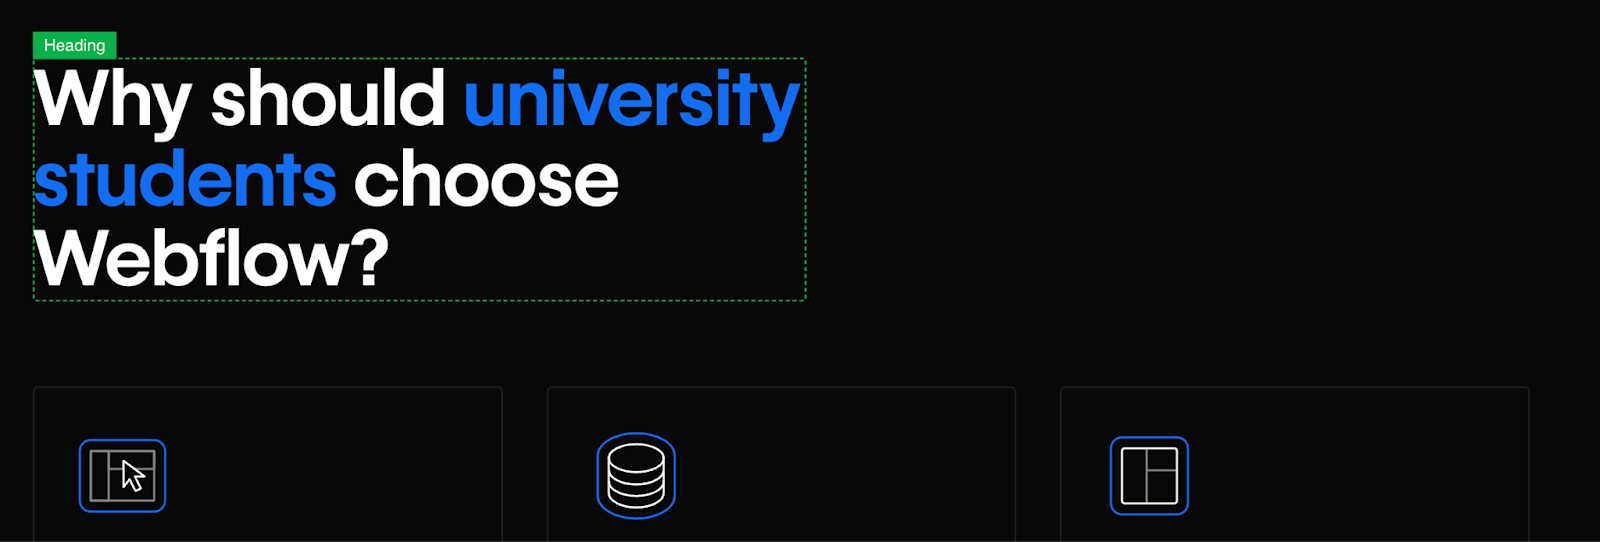
También podemos ver que la IA sugirió actualizaciones para dos elementos de encabezado por separado, lo que demuestra que los diferentes encabezados se identifican de forma única.
Pruebas optimizadas por IA: Ingeniería para la asignación dinámica de tráfico
Las pruebas A/B tradicionales dividen el tráfico de forma aleatoria entre las variantes, lo cual funciona, pero puede ser ineficiente. Las variantes con bajo rendimiento desperdician tráfico. Además, este método asume un entorno estático, pero en realidad, un ganador identificado durante un periodo específico podría no seguir siendo la mejor opción en el futuro.
Webflow Optimize adopta un enfoque más inteligente. Mediante redes neuronales bayesianas, asignamos tráfico de forma dinámica a las variantes con mejor rendimiento a medida que avanza la prueba. Al principio, el tráfico se distribuye equitativamente entre todas las variantes. Pero a medida que se acumulan los datos, el modelo comienza a predecir la probabilidad de que cada variante sea la mejor. Basándose en estas estimaciones, se dirige más tráfico hacia las variantes más sólidas, sin dejar de explorar otras para evitar el exceso de confianza. Cuando las tendencias de rendimiento cambian, la asignación de tráfico se ajusta en consecuencia, asegurando que los nuevos ganadores reciban mayor exposición.
Características del tráfico web
Es la naturaleza dinámica y de optimización continua de nuestro enfoque lo que lo distingue de los algoritmos tradicionales de bandido multi-brazo. ¿Por qué es tan importante la optimización dinámica y continua? Porque un sitio web nunca es estático. En la práctica, vemos esto reflejado de muchas maneras. El contenido cambia con frecuencia para respaldar lanzamientos de nuevos productos, promociones por tiempo limitado o campañas basadas en eventos. Las fuentes de tráfico entrante cambian regularmente a medida que evolucionan las campañas publicitarias. Incluso los patrones en el volumen de tráfico varían a lo largo de la semana, con diferencias claras entre los días laborables y los fines de semana.
Para tener en cuenta estas dinámicas específicas del dominio, nuestros procesos de entrenamiento están diseñados considerando varios aspectos técnicos. Primero, aplicamos un muestreo ponderado para asegurar que los patrones de tráfico estén equilibrados en un horizonte temporal más largo. Segundo, incluimos características contextuales como campañas publicitarias, patrones de fuentes de tráfico y tipos de dispositivos en nuestros modelos para ayudarnos a separar los factores de confusión que, de otro modo, podrían sesgar el rendimiento de las variantes.
¿Por qué redes neuronales bayesianas?
Las redes neuronales bayesianas (o redes neuronales entrenadas mediante métodos bayesianos) son un marco bien conocido con una extensa literatura y amplias aplicaciones [referencia 1, referencia 2]. Ofrecen dos ventajas clave que las hacen especialmente adecuadas para nuestro entorno: cuantificar la incertidumbre y prevenir el sobreajuste.
Cuantificar la incertidumbre ayuda al sistema a equilibrar la exploración (probar todas las variantes) con la explotación (centrarse en los candidatos sólidos). Prevenir el sobreajuste es particularmente útil en dominios donde los datos son escasos. Aunque el tráfico web pueda parecer grande, el número de muestras para cualquier combinación específica de valores de características suele ser bastante limitado.
En conjunto, estos beneficios hacen que las redes neuronales bayesianas sean especialmente adecuadas para la naturaleza volátil del tráfico web, especialmente cuando los modelos deben tener en cuenta muchas características interactivas e impactantes.
Entrenamiento
Siempre que entrenas un modelo de red neuronal con una gran cantidad de muestras, la eficiencia es una preocupación importante. Aquí tienes algunas tácticas que utilizamos en nuestro proceso de entrenamiento para aumentar la eficiencia:
Para acelerar el entrenamiento, utilizamos Apache Spark en AWS EMR (Elastic MapReduce) para una preparación de características eficiente y escalable. AWS EMR escala dinámicamente los recursos de computación, permitiéndonos procesar grandes conjuntos de datos de forma rápida y rentable. Una vez preparadas las características, aprovechamos AWS Batch para el entrenamiento de modelos de TensorFlow, lo que nos permite ejecutar hasta 10,000 trabajos de entrenamiento en paralelo para clientes individuales.
Al entrenar una red neuronal bayesiana, necesitamos muestrear los pesos basándonos en sus distribuciones estimadas. Sería prohibitivamente costoso si lo hiciéramos de forma ingenua para cada muestra. El truco Flipout [referencia 3] proporciona una implementación eficiente del muestreo de grupo equivalente, así que eso es lo que usamos en el entrenamiento.
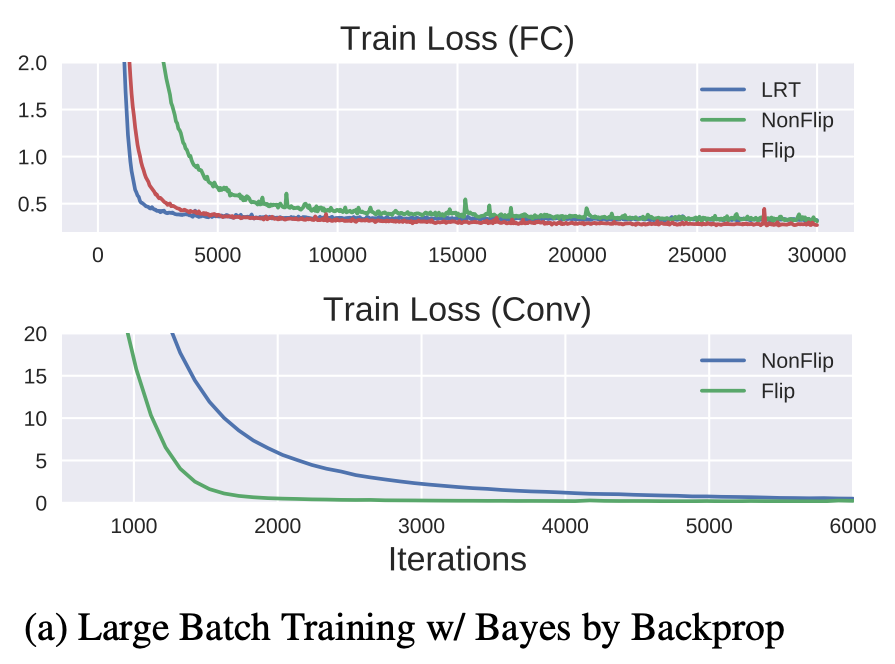
Cuando examinamos el uso de memoria durante el entrenamiento, descubrimos que aumentaba claramente a medida que avanzaban los lotes/iteraciones de entrenamiento. Eso indicaba una fuga de memoria. La causa raíz era un error en tf.py_function de TensorFlow, que no es un problema para tf.numpy_function [referencia 4]. Refactorizamos nuestro código para usar tf.numpy_function cuando fuera necesario.
En general, entrenar una red neuronal implica una gran cantidad de ajustes detallados, no solo para el rendimiento del modelo, sino también para la eficiencia del entrenamiento. No hay atajos; debes probar exhaustivamente.
Perspectivas de IA: Convirtiendo datos en conocimientos
Ejecutar pruebas es una cosa; interpretar los resultados es otra. Los resultados de los experimentos suelen incluir métricas complejas y una gran cantidad de información de diversas dimensiones, lo que dificulta la identificación de conclusiones claras y prácticas.
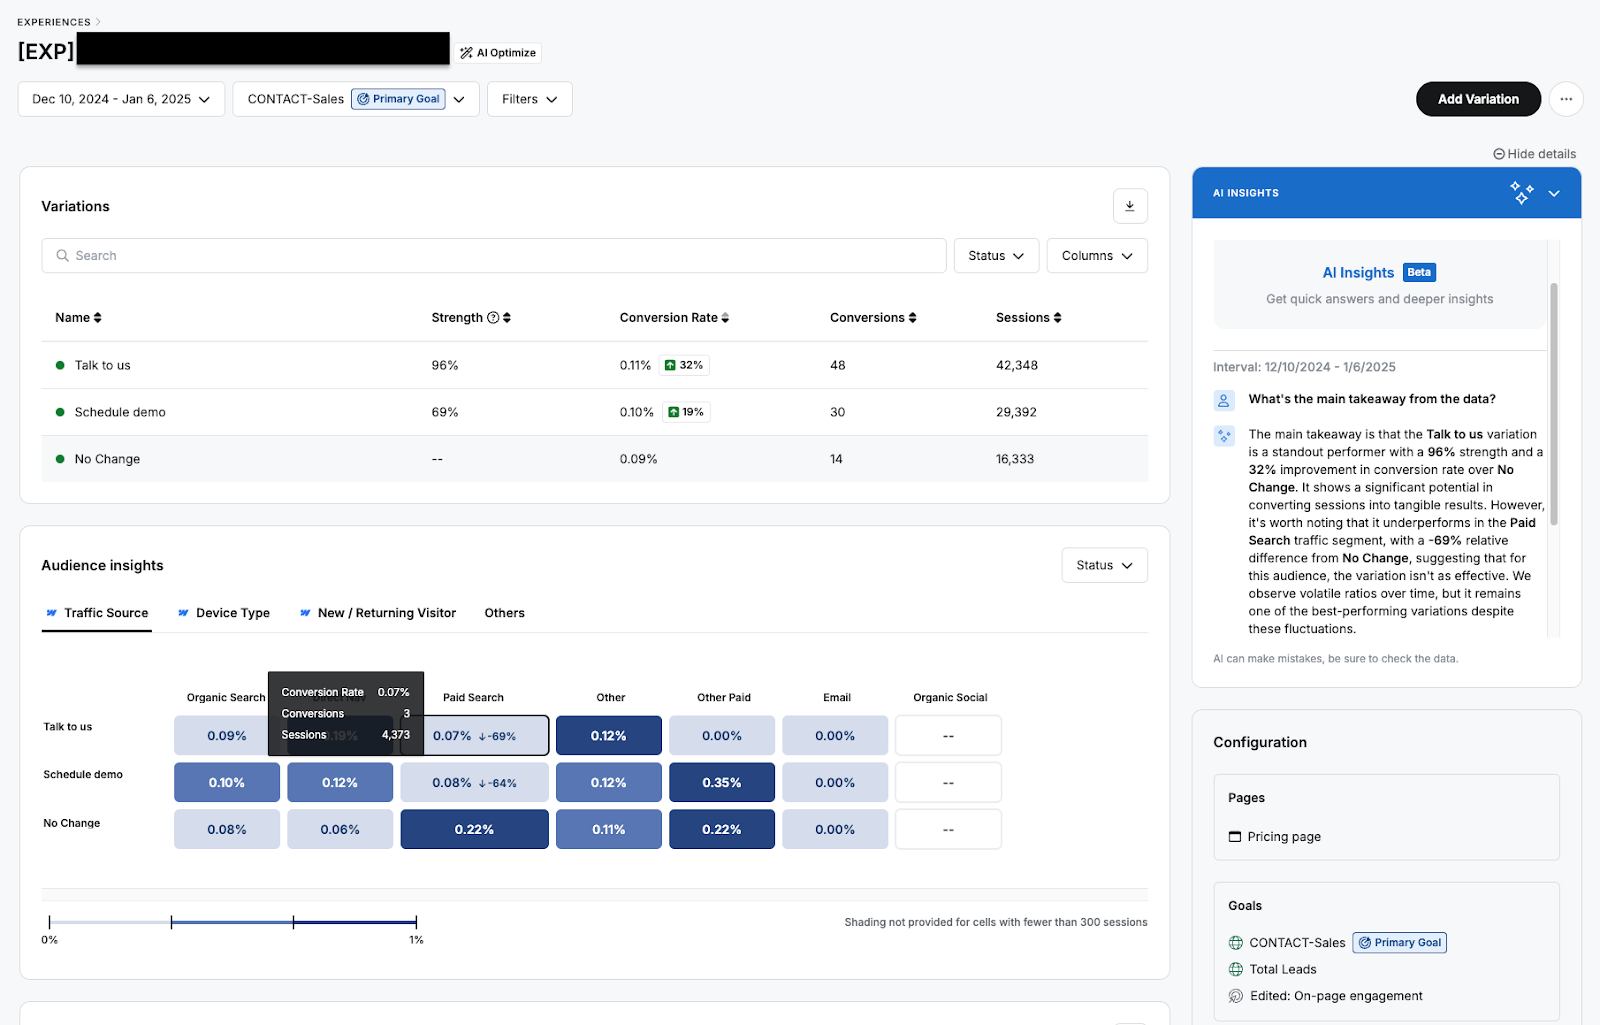
Para simplificar esto, creamos la función AI Insights, que utiliza LLM para analizar los resultados de las pruebas. Esta herramienta basada en LLM destaca patrones clave, responde preguntas y resume los resultados de los experimentos, ahorrando tiempo y esfuerzo a los equipos.
Uso de LLM
Desde una perspectiva de ingeniería, esta función planteó desafíos similares a los de las sugerencias de IA, aunque con detalles diferentes. Estos incluyeron:
- Gestión del contexto: los LLM necesitan una comprensión estructurada de los datos del experimento para proporcionar respuestas precisas.
- Optimización del rendimiento: leer y sintetizar grandes conjuntos de datos es un reto.
- Jerga profesional: los conocimientos deben expresarse en un lenguaje que los especialistas en marketing comprendan.
Para abordar estos problemas, adoptamos varias estrategias de ingeniería. Aprovechamos las API de asistente y de hilos para AI Insights, siguiendo un formato de chat con el historial de conversaciones mantenido en los hilos. Dado que la interfaz de usuario por sí sola no contiene toda la información de fondo necesaria, equipamos al asistente con "manuales" de producto colocándolos en su contexto del sistema, lo que permite respuestas más fundamentadas y relevantes.
En lugar de intentar cargar y resumir todos los datos a la vez (lo cual es inviable a gran escala), adoptamos un enfoque de varias etapas. Cuando comienza una sesión, el asistente precarga la información que se muestra en la vista predeterminada del panel. Para enriquecer la respuesta inicial, también precargamos varias estadísticas consultadas con frecuencia, incluso si están ocultas en la vista predeterminada.
A medida que continúa la conversación, el asistente puede obtener estadísticas adicionales de forma dinámica mediante llamadas a funciones. Estas estadísticas son las mismas que se muestran a través de nuestras API de servidor, pero exponemos una versión simplificada específicamente para el LLM. Este diseño ayuda a reducir el uso de tokens y facilita la interpretación de los datos por parte del modelo, dada su visibilidad limitada de nuestros sistemas internos.
Para completar la experiencia, le indicamos cuidadosamente al asistente que se comunique en un lenguaje que resuene con los especialistas en marketing, haciendo que los conocimientos técnicos sean más fáciles de entender y aplicar.
Evaluaciones
Una evaluación sólida es fundamental para cualquier aplicación de LLM, y hemos creado un sistema de varias capas para evaluar la calidad y guiar las mejoras.
Comenzamos con la precisión a nivel de herramienta, donde es sencillo determinar si el asistente activó las funciones correctas. Además, utilizamos un "juez LLM" personalizado (un asistente al que se le pide que actúe como un especialista en marketing experto) para proporcionar evaluaciones de calidad automatizadas de las respuestas generadas.
Finalmente, incorporamos la opinión humana. Los revisores internos de toda la empresa evalúan periódicamente los resultados, proporcionando puntuaciones y comentarios que ayudan a calibrar tanto al asistente como al juez automatizado. Tras el lanzamiento, seguimos mejorando a través de señales del mundo real: los comentarios de los clientes nos ayudan a evolucionar tanto el producto como los criterios de evaluación, incluida la forma en que se ajusta el propio juez LLM.
UI/UX
También queremos enfatizar la importancia crítica del diseño de UI/UX. Las técnicas de UX efectivas son fundamentales para abordar los desafíos comunes asociados con el uso de LLM, como los largos tiempos de respuesta para el análisis de datos, la calidad inconsistente del análisis y la participación limitada del usuario. El uso de diálogos conversacionales (en lugar de informes de resumen estáticos), combinado con preguntas iniciales y de seguimiento sugeridas, es particularmente impactante.
Este enfoque no solo mitiga los desafíos mencionados anteriormente, sino que también ofrece una experiencia de usuario interactiva y significativamente mejorada. Se siente como si el usuario estuviera consultando a un experto, guiándolo para refinar iterativamente sus preguntas y obtener conocimientos más profundos y precisos.
Ingeniería para la velocidad, la escalabilidad y la precisión
El núcleo de Webflow Optimize se centra deliberadamente en gestionar volúmenes masivos de datos en tiempo real sin sacrificar la calidad de los resultados. Lo logramos mediante IA generativa para inspirar nuevas ideas de pruebas, redes neuronales bayesianas para ajustar dinámicamente la distribución del tráfico y modelos de lenguaje (LLM) para convertir métricas brutas en recomendaciones claras. Juntas, estas tecnologías permiten a los especialistas en marketing optimizar sus sitios web de forma rápida y eficaz, soportando decenas de miles de pruebas en diversos patrones de tráfico.
Mirando hacia el futuro
Webflow Optimize no ha hecho más que empezar. A medida que la IA evoluciona, nuestro objetivo es seguir creando herramientas que permitan a los equipos optimizar sus sitios web sin esfuerzo, haciendo que cada interacción cuente. Detrás de cada herramienta impulsada por IA hay retos de ingeniería: equilibrar velocidad y escalabilidad, inspiración y precisión, creatividad y estructura. En Webflow Optimize, hemos combinado modelos propietarios y LLM para ofrecer una solución sólida. Seguiremos entrenando nuestros propios modelos y aprovechando lo último en modelos multimodales y marcos de agentes.
Referencias

¡Estamos contratando!
Buscamos talento en producto e ingeniería para que se una a nuestra misión de poner superpoderes de desarrollo al alcance de todos.