

Aprende cómo funcionan las solicitudes HTTP para crear mejores aplicaciones web. Esta guía cubre la estructura de las solicitudes, los métodos y los códigos de estado con ejemplos para la depuración y optimización.
Cada vez que se carga una página, se envía un formulario o se realiza una llamada a una API, tu navegador emite un paquete de texto plano que atraviesa redes, llega a un servidor y espera una respuesta estructurada llamada solicitud HTTP.
Entender qué hay dentro de esa solicitud y cómo se mueve a través del Sistema de Nombres de Dominio (DNS), el Protocolo de Control de Transmisión (TCP) y la Seguridad de la Capa de Transporte (TLS) te permite detectar puntos finales lentos, diseñar APIs predecibles y mantener páginas rápidas.
Sigue leyendo para aprender sobre las líneas de solicitud, los encabezados y las estructuras de cuerpo, junto con los métodos HTTP, los códigos de estado y los flujos de trabajo de depuración. Todos estos detalles a nivel de implementación te ayudarán a crear mejores APIs, depurar problemas de red y optimizar tus aplicaciones web.
¿Qué es una solicitud HTTP?
Una solicitud HTTP es un mensaje estructurado enviado a un servidor para pedir recursos o acciones. Cuando escribes una URL, envías un formulario o llamas a una API, tu cliente ensambla esta solicitud. HTTP opera en la capa de aplicación de TCP/IP, utilizando TCP (o QUIC para HTTP/3) como transporte.
Estas solicitudes impulsan todas las interacciones web. Los navegadores envían solicitudes GET para cargar recursos HTML, CSS y JavaScript. Las aplicaciones React realizan llamadas POST o PATCH a puntos finales de API REST o GraphQL. Los procesos de pago transmiten detalles confidenciales a través de canales HTTPS cifrados. Funciones como el desplazamiento infinito y la búsqueda en vivo dependen de solicitudes HTTP frecuentes para obtener contenido adicional.
La fuerza de HTTP proviene de su diseño minimalista que sigue siendo simple, extensible y sin estado. Puedes añadir encabezados, autenticación o directivas de caché sin modificar las reglas fundamentales del protocolo. Debido a que cada solicitud contiene toda la información necesaria para su procesamiento, HTTP permite el escalado horizontal, ya que los servidores no necesitan mantener la memoria de sesión entre solicitudes.
El uso eficaz de HTTP requiere comprender la semántica de los encabezados, la idempotencia de los métodos y las directivas de caché. Aunque HTTP/1.1 sigue siendo común, HTTP/2 mejora el rendimiento mediante conexiones multiplexadas y HTTP/3 reduce la latencia al reemplazar TCP con QUIC.
Independientemente de la versión, la estructura fundamental del mensaje de solicitud constituye la base de todas las implementaciones HTTP.
Anatomía de una solicitud HTTP
Todas las solicitudes HTTP contienen una línea de solicitud, encabezados y un cuerpo opcional. Aprender esta estructura a fondo te ayudará a solucionar problemas de red de manera más efectiva de lo que cualquier consola de navegador puede mostrar.
La línea de solicitud va primero y contiene el método (GET, POST, etc.), la ruta del recurso y la versión del protocolo, separados por espacios, así: GET /index.html HTTP/1.1. Esta línea termina con CRLF (\r\n), que es la secuencia de retorno de carro y salto de línea que requiere el formato de mensaje HTTP.
Los encabezados siguen como pares clave-valor que transportan metadatos de la solicitud. Una línea en blanco (otro CRLF) marca dónde terminan los encabezados. Trabajarás constantemente con estos encabezados:
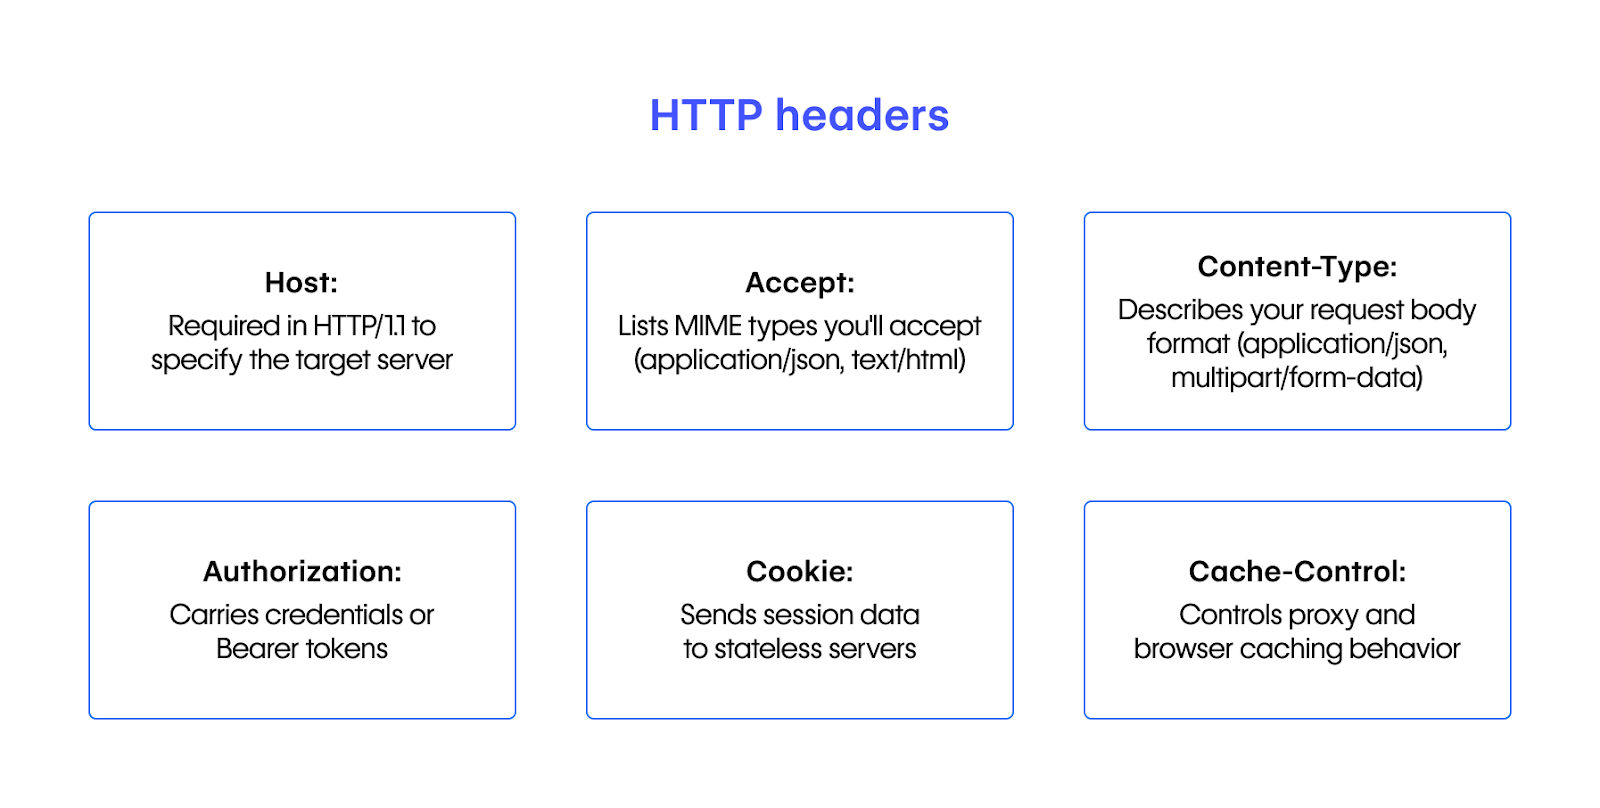
Host: Requerido en HTTP/1.1 para especificar el servidor de destinoAccept: Enumera los tipos MIME que aceptarás (p. ej.,application/json, text/html)Content-Type: Describe el formato del cuerpo de tu solicitud (p. ej.,application/json,multipart/form-data)Authorization: Transporta credenciales, generalmente como tokens Bearer o autenticación básica, aunque existen otros esquemas.Cookie: Envía identificadores (como IDs de sesión o tokens) para que los servidores sin estado puedan mantener el contexto entre solicitudes.Cache-Control: Controla el comportamiento de caché del proxy y del navegador
El cuerpo del mensaje aparece al final, después de la línea en blanco. Los métodos que modifican el estado del servidor, como POST, PUT y PATCH, suelen incluir un cuerpo con JSON, datos de formulario o archivos. Los métodos seguros como GET no incluyen un cuerpo. Aunque las solicitudes DELETE técnicamente pueden incluir uno, la mayoría de los servidores lo ignoran.
Aquí tienes una solicitud completa que muestra las tres partes:
POST /api/items HTTP/1.1
Host: example.com
Accept: application/json
Content-Type: application/json
Authorization: Bearer <token>
Content-Length: 48

{
  "name": "Keyboard",
  "price": 49.99
}
Puedes visualizar las solicitudes HTTP con tres capas distintas. La línea de solicitud dirige el tráfico a tu recurso específico. Los encabezados proporcionan el contexto de procesamiento necesario. El cuerpo contiene tus datos de carga útil reales. Este marco mental sencillo simplifica tanto la depuración de bajo nivel como el diseño de APIs.
Cómo viajan las solicitudes HTTP
Cuando escribes una URL y presionas Enter, tu solicitud HTTP viaja a través de varias capas de red antes de llegar a su destino. Este viaje implica que un cliente envía una solicitud y espera una respuesta que contiene el estado de la operación y el contenido solicitado.
Aquí tienes una representación visual de cómo viaja una solicitud HTTP:
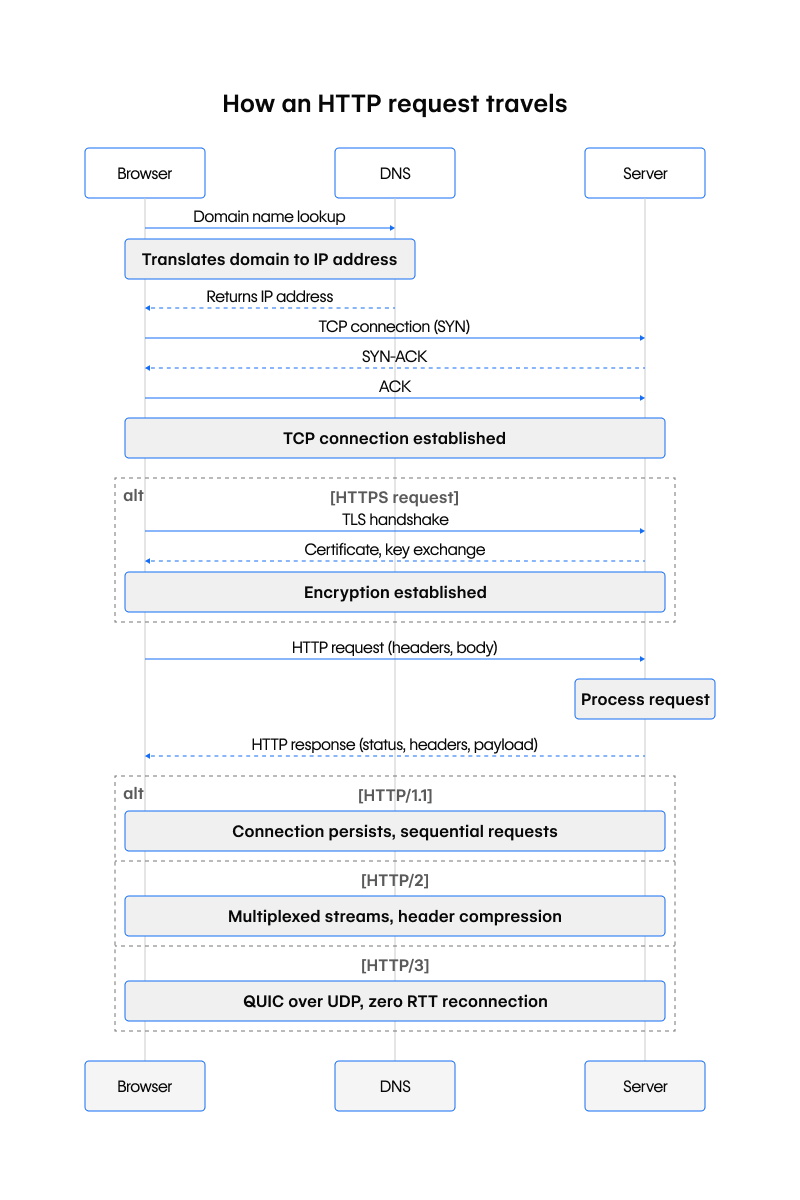
Primero, tu navegador necesita una dirección IP. Una búsqueda DNS solicita a los servidores de nombres recursivos y autoritativos que traduzcan el dominio a una dirección que la red entienda. Si no hay nada almacenado en caché localmente, estos viajes de ida y vuelta añaden los primeros milisegundos de latencia.
Con la IP en mano, el navegador abre una conexión TCP. El conocido saludo de tres vías (SYN, SYN-ACK y ACK) establece un canal de transporte confiable. Cuando el esquema es https, le sigue inmediatamente un saludo TLS. Durante este proceso, el cliente y el servidor negocian cifrados, verifican certificados y derivan claves para cifrar cada byte transmitido posteriormente.
Solo ahora tu navegador transmite el mensaje HTTP real. Los encabezados, incluidos Host, User-Agent y Accept, viajan junto a la línea de solicitud y un cuerpo, si existe. En el servidor, una aplicación web podría consultar una base de datos o llamar a servicios secundarios antes de elaborar una respuesta HTTP con un código de estado, encabezados y carga útil.
HTTP no tiene estado. Cada solicitud es independiente, pero a menudo llevas contexto a través de cookies o tokens Bearer, lo que hace que el flujo de trabajo sea "sin estado, pero no sin sesión".
Después de que llega la respuesta, la conexión subyacente puede persistir. HTTP/1.1 hizo que las conexiones persistentes fueran el estándar, por lo que múltiples solicitudes podían reutilizar una sola conexión (señalado anteriormente con Connection: keep-alive en HTTP/1.0). Sin embargo, cada solicitud sigue esperando su turno. HTTP/2 cambia esto al multiplexar múltiples flujos concurrentes sobre una conexión y comprimir los marcos de encabezado, reduciendo tanto la latencia como el consumo de ancho de banda.
La evolución más reciente, HTTP/3, se ejecuta sobre QUIC en UDP en lugar de TCP. QUIC combina los saludos de transporte y seguridad, permitiendo reconexiones de cero tiempo de ida y vuelta y eliminando el bloqueo de cabeza de línea, por lo que las solicitudes siguen fluyendo incluso cuando se pierden paquetes.
Entender esta línea de tiempo te ayuda a identificar dónde ocurren las ralentizaciones: configuración incorrecta de DNS, negociación TLS larga, lógica de aplicación demasiado comunicativa o la falta de multiplexación HTTP/2. Al asignar los problemas de rendimiento a fases específicas, puedes realizar correcciones dirigidas en lugar de adivinar.
9 métodos de solicitud HTTP y cuál elegir
Cada solicitud que envías lleva un método o verbo HTTP que le indica al servidor qué pretendes hacer con un recurso. Elegir el método correcto aclara las expectativas sobre seguridad, idempotencia, almacenamiento en caché e incluso protección.
La especificación HTTP/1.1 define ocho métodos principales que cumplen propósitos distintos. Estos incluyen GET, HEAD, POST, PUT, DELETE, OPTIONS, TRACE y CONNECT. PATCH se añadió más tarde como un método de extensión.
Las propiedades marcadas como "seguras" o "idempotentes" siguen la semántica HTTP. Los métodos seguros no deben mutar el estado del servidor, mientras que los idempotentes pueden repetirse con el mismo resultado, lo cual puede ser crítico al implementar reintentos.
Cuándo elegir un método sobre otro
A menudo tendrás que decidir entre pares de verbos que parecen similares a primera vista. Aquí te explicamos cómo elegir el método correcto para tu caso de uso específico:
GETvs.HEAD:GETrecupera el recurso completo, mientras queHEADobtiene solo los encabezados. UsaGETcuando necesites el contenido real. EligeHEADcuando necesites metadatos comoContent-Lengthantes de decidir si descargar archivos grandes.POSTvs.PUT:POSTcrea recursos cuando el servidor determina el identificador, mientras quePUTcrea o reemplaza en una URI específica que tú controlas. UsaPOSTal crear elementos en una colección sin conocer el ID final (como un nuevo pedido). EligePUTcuando sepas exactamente dónde pertenece el recurso y quieras asegurar la idempotencia, de modo que repetir el mismoPUTno cree duplicados.PATCHvs.PUT:PUTreemplaza un recurso completo, mientras quePATCHactualiza solo campos específicos. UsaPUTal sobrescribir un recurso completo. EligePATCHpara actualizaciones parciales (como cambiar solo el campo destockde un producto) para evitar sobrescribir accidentalmente datos sin cambios. Ten en cuenta que no se garantiza quePATCHsea idempotente. Si las solicitudesPATCHrepetidas producen el mismo resultado depende de cómo el servidor implemente la operación.
Entender estas distinciones te ayuda a diseñar APIs más predecibles y fáciles de mantener que siguen las convenciones estándar de HTTP.
5 tipos de códigos de estado HTTP
Las respuestas del servidor incluyen un código de estado de tres dígitos que resume el resultado. Este código te indica inmediatamente si debes renderizar contenido, redirigir, mostrar errores o reintentar sin tener que analizar todo el cuerpo de la respuesta.
Los códigos de estado HTTP se dividen en cinco clases según su primer dígito:

- 1xx Informativo (100–199) indica que el servidor recibió tu solicitud y aún la está procesando. Estos aparecen principalmente durante subidas complejas, como transferencias de archivos grandes.
- 2xx Éxito (200–299) significa que la operación se realizó correctamente. Ejemplos comunes incluyen
200 OKpara solicitudesGETy201 Createdtras la creación exitosa de un recurso. - 3xx Redirección (300–399) requiere otra solicitud para completar el flujo de trabajo. Ejemplos incluyen
301 Moved Permanently,302 Foundy304 Not Modified, lo cual afecta al almacenamiento en caché y al SEO. - 4xx Error del cliente (400–499) indica problemas del lado del cliente. Ejemplos incluyen
400 Bad Requestpara cargas útiles mal formadas,401 Unauthorizedpor falta de credenciales,403 Forbiddenpor problemas de permisos,404 Not Foundpara recursos inexistentes y429 Too Many Requestspor limitación de tasa. - 5xx Error del servidor (500–599) significa que tu solicitud era válida, pero el procesamiento del servidor falló. Los códigos comunes incluyen
500 Internal Server Error,502 Bad Gatewayy503 Service Unavailable.
Gestiona esto de forma coherente para lograr aplicaciones resistentes.
- Trata los 2xx como éxito, actualiza el enrutamiento para los 3xx y supervisa los 4xx y 5xx en los paneles de control.
- Implementa lógica de reintento para
502/503, reduce la frecuencia en429y detente inmediatamente ante un400. - Utiliza disyuntores (circuit breakers) que se abran tras respuestas 5xx consecutivas y vuelve a probar gradualmente.
Esto convierte el tráfico de red en un comportamiento predecible y tolerante a fallos.
Cómo supervisar y depurar solicitudes HTTP
Descubre cuellos de botella en el rendimiento observando el tráfico HTTP real. Utiliza estas herramientas prácticas:
- Herramientas para desarrolladores del navegador: El panel de red muestra cascadas de solicitudes con fases de DNS, TCP y TLS. Filtra llamadas XHR y exporta archivos HAR para compartirlos.
- Herramientas de línea de comandos:
curl -vmuestra solicitudes y respuestas sin procesar.httpieofrece una salida formateada.tcpdumpyngrepcapturan datos de paquetes. - Clientes de API: Postman e Insomnia permiten realizar pruebas repetibles con colecciones y entornos. GoReplay captura tráfico para pruebas de regresión.
- Supervisión de producción: OpenTelemetry con Datadog o Jaeger visualiza la latencia y las tasas de error. Registra las marcas de tiempo de las solicitudes para seguir las tendencias de rendimiento.
Webflow Cloud proporciona estas métricas automáticamente con recuentos de solicitudes, latencia y códigos de estado.
Para mediciones precisas, utiliza el cronometraje de cURL:
curl -o /dev/null -s -w "@curl-format.txt" \
  -H "Accept: application/json" \
  https://api.example.com/v1/users/42
Un archivo de formato personalizado rastrea los valores de time_namelookup, time_connect y time_starttransfer para identificar retrasos en el DNS, la conexión o el procesamiento.
Uso de solicitudes HTTP para crear mejores API
Toda interacción HTTP sigue la misma estructura sencilla: una línea de solicitud que indica el método, la ruta y la versión del protocolo; encabezados que transportan contexto; y un cuerpo opcional con datos. Cuando entiendes cómo funcionan juntas estas tres piezas, puedes leer cualquier solicitud sin procesar y ver inmediatamente qué quiere el cliente, qué metadatos lo acompañan y si hay una carga útil.
Este conocimiento vale la pena en tu trabajo diario. Detectarás errores más rápido en el panel de red del navegador, escribirás comandos curl precisos durante el desarrollo de la API y detectarás cuellos de botella en el rendimiento, como viajes de ida y vuelta innecesarios o cargas útiles demasiado grandes. La semántica central (métodos, códigos de estado y el ciclo de solicitud/respuesta sin estado) se mantiene constante desde HTTP/1.1 hasta HTTP/3, por lo que estas habilidades te serán muy útiles a medida que evolucionen las capas de transporte.
La próxima vez que depures un problema complejo de API, inspecciona la solicitud sin procesar, ajusta un encabezado, mide los cambios y aplica lo aprendido en tu siguiente proyecto.
Preguntas frecuentes sobre solicitudes HTTP
¿Cuál es la diferencia entre HTTP y HTTPS?
HTTP envía datos como texto sin formato, mientras que HTTPS cifra los datos de la aplicación enviados a través de TCP usando TLS, protegiéndolos durante el tránsito. El protocolo de enlace TLS cifra los datos en tránsito y autentica al servidor con un certificado, evitando el espionaje que HTTP en texto plano
¿Cómo se relacionan las cookies con las solicitudes HTTP?
HTTP no tiene estado, por lo que las cookies en el encabezado Cookie transportan identificadores de sesión o tokens entre solicitudes. Los servidores devuelven Set-Cookie en las respuestas para mantener el contexto del usuario sin incrustar el estado en el protocolo mismo.
¿Cuáles son los límites de tamaño para las solicitudes HTTP?
La especificación HTTP no establece un límite estricto, pero los navegadores, proxies y servidores imponen restricciones prácticas: las cabeceras suelen limitarse a 8-16 KB y los cuerpos a decenas de megabytes. Revisa la configuración de tu servidor web, por ejemplo client_max_body_size de Nginx, antes de dar por hecho que las cargas útiles grandes llegarán intactas.
¿Cómo soluciono los errores de CORS en las peticiones HTTP?
Los navegadores bloquean las peticiones de origen cruzado a menos que el servidor responda con Access-Control-Allow-Origin (y a veces Allow-Credentials). Usa las herramientas de desarrollo para inspeccionar la petición OPTIONS de precomprobación automática y ajusta las cabeceras del servidor para permitir explícitamente tu origen, métodos y cabeceras. La guía HTTP de MDN cubre todas las cabeceras involucradas.
¿Cuál es la diferencia entre los parámetros de consulta y los datos de formulario?
Los parámetros de consulta residen en la URL (/products?sort=asc&page=2) y son ideales para peticiones GET o HEAD idempotentes. Los datos de formulario viajan en el cuerpo del mensaje, a menudo como application/x-www-form-urlencoded o multipart/form-data, y funcionan para POST, PUT o PATCH al enviar entradas de usuario o archivos.
¿Cómo cambian HTTP/2 y HTTP/3 el manejo de las peticiones?
HTTP/2 multiplexa múltiples flujos sobre una sola conexión TCP, eliminando el bloqueo de cabeza de línea de "una petición a la vez" de HTTP/1.1. HTTP/3 reemplaza TCP con QUIC sobre UDP, combinando la multiplexación con saludos más rápidos y resistentes a la pérdida de paquetes. Ambos reducen la latencia sin cambiar el formato de la petición.
¿Puedo cancelar una petición HTTP después de enviarla?
Puedes cerrar el socket subyacente o, en navegadores modernos, abortar un fetch con AbortController. Es posible que el servidor termine de procesar, pero tu hilo de aplicación recupera el control y puede ignorar la respuesta final.
¿Cómo manejo la autenticación en las peticiones HTTP?
Adjunta las credenciales en la cabecera Authorization, como Bearer <token> para JWT, Basic <base64> para usuario/contraseña simple, o confía en las cookies de sesión establecidas tras el inicio de sesión. Usa siempre HTTPS para que los tokens y contraseñas viajen cifrados.

Crea sitios web que dan resultados.
Diseña visualmente, publica al instante y escala de forma segura y rápida. Todo con la plataforma de marketing web con IA de Webflow.