

Probablemente conozcas los reCAPTCHA como los porteros de internet: esas pequeñas pruebas en forma de casillas de verificación, palabras o fotos que van desde lo ligeramente molesto hasta lo cómicamente frustrante.
Pero, ¿qué es exactamente un reCAPTCHA? Es un servicio de Google diseñado para ayudar a proteger los sitios web contra el spam y los abusos.
La prueba CAPTCHA original, diseñada por un equipo de la Universidad Carnegie Mellon, pedía a los usuarios que descifraran números o letras. CAPTCHA es el acrónimo de "Completely Automated Public Turing test to tell Computers and Humans Apart" (Prueba de Turing pública y automática para distinguir a los ordenadores de los humanos). Google rediseñó la prueba CAPTCHA, mejorando su capacidad para bloquear bots avanzados y software malicioso, y ese nuevo servicio se llama reCAPTCHA.
El reCAPTCHA básico de Google es un servicio gratuito, pero reCAPTCHA Enterprise te permite extender la funcionalidad de análisis de riesgos avanzado a sitios web completos en lugar de limitarte a ciertas páginas.
Todas estas pruebas están pensadas para ser fáciles para los humanos y difíciles para los bots, de modo que solo las personas reales puedan acceder a un sitio web. Al principio, ese era su único propósito: limitar el spam y la actividad de los bots en las páginas web. Pero los reCAPTCHA también han llegado a desempeñar papeles importantes tanto en la preservación de libros como en la cultura de los memes.
Los reCAPTCHA ayudaron a digitalizar millones de palabras
El informático guatemalteco Luis von Ahn lideró el equipo detrás del proyecto CAPTCHA en la Universidad Carnegie Mellon. Aunque el objetivo original del proyecto era evitar que los servicios automatizados abusaran de la web, el equipo se dio cuenta de que existía el potencial de canalizar el esfuerzo humano para apoyar simultáneamente otro objetivo: digitalizar materiales impresos antiguos.
Los materiales impresos con tinta descolorida o páginas amarillentas, junto con los textos escritos a mano, son difíciles de escanear; los programas de reconocimiento óptico de caracteres (OCR) solo reconocen alrededor del 20% de las palabras.
Luis y su equipo calcularon que los humanos pasaban cientos de miles de horas al día resolviendo desafíos de reCAPTCHA. En lugar de desperdiciar ese trabajo, el equipo introdujo palabras de textos escaneados en los reCAPTCHA, pidiendo esencialmente a la gente que transcribiera los textos palabra por palabra.
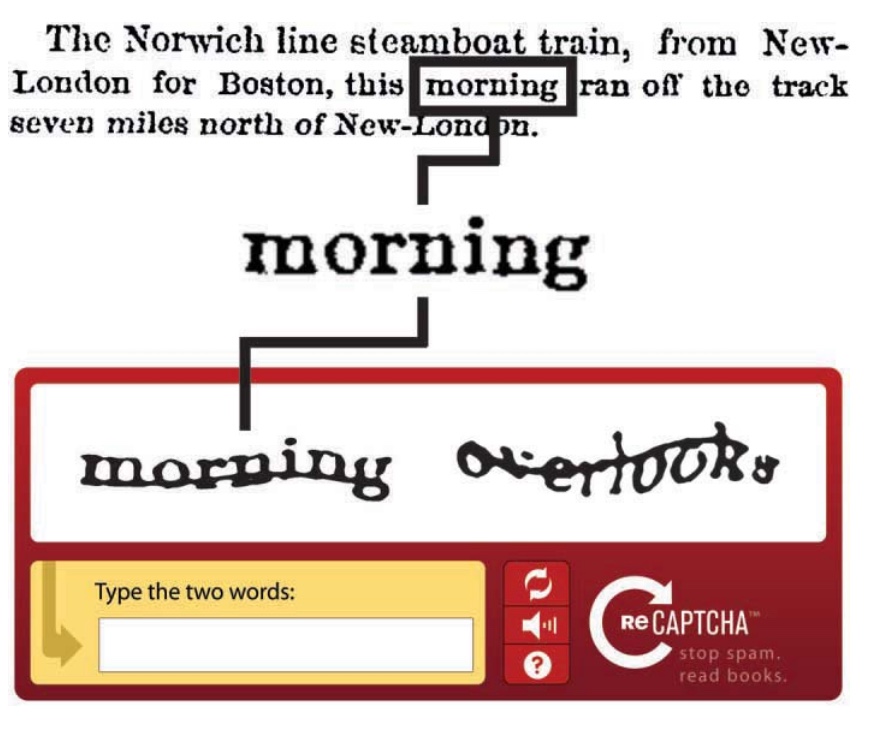
Los archivos del New York Times (NYT) eran ideales para las pruebas porque los artículos se remontaban a mediados del siglo XIX, lo que permitió al equipo probar artículos escaneados de cinco años diferentes (1860, 1865, 1908, 1935 y 1970). Las palabras irreconocibles se enviaban a varios usuarios para verificar la transcripción, lo que resultó en una tasa de precisión del 99,1%.
Tras el exitoso experimento, todos los archivos del NYT se introdujeron en el servicio reCAPTCHA. En un año, los usuarios de internet habían transcrito más de 440 millones de palabras, el equivalente a 17.600 libros.
Para 2011, las personas que resolvían reCAPTCHA habían ayudado sin saberlo a completar la digitalización de todos los archivos del NYT. En ese momento, Google redirigió el proyecto para apoyar su enorme esfuerzo por digitalizar prácticamente todos los libros existentes. Aunque se desconoce el número oficial de libros digitalizados mediante la verificación reCAPTCHA, este esfuerzo, combinado con procesos manuales y asistidos por inteligencia artificial, suma millones de libros digitalizados, 25 millones de los cuales Google no tiene permiso para compartir, pero esa es otra historia.
Pero no todos los esfuerzos de reCAPTCHA preservan artículos y libros históricos
Aunque usar reCAPTCHA para digitalizar materiales impresos antiguos es increíblemente genial por razones históricas, no todo el mundo está entusiasmado con el alcance del proyecto. Una cosa es ayudar a digitalizar artículos del NYT del siglo XIX, pero transcribir libros para Google y alimentar sus datos de interacción y comportamiento del usuario es otra historia.
Google ha sido criticado e incluso demandado por utilizar reCAPTCHA para facilitar mano de obra de transcripción no remunerada de la que Google finalmente se benefició. Mientras los usuarios de internet seguían transcribiendo libros, documentos y artículos de diversas universidades y gobiernos de forma gratuita, Google cobraba por el servicio.
Las cosas se pusieron aún más turbias cuando los reCAPTCHA fotográficos llegaron a internet en 2012. Las imágenes y los números extraídos de Google Street View aparecen en los reCAPTCHA, pidiendo a los usuarios que verifiquen los nombres de las calles o las direcciones, lo que proporciona a Google datos de reconocimiento de imágenes necesarios para mejorar Google Maps.
Hoy en día, es posible que no veas muchas solicitudes de direcciones, pero no es porque Google haya terminado de recopilar datos. Ahora, Google realiza un análisis del comportamiento de las interacciones del navegador para intentar adivinar si los usuarios son humanos. Si las acciones parecen humanas, Google muestra el no CAPTCHA reCAPTCHA, que es una sencilla casilla de verificación que te pide confirmar que no eres un robot. Los desarrolladores web también pueden usar reCAPTCHA invisibles, que omiten la casilla de verificación y verifican al usuario cuando hace clic en un botón existente o mediante una llamada a la API de JavaScript.
Si uno de esos métodos no te considera humano, probablemente recibirás la versión de reCAPTCHA de "selecciona todos los cuadrados que contengan". Estas pruebas te piden que mires una foto dividida en una cuadrícula y selecciones solo los cuadrados que contienen un objeto determinado, como un semáforo o un coche.
Puede que no nos encante todo de los reCAPTCHA, pero diría que el cambio de Google hacia más cuadrículas de fotos tiene una gran ventaja: el nacimiento de varios formatos de memes nuevos.
Los reCAPTCHA se ganaron su lugar en la historia de los memes
Si le das a la gente de internet fotos o palabras fuera de contexto, los memes son prácticamente inevitables. Las combinaciones de palabras extrañas, las fotos callejeras sombrías tomadas en ángulos incómodos y los frustrantes errores de autenticación se convirtieron rápidamente en chistes de internet.
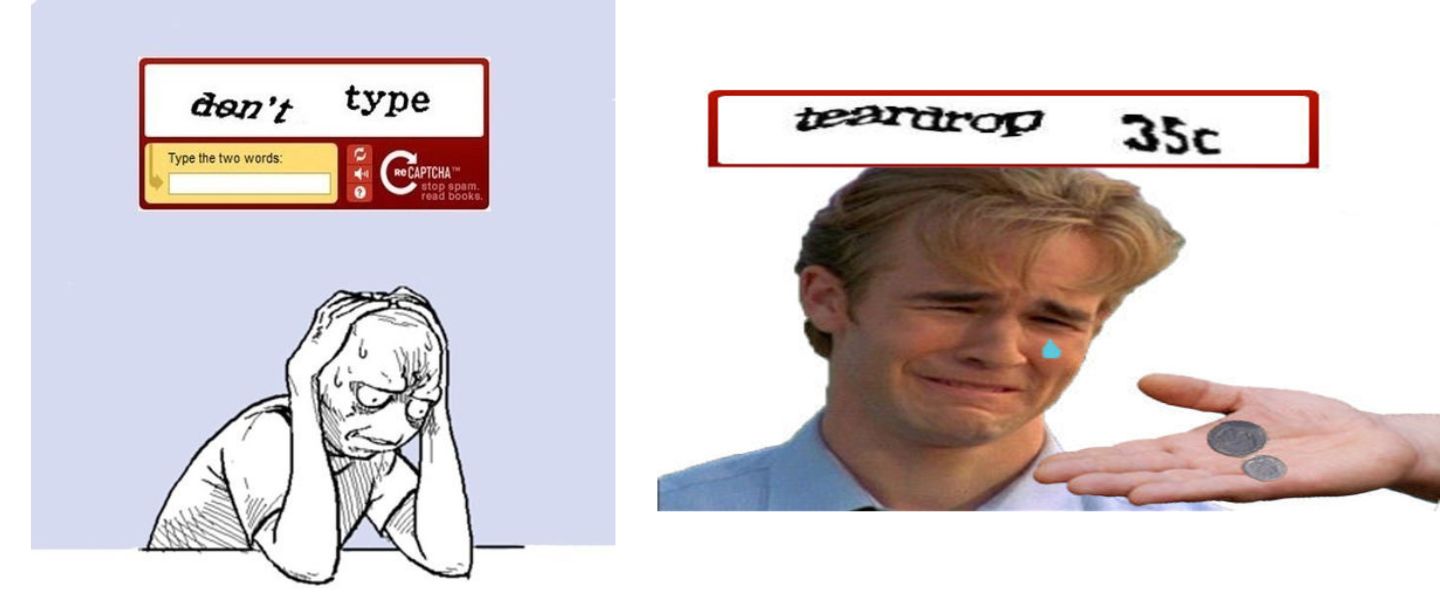
El CAPTCHA original obtuvo estatus de meme confirmado en el año 2000. Por aquel entonces, la mayoría de los memes relacionados eran CAPTCHArt, un formato que consistía en “dibujar cómics o editar imágenes inspiradas en un par de palabras generado aleatoriamente por un CAPTCHA”.
Por ejemplo, un dibujo de alguien sufriendo tras tener que escribir la combinación de palabras “no escribas” o el meme de Dawson llorando combinado con la combinación “lágrima 35c”.
Los CAPTCHA de texto también alimentaron los memes de Inglip, pero este estilo se adentra en las profundidades de la cultura de internet. Inglip es “un folclore de internet basado en el personaje de rage comic homónimo que puede comunicarse con acólitos míticos conocidos como Gropagas a través de imágenes de CAPTCHA”.
Básicamente, un tipo garabateado de internet cree que los CAPTCHA son mensajes de un ser mítico.
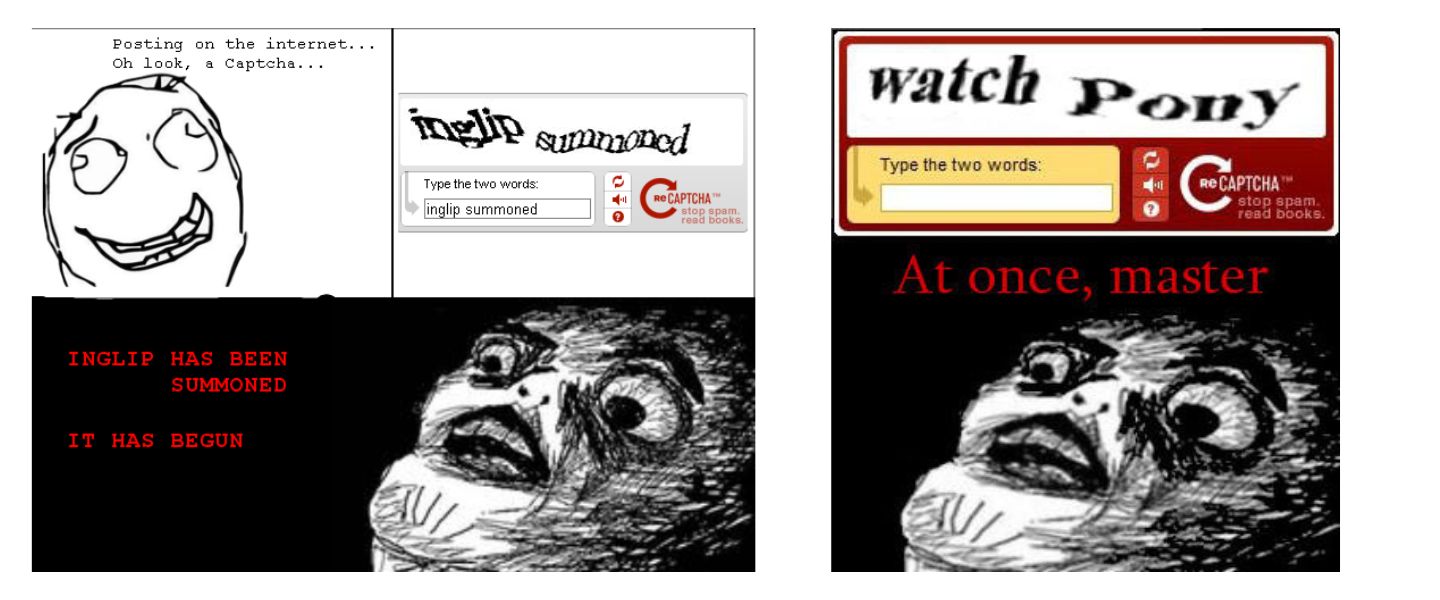
No profundizaré aquí en las complejidades de Inglip, pero si quieres hacerlo, hay mucha información disponible.
Personalmente, creo que el formato de “selecciona todos los cuadrados” es la verdadera estrella del juego de memes de CAPTCHA. Técnicamente, sigue siendo un meme no confirmado, pero tengo fe. Este estilo de meme tiene algunas variantes: elecciones estresantes, respuestas a peticiones sin sentido y cuadrículas de fotos inventadas.
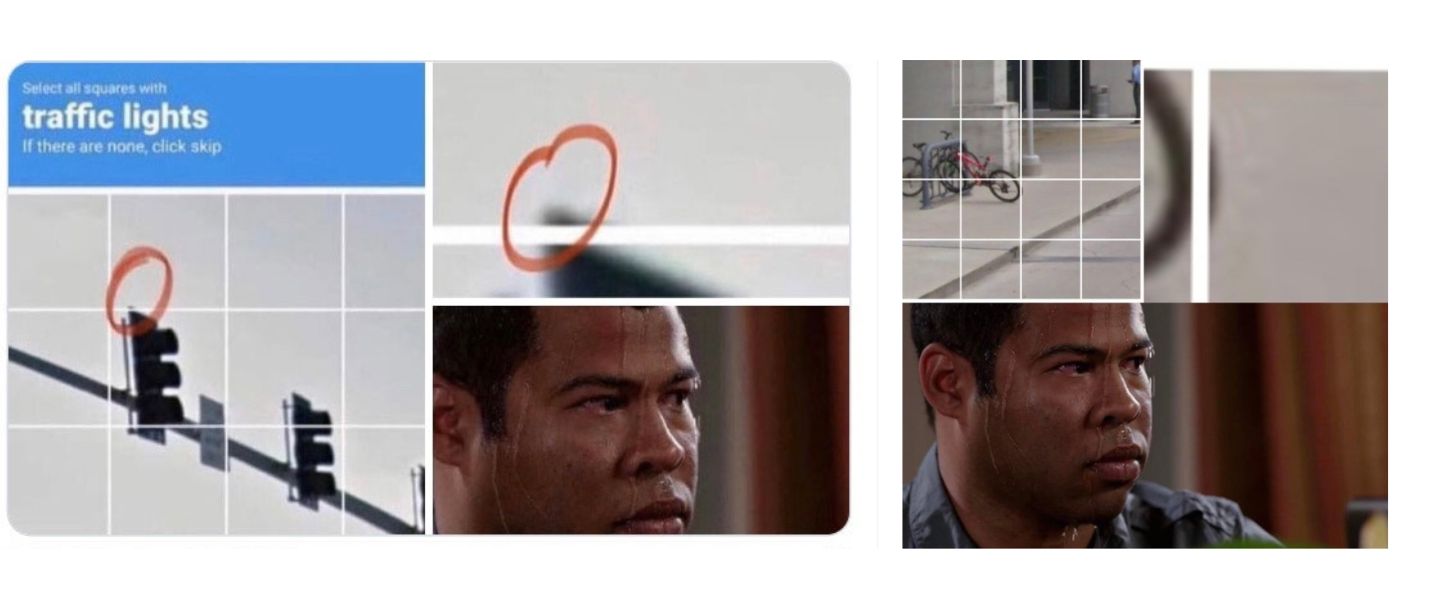
Mi favorito personal es el tipo que suda de estrés. El meme de Jordan Peele sudando se combina con una cuadrícula de fotos que muestra el objeto solicitado (semáforo, bicicleta, etc.) invadiendo ligeramente otro cuadrado, lo que te hace cuestionar si realmente cuenta como que “contiene” el objeto.
Por ejemplo, una petición de semáforos donde la punta más pequeña de una luz cruza hacia un cuadrado que, por lo demás, está vacío. O una petición de cuadrados que contengan una bicicleta con el borde de un neumático apenas cruzando hacia otro cuadrado.
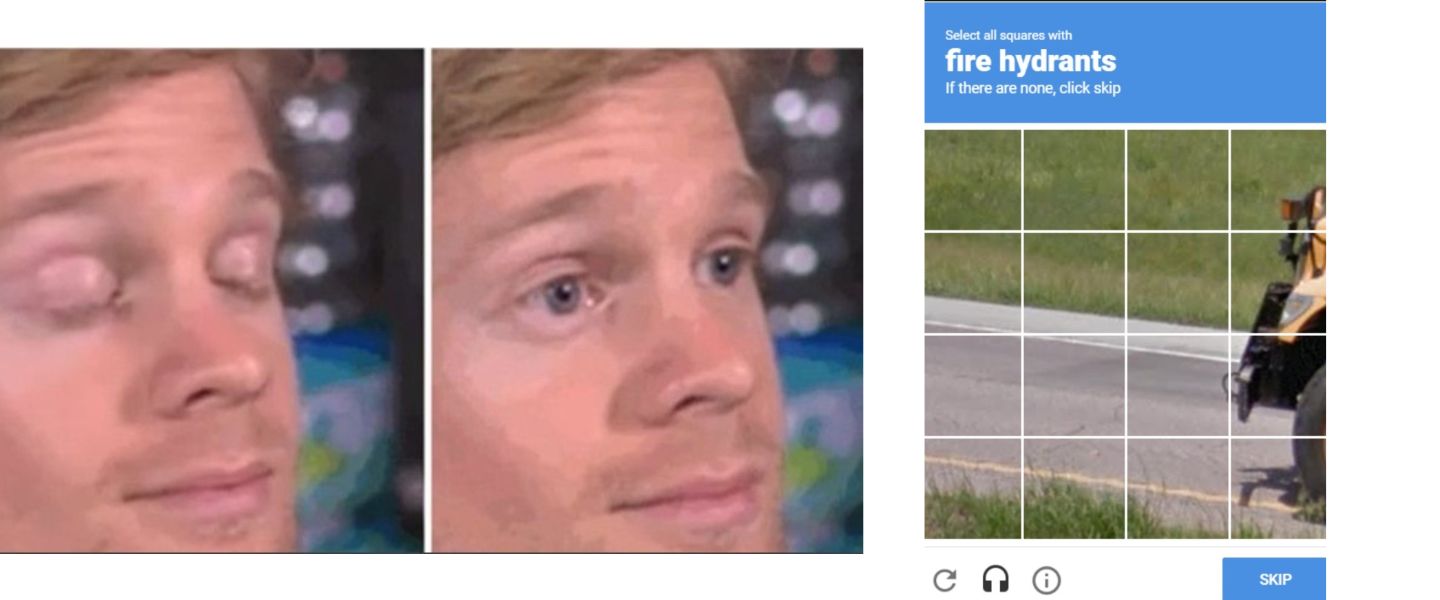
Otro formato de meme de reCAPTCHA destaca que las computadoras no siempre son perfectas. Las respuestas a peticiones imposibles o difíciles de resolver dan lugar a memes como el de abajo, donde el meme del tipo blanco parpadeando reacciona a una petición de bocas de incendio en una foto que no contiene ninguna.
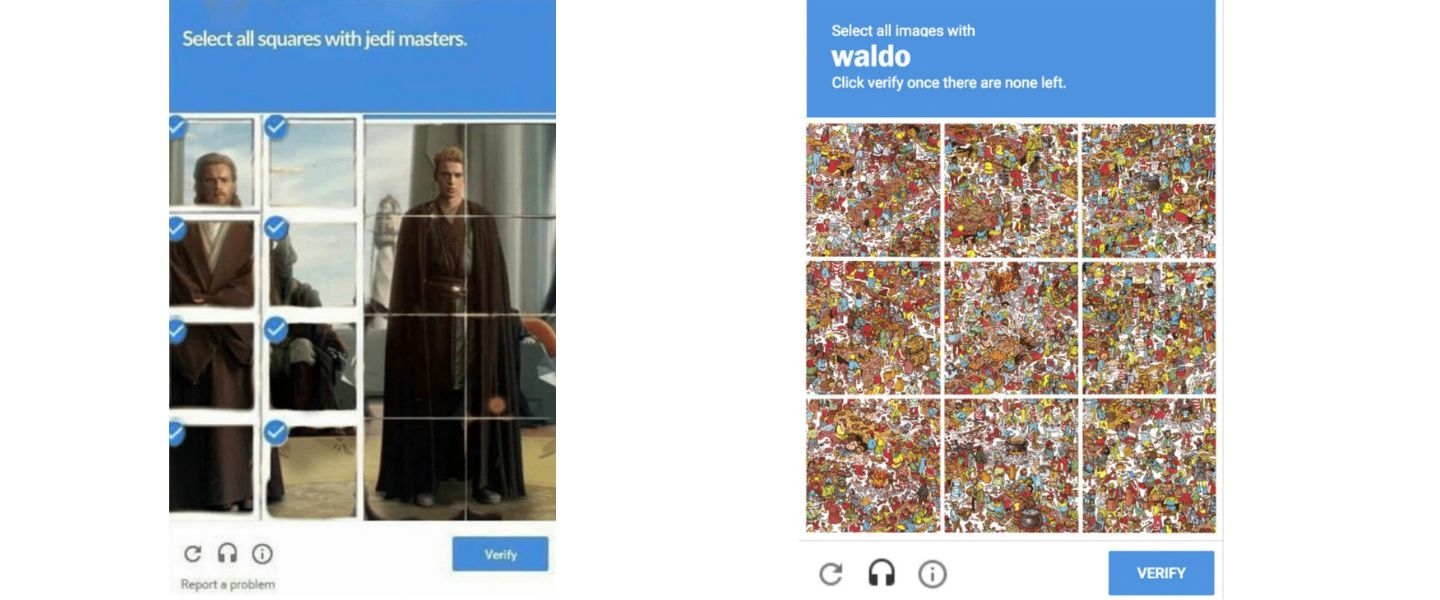
Y, por supuesto, están las cuadrículas de fotos completamente fabricadas. Para esta versión, los creadores de memes generalmente insultan a alguien (por ejemplo, una petición de maestro Jedi que excluye a Anakin) o exageran la dificultad de los reCAPTCHA (por ejemplo, una petición de ¿Dónde está Wally?).
¿Qué harán los reCAPTCHA a continuación?
Ahora que estos bloqueadores de bots han preservado más de un siglo de archivos del NYT y millones de libros, ¿qué les queda por lograr?
Dado que Google reCAPTCHA es la solución preferida, es probable que Google siga utilizándolos para sus propios fines, como entrenar el aprendizaje automático y analizar el comportamiento del usuario.
Si eso te desanima, tal vez te ayude saber qué pasó con el creador original de CAPTCHA. ¿Recuerdas a Luis von Ahn de la Universidad Carnegie Mellon? Tomó lo que aprendió sobre cómo cumplir dos objetivos a la vez y cofundó la aplicación de aprendizaje de idiomas Duolingo.
A Luis le apasionaba ofrecer una opción gratuita, así que en los primeros años (antes de recibir más financiación) mantuvo el negocio utilizando aspectos de la aplicación como servicio de traducción, muy parecido al modelo inicial de CAPTCHA y transcripción.
Y no nos olvidemos de los memes. Sin importar cómo se utilice esta tecnología, nadie puede impedir que la gente de internet cree y disfrute de los memes de reCAPTCHA.

Empieza gratis
Crea sitios web personalizados y escalables, sin escribir código. Empieza a construir en Webflow.